
REINVENT4
MolecularAI/REINVENT4加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
REINVENT 4 是阿斯利康(Molecular AI 团队)开源的生成式小分子设计引擎:用强化学习(RL)、迁移学习(TL)和课程学习驱动 RNN / Transformer 序列模型,把「想要一个分子」翻译成「优化一个多组分打分函数」,自动生成满足目标性质的候选分子。
想象一个真实的药物化学团队场景:手上有一个苗头化合物(hit),活性只有微摩尔级,溶解度很差,且带着一个不理想的警示结构(PAINS)。传统做法是化学家坐在画板前一格格改结构、改 linker、调取代基,一轮合成周期下来两三个月,还可能整条路线作废。
而分子设计领域真正缺的不是「能生成分子」的模型——那玩意儿 2017 年 GAN 时代就有了——而是能把生成和打分闭环起来的工程系统。你必须同时回答两个问题:怎么让模型生成化学上合法的分子?怎么让「更好」变成一个可计算、可微、可优化的标量?REINVENT 4 正是把这两件事打包成一套可配置的生产级流水线。
这也解释了它的出身:它不是学术组发完论文就撒手的 demo,而是阿斯利康内部药物发现项目正在生产环境跑的工具的开源版本。论文原文写得很直白——「the software is also being used in production to support in-house drug discovery projects」。
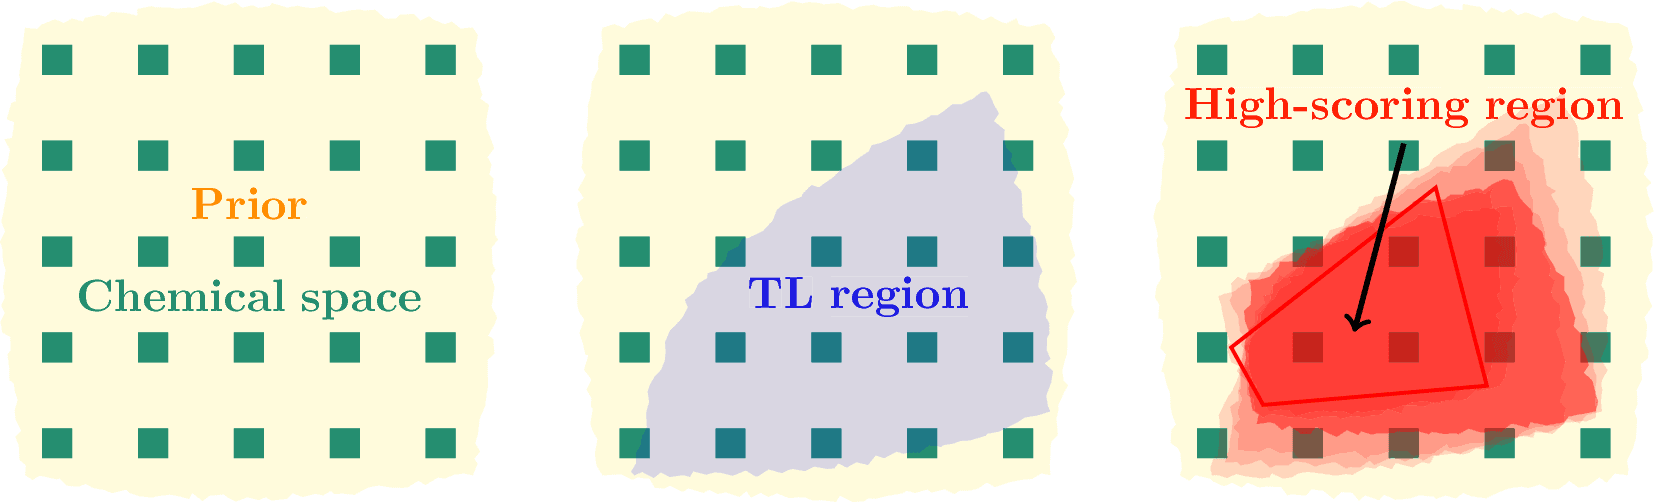
图:论文 Figure 1。先验模型(绿)覆盖全类药样分子空间,迁移学习把概率质量拉向特定区域(蓝),强化学习再在此基础上向高分区域(红)持续集中——这就是「生成式分子设计」最核心的直觉。
REINVENT 4 的功能边界由两个维度交叉定义,这是理解它的关键。
五类分子生成器(Generator):
Reinvent(RNN/LSTM):从零开始的 de novo 设计,逐 token 生成 SMILES 序列;
Libinvent:给定带连接点的骨架(scaffold),用 R 基团装饰,最多支持 4 个连接点,可直接用于 AI 辅助的化合物库设计;
Linkinvent:给定两个 warhead(药效团片段),生成中间的 linker——碎片连接与骨架跳跃都靠它;
Mol2Mol:给定一个分子,在相似度约束内找到性质更优的替代分子,实现分子优化;
PepInvent:Transformer 驱动的多肽序列生成。
五种运行模式(Run Mode):
staged_learning(分阶段/课程学习)、transfer_learning(迁移学习微调)、reinforcement_learning(RL 优化)、sampling(仅采样生成)、scoring(仅批量打分评估)。关键设计在于全部生成器与全部运行模式完全解耦:通过统一的 ModelAdapter 适配层,任何生成器都能跑在任何模式下。RNN 系走 training 模式以便回传梯度,Transformer 系走 inference 模式但依然可被优化框架调度。
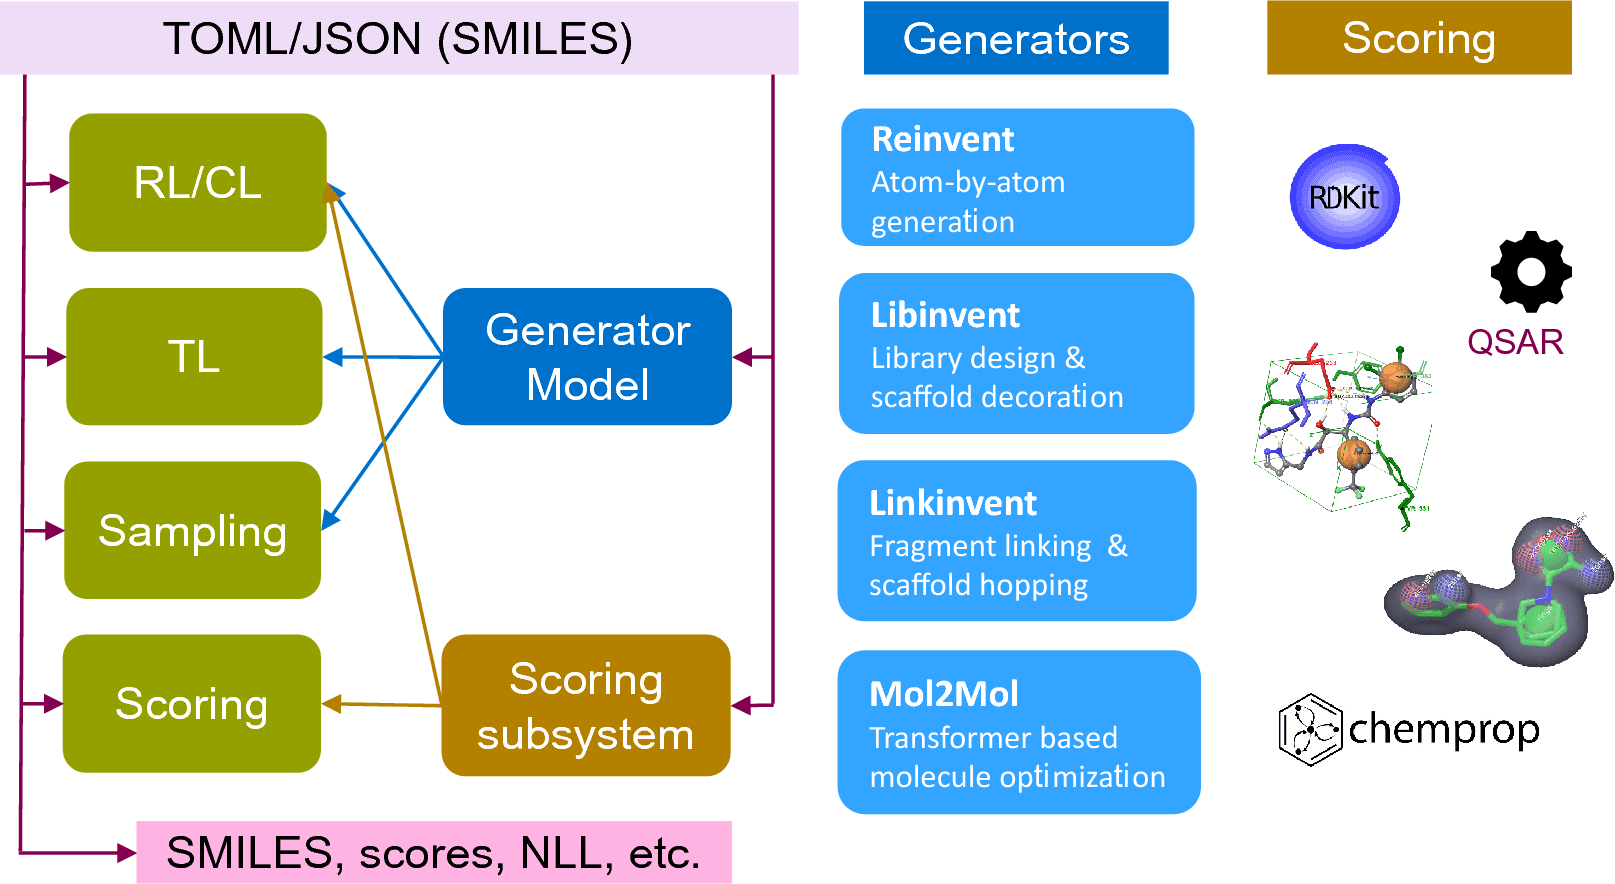
图:论文 Figure 3,所有运行模式的信息流。配置(TOML/JSON/YAML)→ 采样 → 打分子系统 → 奖励计算(DAP / MAULI / MASCOF)→ 策略梯度更新 Agent,同时写入 TensorBoard。
这是整个工具最见功力的地方。评分分三层:Filter(产生 0/1 掩码,如结构警示、反应过滤)、Scorer(真正被优化的目标,如 QED、SlogP、SA Score)、Penalty(聚合后的乘性惩罚项)。多目标通过几何平均或算术平均聚合。
内置组件覆盖 RDKit 全套描述符(QED、TPSA、可旋转键数、Csp3 比例等 20 余项)、SAScore、ROCSSimilarity、匹配分子对(MMP)、以及 ChemProp D-MPNN 神经网络打分。外部集成包括 DockStream(分子对接)、Maize 工作流、Qptuna(QSAR)、Icolos 任务编排。扩展方式是纯 Python 插件协议:把 comp_*.py 放进 reinvent_plugins/components/ 命名空间目录,加 @add_tag 装饰器即可,完全不需要改动 REINVENT 本体代码。
生成分子最怕「一万个 SMILES 其实是一万个化学等价物」。v4.9 把原先单一的 DiversityFilter 重构成可插拔的 memories/filters/ 包,提供 IdenticalMurckoScaffold、IdenticalTopologicalScaffold、ScaffoldSimilarity、PenalizeSameSmiles、BitBirch 五种过滤器,惩罚函数可选 Step/Linear/Tanh/Sigmoid/Erf 形状。同一版本还引入了 RND(随机网络蒸馏)和 Information-based 内在奖励,可挂到过滤器上主动探索。
TensorBoard 输出 Diversity/、Inception/ 等命名空间标量,CSV 日志结构稳定,支持远端 JSON 上报(remote reporter),配合 Handler 上下文管理器做 checkpoint 的保存/恢复与 SIGTERM 优雅退出。--seed 保证采样可复现。
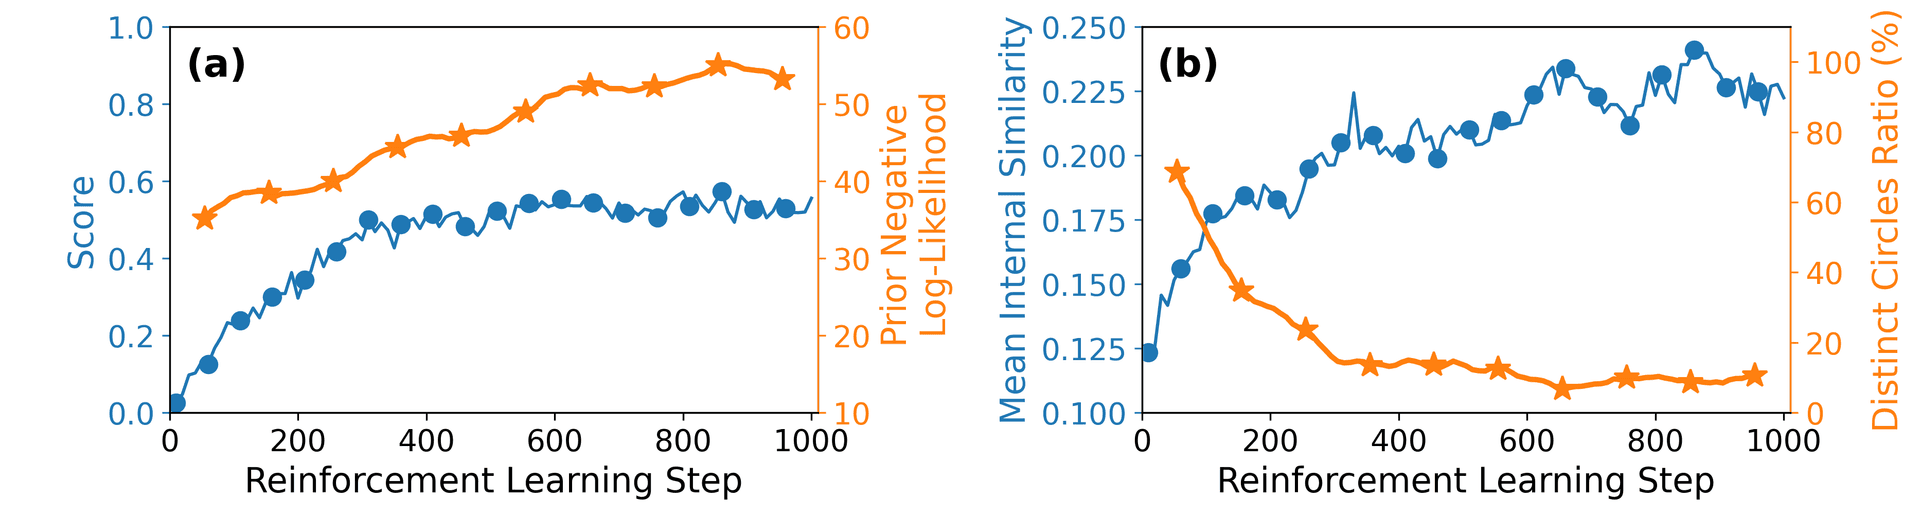
图:仓库内 contrib 文档的优化流程配图。
这是纯命令行工具,没有任何 Web UI。 典型调用就一行:
reinvent -l sampling.log sampling.toml
安装提供两条路:conda + python install.py cu126(按 CUDA/ROCm/XPU/MPS 选择),或实验性的 uv sync。核心依赖包括 PyTorch 2.13、RDKit 2025.09+、TensorBoard、NumPy 2 / pandas 3 / polars、pydantic 2。
门槛判断:
算法门槛高:要真正用起来,必须理解 SMILES 记号、分子描述符、打分函数设计、RL 奖励机制。这不是「装完就能跑」的玩具。
环境门槛中:Linux 完整验证,Windows 支持有限,macOS 受限。依赖较重(torch + rdkit),国内拉 PyTorch 镜像需处理网络问题。
前置模型门槛高:RL 模式需要先下载公开先验模型(Zenodo, DOI 10.5281/zenodo.15641296)并用 prior_registry 的点号记法引用;TL 模式需要自己准备训练集 SMILES 并跑 reinvent_datapre 预处理。
上手友好度:文档意外地好。仓库内有 configs/ 下全部运行模式的示例 TOML、每个配置文件对应的 *.md 说明文档、notebooks/ 里的 jupytext 轻量脚本,以及 contrib/reinvent-doc/ 里完整的 Sphinx 教程站源码(RL/TL/sampling/scoring 四篇教程 + 监控指南)。
强依赖闭源工具链:部分高价值打分能力需要 OpenEye 商业授权(pip install reinvent[openeye]),尽管存在免费替代方案,但对企业内网部署是额外成本。
加速器生态仍需工程投入:AMD 官方的 ROCm 博客明确写道 REINVENT4 在 MI300X 上「开箱即跑、无需改代码」,但同一篇也承认要进一步提速需手动开启 AMP 并调 batch size——所谓「开箱即用」是在框架抽象层的意义上有条件的。
版本迭代激进:4.x 与 3.x 配置格式不兼容,v4.9(2026-11-06)刚刚重构了多样性过滤器的内部架构并修复了 Inception 重复写入过滤器状态导致多样性惩罚过强的 bug。活跃度高是好事,但也意味着踩坑时容易搜到旧版文档。
「生成分子 ≠ 可合成分子」:SAScore 只是启发式近似,合成可达性需要额外的逆合成规划工具配合。工具产出的候选最终仍要过化学家这一关。
评分函数即目标函数:多目标聚合的几何平均会惩罚极端值,单一奖励黑客(reward hacking)在自定义 scoring component 下并不罕见——这恰恰是它坚持插件化、把打分逻辑交给用户的原因,也是风险所在。
REINVENT 4 代表了生成式分子设计从「论文玩具」走向「药企基础设施」的转折点。它的参考价值甚至可能高于它在具体项目中的直接使用价值:论文在 Journal of Cheminformatics 以开放获取发表,把 RL、TL、课程学习、多样性过滤、内在奖励、打分插件化这一整套现代做法放在一份可读的代码 + 一套完整文档里,对学术界是极好的教科书,对工业界是可直接落地的起点。
从社区数据看:截至 2026 年 11 月,项目累计约 900 star、240 fork,仓库 3500+ 文件、620+ Python 源文件、229 个测试文件,累计提交 370+ 次,最近一次推送就在分析当天(2026-11-06),发布节奏保持月度级别。从 2023 年 10 月首次公开算起,三年持续维护且没有停止迹象——在工业级科研软件里,这属于相当健康的长生命周期。
阿斯利康还把它跑在 AMD MI300X 上做生命科学 AI 负载优化,说明它已经进入真实的大规模算力基础设施讨论,而不只是「开源项目列表里的一个 star 数」。
