
ProLLM
MingyuJ666/ProLLM加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
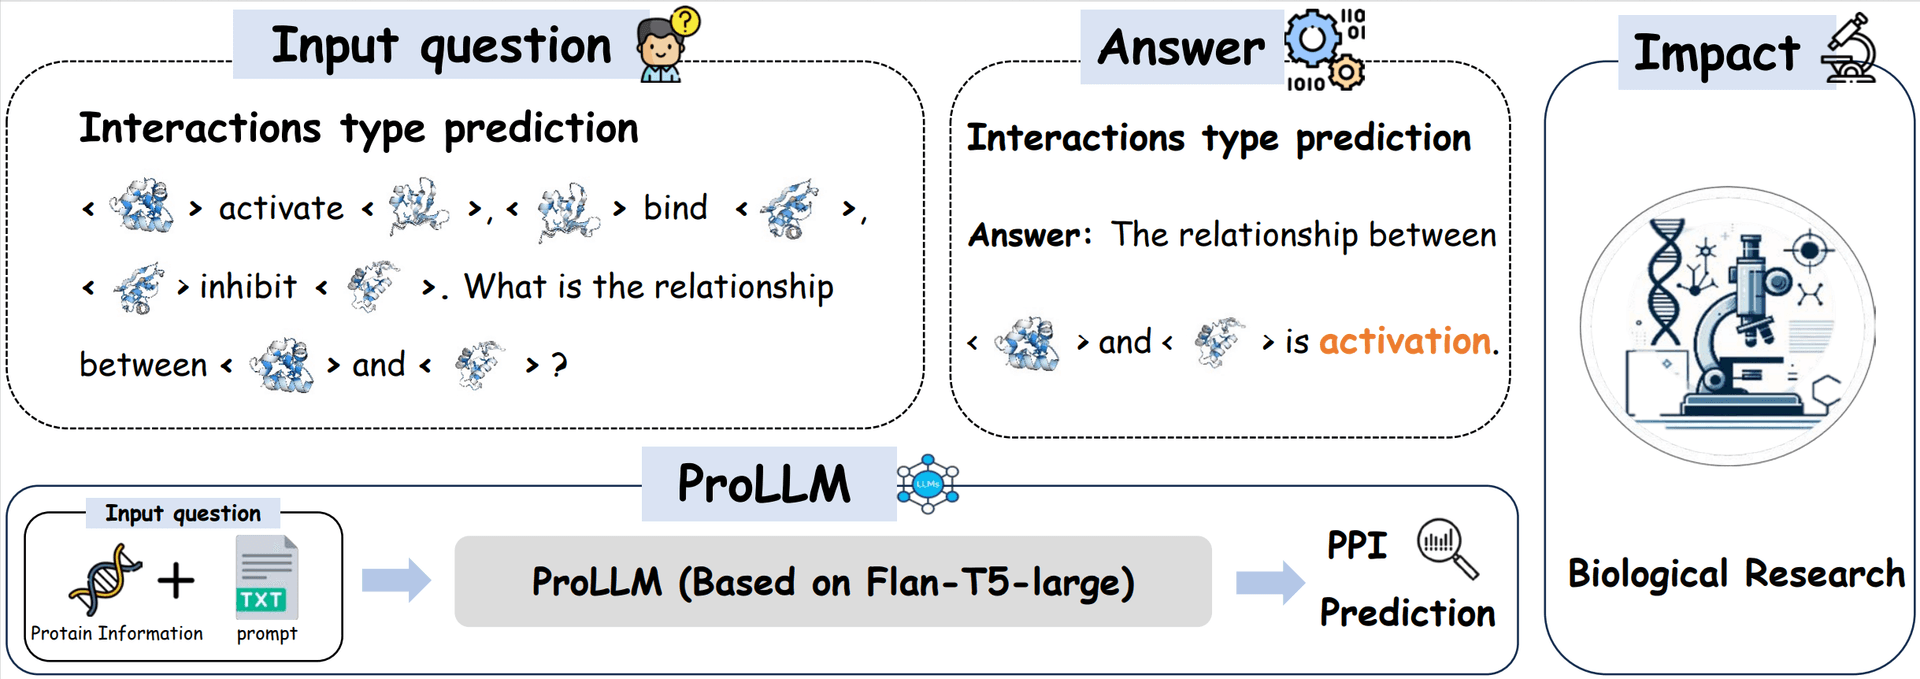
图1:ProLLM 框架核心原理——将蛋白质信号通路转化为 Chain-of-Thought 提示词
想象一下:你身体里的每一个细胞,就像一座繁忙的城市。城市中十万计的「居民」——蛋白质,无时无刻不在相互「打电话」「发微信」,传递着维持生命的信号。这些信号通路一旦出错,就可能引发癌症、阿尔茨海默病、糖尿病等重大疾病。
传统方法怎么研究蛋白质相互作用(Protein-Protein Interaction, PPI)?生物学家往往依赖昂贵的实验(酵母双杂交、免疫共沉淀),一次只能验证几十对蛋白质。面对人体超过 650,000 种潜在蛋白质相互作用对,这种「一个一个来」的方式效率极低。
ProLLM 的出现,像是为 AI 装上了一副「生物语」耳机。 它让大语言模型能够「听懂」蛋白质说的话——把蛋白质序列翻译成自然语言,再用 Chain-of-Thought(思维链)的方式,模拟信号通路的传递逻辑,预测任意两个蛋白质是否会「通话」。
ProLLM 全称 Protein Chain-of-Thoughts Enhanced LLM,由 MingyuJ666 团队开发,于 2024 年被国际机器学习顶级会议 COLM 2024 正式接收,arXiv 论文地址:https://arxiv.org/abs/2405.06649。
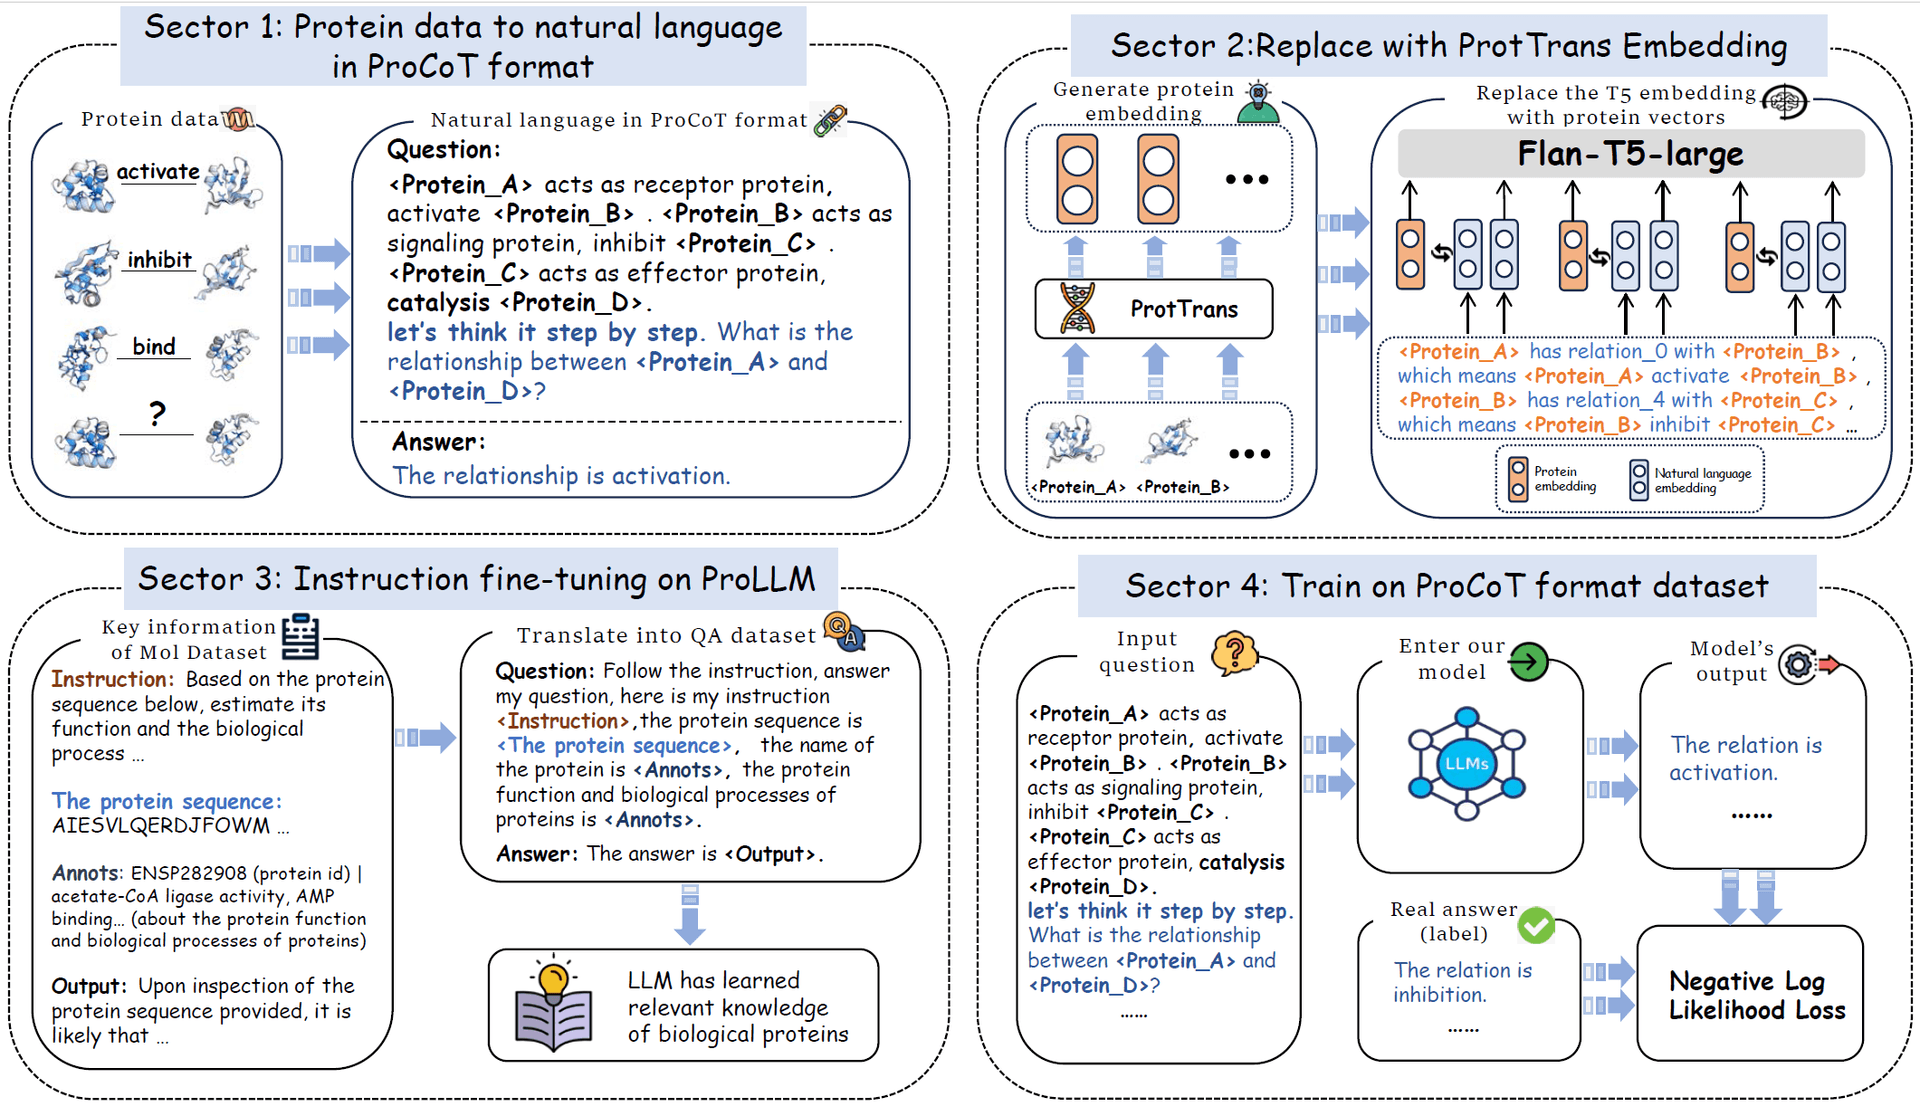
图2:ProLLM 完整工作流程
项目的核心创新是 ProCoT(Protein Chain of Thought)方法——受神经生物学中信号通路的级联放大效应启发,将蛋白质相互作用预测重新建模为链式推理过程:上游蛋白 → 若干中间蛋白 → 下游蛋白,就像多米诺骨牌一样有序传递。
普通的 PPI 预测模型通常输出一个简单的「是/否」或概率值。ProLLM 的思路不同:它让 LLM 先「思考」——给定一对待预测的蛋白质,模型会生成一段自然语言推理链,解释这对蛋白可能通过哪些中间蛋白建立联系,最终给出预测结论。
这种 Chain-of-Thought 方式的好处在于:
ProLLM 基于 FLAN-T5(Google 开源的指令微调 T5 模型)进行开发。核心训练流程:
蛋白质序列 → 自然语言嵌入 → Chain-of-Thought 推理 → PPI 预测
技术栈包括:
input_text(蛋白质序列经 ProCoT 模板化后的自然语言描述)和 output_text(预测结果)ProLLM 在四个标准 PPI 数据集上训练和评估:
预处理脚本将原始蛋白质相互作用数据转换为 ProCoT 格式的 CSV 文件,每个样本的 input_text 形如:
"Given protein A (sequence: MKFL...), protein B (sequence: MALL...), identify the signaling pathway. Starting from protein A, it passes through intermediate protein(s) X, finally reaching protein B. Is there an interaction?"
output_text 则是对应的「是/否」标签或中间蛋白推理链。
# 安装依赖
pip install -r requirements.txt

# 下载数据集(Google Drive)
# 下载 SHS27K / SHS148K / STRING / Human 数据集

# 数据预处理:生成 ProCoT 格式
python data_preprocess/SHS27K/preprocess.py

# 执行嵌入替换(需提前用 ESM2 生成 embedding)
python embedding_replacement/embedding_replacement.py

# 微调 FLAN-T5
python train_ProLLM.py \
    --model_dir /path/to/FLAN-T5 \
    --data_file SHS27K_train_10.csv \
    --num_epochs 3 \
    --batch_size 2 \
    --learning_rate 3e-4 \
    --output_dir ./output
python eva.py \
    --model_path /path/to/trained_model \
    --test_df /path/to/test_data.csv
推理使用 T5ForConditionalGeneration,配置 num_beams=5 束搜索和 max_new_tokens=1500 的生成长度上限。
适合谁: 有机器学习背景的生物信息学研究者和 NLP 工程师。需要一定的 Python 能力,熟悉 PyTorch 和 HuggingFace 生态。
主要局限:
ProLLM 是 LLM for Science 趋势的一个典型案例——将通用语言模型的推理能力迁移到生物科学领域。它证明了大模型不仅能「写文章」,还能「做生物实验规划」。
从更宏观的角度看,ProLLM 代表了一个新兴方向:用自然语言作为分子生物学的「中间表示层」。蛋白质序列→自然语言→LLM推理→预测结果,这套 pipeline 为多模态生物 AI 提供了新思路。
作者在 COLM 2024 的论文中报告了对比基线的显著提升,相关代码和数据完全开源,期待更多研究者在此基础上探索蛋白质语言模型的潜力。
本报告基于 GitHub 仓库 v1.0(2024-03-14 创建,2025-11-23 最后更新)生成。
