
mesh-llm
Mesh-LLM/mesh-llm加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
一个反常识的现象:家用 GPU 早就不是瓶颈,模型比显卡大才是。跑一个 70B 量化模型要 40GB 显存,单卡装不下;两张卡凑起来又割裂了推理上下文;而买张 H100 装在自己机柜里,做的是同一件事。
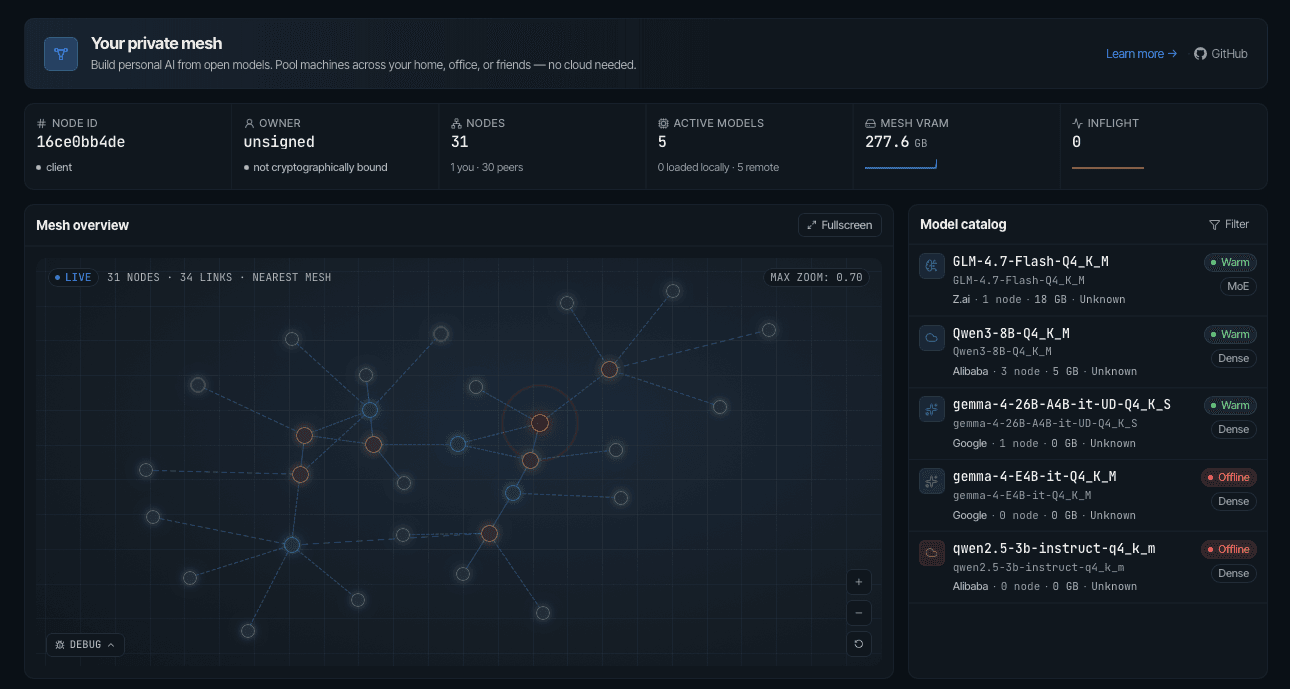
Mesh LLM 的答案是:把若干台机器的 GPU 与内存池化起来,对外只暴露一个 OpenAI 兼容端点 http://localhost:9337/v1。请求按 model 字段路由到能扛下该模型的节点;模型太大时用 Skippy 的 stage split 把它按连续层区间切片,各节点只加载自己那段。Apache-2.0,3,763 星、482 fork、41 位贡献者,2026 年 2 月立项至今不到一年。
仓库结构本身就是设计说明:
skippy/)负责模型管理、原生推理、切分执行和 OpenAI 服务mesh/)负责节点发现、传输、路由、插件和控制台两者共享一个根 Cargo workspace 和 lockfile(Cargo.lock 281KB),各 crate 自带 README。这不是目录洁癖——它把「本地推理引擎」和「去中心化网络」两个复杂度完全不同的关注点解耦了,skippy 可以单独用,mesh 只是套在上面的编排层。
README 把这个顺序写得很明确,「Single-machine fit first」:如果一个节点能装下完整模型,它就在本地服务,根本不产生 stage 流量。网络只在必要时才介入。这避免了分布式推理最常见的退化——为了分布式而分布式。
它还提供了一条明确的调试旁路 --local-model-only:直接把 OpenAI 前端接到单个本地 Skippy 运行时,不启动 QUIC、发现、peer 维护、切分规划、插件和控制台。README 特别警告这不是生产路径(不含 tool call 支持的 host-runtime normalizer),且 --model <catalog-name> 在此模式下无效、错误信息不直观。这份诚实度在开源项目里不常见。
mesh-llm-control/2 通道,需要显式 endpoint bootstrap;而公开网格的加入、gossip、路由和推理留在公开平面上,为的是混版本兼容。这个切分很务实——控制面需要强身份,推理面需要互通。大稠密模型按连续层区间切成多个 stage。协调器规划层区间后,先启动下游 stage、等待就绪、然后才发布 stage-0 路由——这个顺序保证了首包不会被黑洞掉。
更巧的是 Layer Package:模型包仓库不存整模型,而是存 model-package.json 加 GGUF 分片,节点只拉取自己那段的碎片。对 DeepSeek3、EXAONE-MoE 这类整体 GGUF 太大的模型,包式 stage 是唯一可行路径。
支持矩阵也写得相当严谨:72 个 P0/P1 家族行已评审、完整 parity 清单 89 行认证,覆盖 Qwen、Llama、Gemma、Mistral、DeepSeek、GLM、MiniMax、Phi、Granite、Hunyuan、EXAONE、Cohere、Falcon、RWKV 等;切分多模态认证覆盖 Qwen2-VL、Qwen3-VL、Qwen3-VL-MoE、HunyuanOCR/Hunyuan-VL、DeepSeek-OCR,用真实 GGUF 加 projector fixture 验证。
model: "mesh" 会把一个 prompt 并行扇出到网格中所有模型,然后用确定性代码仲裁响应,只有真正冲突时才升级给一个 reducer LLM。仲裁逻辑跑在代码里,不是又一次模型调用。
README 顶部就挂着 ⚠️ Experimental 标签,写明「路由启发式、错误形态、调优旋钮可能在小版本间变化,建议当作预览特性,语义需要稳定时请用具体模型 id」。这种自我标注在开源项目里很罕见——大多数同类项目会直接宣传为旗舰功能。
Mesh-LLM/ds4-plugin:DwarfStar 引擎,跑 DeepSeek V4 等 ds4 模型,Apple Silicon 优化mesh-llm plugins install 安装,也支持 [[plugin]] 配置段mesh-llm goose、mesh-llm opencode、mesh-llm claude、mesh-llm pi——直接把网格挂到现成的编码代理上,配合 docs/AGENTS.md 的 blackboard 机制。
一条命令:
curl -fsSL https://raw.githubusercontent.com/Mesh-LLM/mesh-llm/main/install.sh | bash
Windows 用 install.ps1(27KB)、macOS 有 Homebrew formula。源码构建需要 just、cmake、Rust、sccache、平台快速链接器(Linux 用 mold,macOS/Windows 用 lld)、Node.js 24 + npm。
发布产物矩阵相当完整:macOS bundle、Linux CPU / ARM64 CPU / ARM64 CUDA / CUDA / CUDA Blackwell / ROCm / Vulkan、Windows CPU / CUDA / ROCm / Vulkan。CUDA 运行时需 nvcc,ROCm 需 ROCm/HIP,Vulkan 需 glslc。Metal 仅 macOS。便携归档可离线运行:host 会先在相邻的 native-runtimes/<runtime-id> 目录里找运行时,再查用户缓存。
发布可执行文件带嵌入式 release attestation,用于来源证明和准入加固。验证方式:
cargo run -p xtask -- release-attestation inspect --binary <path> --public-key-file <release-signing-public-key.json>
打戳的发布二进制报 valid,未打戳的本地或 dev 构建报 missing,打包后被改动报 invalid。README 明确划了边界:attestation 不适用于 SDK、XCFramework 等原生制品,也不是运行时完整性证明;下载后被篡改会把 valid 翻成 invalid,但默认启动仍允许它通过。
这是诚实的——它说了能保证什么、不能保证什么。
项目太新,迭代极快。 2026 年 2 月创建,到 11 月已是 179 个 open issue。README 里的「Notable Updates」时间线几乎每周都在变,某些配置项和 CLI 开关会在小版本间调整。生产部署要锁版本。
原生 Windows 支持有缺口。 原生 Windows 只有 CUDA 12 运行时、只构建到 SM 90,所以 RTX 50 系(Blackwell SM 120)在原生 Windows 上还没有可用运行时,需要走 WSL2 + Linux CUDA 13。mesh-llm.exe 也未做代码签名,SmartScreen 可能拦截。
WSL2 多节点部署相当繁琐。 README 自己给了完整的 WSL2 路径:要装 CUDA 13.0 Toolkit、配 .wslconfig 的 networkingMode=mirrored、还要改 Hyper-V 虚拟机防火墙(Set-NetFirewallHyperVVMSetting 默认入站是 Block,尤其装了第三方安全软件时)并加 Defender 防火墙规则放行 3131/9337/5353。另外多节点要本地读 GGUF 分片的话,各节点 --gguf 路径字符串必须完全一致(或用 bind mount / 符号链接),否则会走网络流式传输几十 GB。
硬件门槛分化极大。 纯本地小模型(Qwen3-8B-Q4)CPU 可跑;但要实现「网格切分大模型」的卖点,没有多台带显存的机器就没有意义。CPU 节点在网格里基本只能当控制面。
部分功能是「预告」而非可用。 MoA 网关明确标注实验性;--local-model-only 不是生产路径;插件生态只有两个插件,生态本身仍在起步。
公共网格有信任与成本问题。 加入公开网格意味着推理请求会路由到陌生节点,虽然 QUIC 端到端加密保证了不被读取,但延迟、可用性和带宽都受他人影响。
分布式推理这个赛道 2026 年拥挤(Exo、Petals、vLLM Ray 集群、各类 P2P 推理网),Mesh LLM 的差异不在「我们也能跨机器」,而在三件事:
一,它把 llama.cpp 的兼容矩阵当成产品资产来做。 72 个 P0/P1 家族行 + 89 行认证清单、真实 GGUF fixture 的多模态切分认证、wire dtype 和 cache 策略矩阵——这份工作枯燥但决定了这东西能不能真跑,而不是只能 demo。
二,它把「单机优先」写进架构。 很多分布式推理项目默认「必须联网」,把本地路径当降级方案。Mesh LLM 反过来,先问本机能不能装下,装不下才走切分。这个判断直接决定了日常使用体验。
三,控制面与推理面分离。 用独立通道做运维、公开平面做推理,为混版本兼容留了活路。这是分布式系统里被反复证明的架构判断。
对做私有化 AI 基础设施的团队,它的价值在于提供了一个能真跑生产模型的 OpenAI 兼容端点:有 GPU 就能贡献算力,没有 GPU 也能作为客户端接进来,接口完全兼容意味着上层业务代码一行都不用改。
mesh-llm serve --local-model-only --gguf /abs/path/model.gguf --port 9337,确认本机能力边界(启动时若模型装不下会直接失败,不会自动回退到分布式)mesh-llm serve --model Qwen3-8B-Q4_K_M 起私网;需要公开发布加 --publish;被邀请加 --join <token>--headless,只保留管理 API--model hf://meshllm/<repo>@<rev> --split,并确认各节点层包与路径一致release-attestation inspect --binary <path> --public-key-file <key.json>,别只看文件名Apache-2.0,Rust 为主,4,578 个 .rs 文件、42 个 mesh crate 加 Skippy 的运行时 crate,1,573 个 Rust 测试文件。一个能在笔记本上跑小模型、也能在机房集群里拼大模型的统一端点。
