
matryca-plumber
MarcoPorcellato/matryca-plumber加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有过这样的经历——深夜让 Claude 帮你整理笔记,结果第二天起床发现:笔记格式全乱了、精心维护的 [[双向链接]] 消失了一半、凌晨三点的思绪被一段"优化后"的文字覆盖。那一刻的崩溃感,经历过的人都懂。
意大利开发者 Marco Porcellato 就是这个故事的亲历者。2024 年,他在使用 AI 辅助管理 Logseq 笔记时遭遇了数据损坏。这次惨痛经历促使他决定打造一个"让 AI 安全读写笔记"的工具——Matryca Plumber 诞生了。
这个项目直接受启发于 Andrej Karpathy 的 LLM-Wiki 理念:不把笔记当作普通文本文件,而是让 AI 能够精确理解笔记的语义结构,在不破坏原有格式的前提下完成增删改查。从 2024 年诞生到 2025 年,Matryca Plumber 已成为 Logseq 生态中最重要的 AI Agent 基础设施之一。
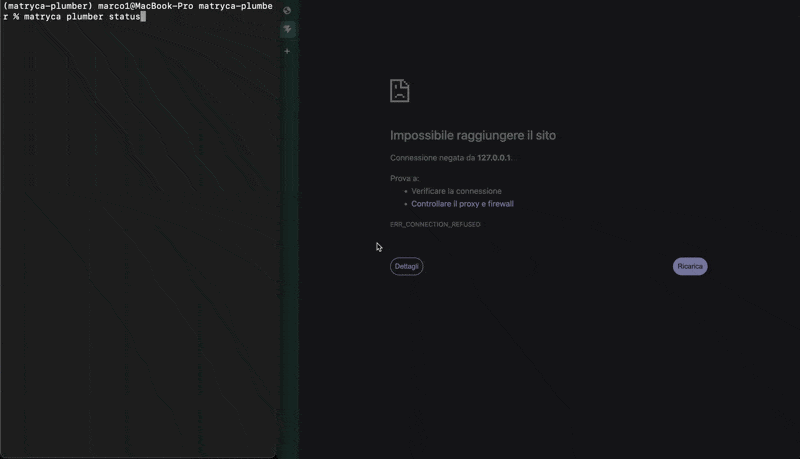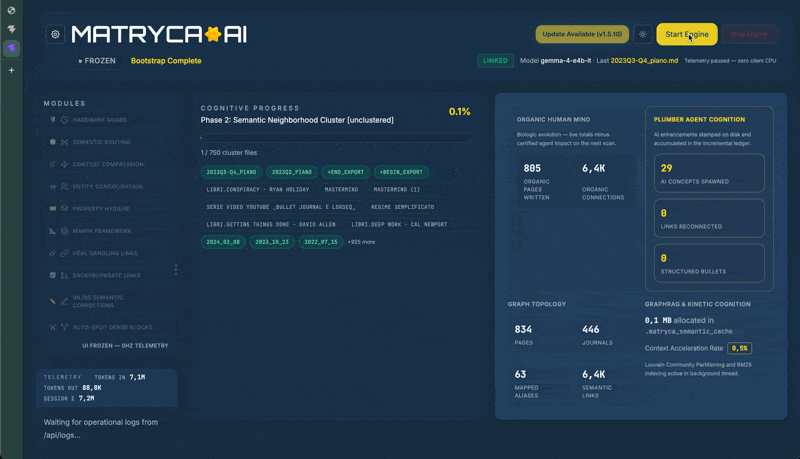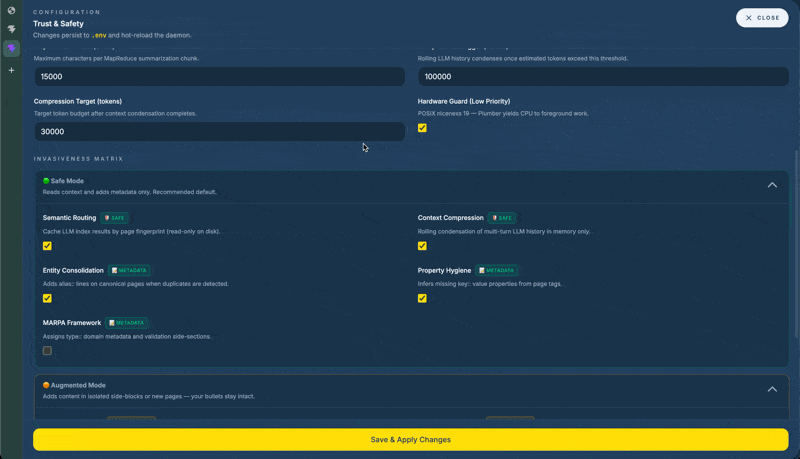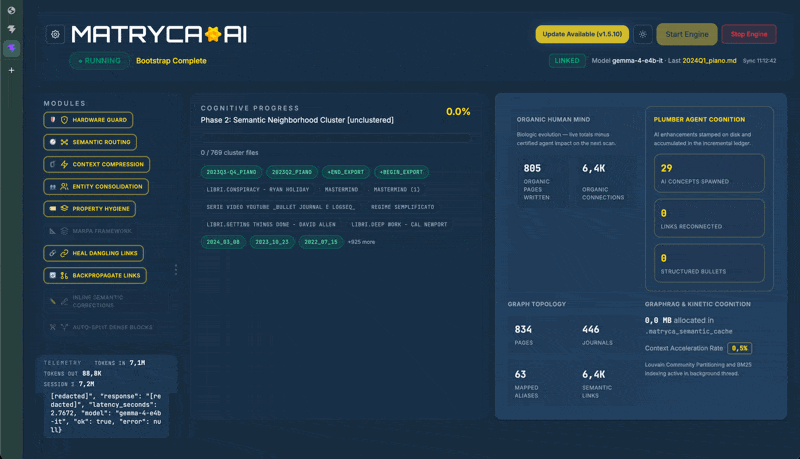
Matryca Plumber 运行演示:背景索引 + Sovereign UI 仪表板
Matryca Plumber 定位非常清晰——为 AI Agent 和 Logseq 大纲笔记之间搭建一座安全桥梁。
这里的"Logseq OG"特指 Logseq 的原始 Markdown 格式,而非数据库存储模式。在 Logseq OG 模式下,所有笔记都是磁盘上的 .md 文件,通过 id:: 属性、缩进层级、[[双向链接]] 等约定构成知识图谱。这种设计的优势是数据完全自主可控,劣势是普通 AI Agent 很难在不破坏格式的前提下正确编辑。
Matryca Plumber 的核心价值就是解决这个矛盾。
项目提供三种使用方式,适应不同场景:
matryca read、matryca import 等子命令提供结构化访问这三种模式共享同一套解析引擎和语义索引,保证行为一致性。
项目采用 Clean Architecture(清晰架构) 组织代码,核心目录包括:
src/agent/ — AI Agent 交互层,处理 MCP 协议和指令路由src/daemon/ — 后台守护进程,调度语义索引和链接修复任务src/graph/ — 图谱层,负责 Logseq Markdown 的 AST 解析和块树构建src/rag/ — RAG(检索增强生成)相关组件src/semantic/ — 语义索引,基于本地 SQLite (FTS5) 实现全文搜索src/shadow/ — Shadow DB 缓存层(v2.0 RC 特性),加速大规模知识库的读取src/memory/ — 记忆管理,支撑 Agent 的上下文持久化这是 Matryca Plumber 最核心的技术创新,体现在两个层面:
第一层:OCC(乐观并发控制)
每次 AI Agent 准备写入文件时,Matryca Plumber 先记录文件的 st_mtime(最后修改时间)作为快照。当 AI 推理完成、准备写入时,再次检查文件的 st_mtime。如果在你等待 AI 推理期间,你本人编辑了文件,st_mtime 会发生变化,写入操作会被中止。你的输入永远优先于 AI 的输出。
第二层:L0 写安全(Tier-1 提示架构)
通过精心设计的 prompt 架构,引导 LLM 生成的 diff 不会删除 id:: 行或编辑受保护区域(如 frontmatter)。配合 graph/safety/validators.py 中的验证器,对写入内容进行结构化检查,从源头防止 AI 破坏笔记的内部链接关系。
v2.0 RC 引入了 Shadow DB 功能,这是一个位于 Logseq 图谱外部的 SQLite 缓存数据库。它使用 FTS5 BM25 算法对块树进行全文索引,并通过递归 CTE 遍历子树结构。Shadow DB 的核心价值在于:当你的知识库规模达到数千个页面时,每次全量索引会非常耗时,Shadow DB 通过缓存解析结果将重建时间从数分钟缩短到数秒。
Shadow DB 有一个巧妙的设计:超过解析预算的页面会被隔离(quarantine)而非崩溃。默认 15 秒超时,如果某个页面解析超时,它会被暂停隔离,剩余图谱继续缓存,下一次尝试时自动重新解析。根据作者的实际测试,1,014 个页面的知识库中,仅 3 个页面(0.30%)触发了隔离机制。
项目支持 pip / uvx 两种安装方式,Python 版本要求 ≥ 3.12。安装本身非常简洁:
uvx matryca-plumber --help
# 或
pip install matryca-plumber
安装后需要配置两个核心环境变量:
LOGSEQ_GRAPH_PATH:指向你的 Logseq 图谱目录MATRYCA_LLM_API_KEY:LLM API 密钥(支持 OpenAI 兼容接口,也支持本地 LM Studio/Ollama)项目提供了一个基于浏览器访问的本地仪表板(默认 http://localhost:8500),显示系统健康状态、信任层级、实时遥测数据,以及配置面板。这解决了 CLI 工具对新手不友好的问题——即使不熟悉命令行,也能通过图形界面完成基础配置。
v1.11.0 加入了 Tana → Logseq OG 迁移 功能。Tana 是另一个流行的知识管理工具,Matryca Plumber 可以将 Tana 导出的 JSON 文件批量导入 Logseq 图谱,自动处理 supertag、calendar 节点、嵌套层级等映射关系。迁移过程默认是"干运行"(dry-run),确保用户确认后才会实际写入文件。
| 维度 | 评估 |
|---|---|
| 容器化 | ❌ 无 Dockerfile/docker-compose,需手动安装 |
| 依赖复杂度 | 中等,25+ 依赖,通过 pyproject.toml 管理,uv 工具链安装便捷 |
| 环境配置 | 需要配置多个环境变量(LLM API、图谱路径等),有一定门槛 |
| 硬件需求 | 4GB+ RAM,无强制 GPU,但用本地 LLM 建议 8GB+ 显存 |
| Web UI | 无浏览器 UI,通过本地 API(:8501)和 Sovereign UI(:8500)提供访问 |
| 快速部署 | ⚠️ 部分支持,pip 安装简单,但环境变量配置较繁琐 |
总体评价:部署难度中等。pip 安装本身无障碍,但配置 LLM API、Logseq 图谱路径、Ollama/LM Studio 等需要一定技术理解能力。无容器化支持,对于追求环境隔离的用户不够友好。
.logseq/db.graphql),限制了一部分用户群体Matryca Plumber 代表的不仅仅是一个工具,更是一种理念:AI Agent 不应该只能读,更应该被允许安全地写。
在 LLM-Wiki 的愿景中,AI 不是外部的问答机器,而是融入个人知识管理流程的智能协作者。要实现这个愿景,必须解决 AI 在结构化数据上的写操作安全问题。Matryca Plumber 用 OCC + AST 解析 + FTS5 索引的组合,给出了一个相当优雅的答案。
从增长曲线看,随着 Logseq 用户群体扩大、AI Agent 普及度提升,这类基础设施型工具的需求会持续增长。项目的 Apache-2.0 许可也为商业集成敞开了大门。
# 方式1:pip 安装
pip install matryca-plumber

# 方式2:uvx 即时运行
uvx matryca-plumber --help

# 配置环境变量
export LOGSEQ_GRAPH_PATH=/path/to/your/logseq/graph
export MATRYCA_LLM_API_KEY=sk-...

# 启动 MCP 服务器(供 Cursor/Claude Desktop 使用)
matryca mcp

# 或启动后台守护进程(持续索引和维护)
matryca daemon

# 访问本地仪表板
# http://localhost:8500
项目封面:Logseq + LLM Wiki 架构概览
