
Ultra-Light-Fast-Generic-Face-Detector-1MB
Linzaer/Ultra-Light-Fast-Generic-Face-Detector-1MB加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
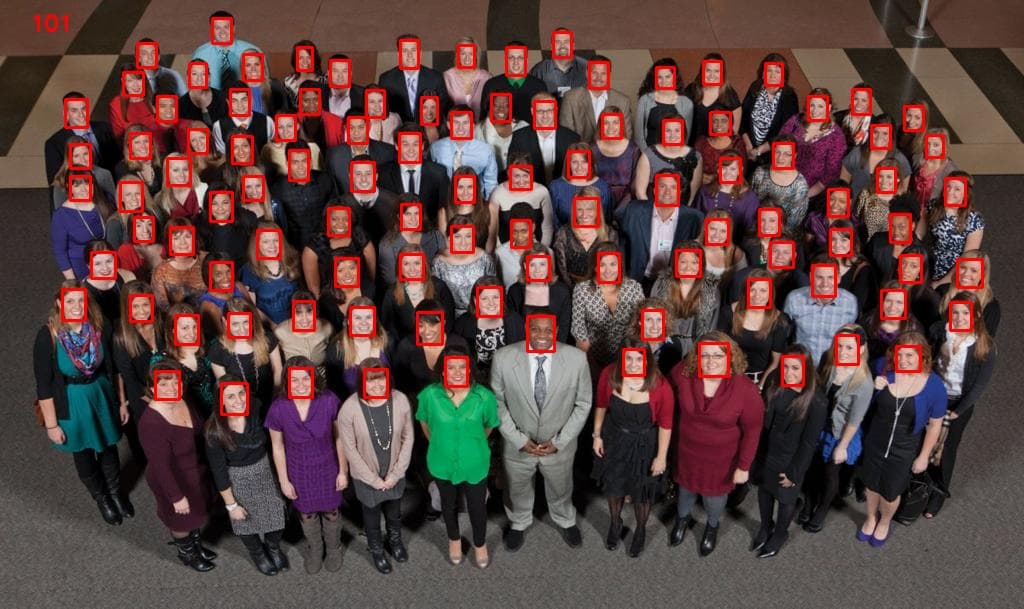
图:320×240 输入分辨率下的实时检测效果,模型体积仅 1MB 出头
假设你要在一家社区诊所门口装一台人脸抓拍摄像机,用来记录进出人流做统计。采购预算有限,设备是一台百元级树莓派 4B,没有 GPU,只有一个便宜得不能再便宜的 USB 摄像头。这时候你面前有两条路:调用云端人脸识别 API,或者在本地跑一个模型。
云端 API 的问题很直接——数据出网,隐私合规过不去;网络抖动时识别率断崖,弱网门诊高峰期直接罢工;按调用量计费的账单在半年后成了一笔糊涂账。
本地跑模型呢?主流方案如 RetinaFace-Mobilenet-0.25 虽然精度不错,但 1.68MB 的模型文件在树莓派上单核推理要 46 毫秒,多人同框的大场面根本扛不住。
2019 年 10 月,一个叫 Linzaer 的中国开发者把这条路走通了:把模型压到 1.04MB,树莓派 4B 上四核并行只要 9.5 毫秒,精度却比 libfacedetection 高出一大截。这个仓库就是那次实践的完整遗产——UltraFace,一度是中文圈边缘 AI 圈子里最常被翻出来抄的"人脸检测模型"。
核心是一次网络结构瘦身手术。作者以 libfacedetection 为起点(一个经典 Caffe 人脸检测器,精度中庸但极快),保留其 SSD 风格的检测框架,把骨干网络替换成轻量化设计,并引入改进的 RFB(Receptive Field Block) 模块来扩大感受野。RFB 版本精度更高,slim 版本牺牲一点精度换取速度。
训练数据用的是 WIDER FACE 数据集配合 RetinaFace 清洗过的标注,转成 VOC 格式自建训练管线(train.py + 两个 shell 脚本分别对应 slim / RFB 两条路线)。
模型产物覆盖了你能想到的所有部署形态:
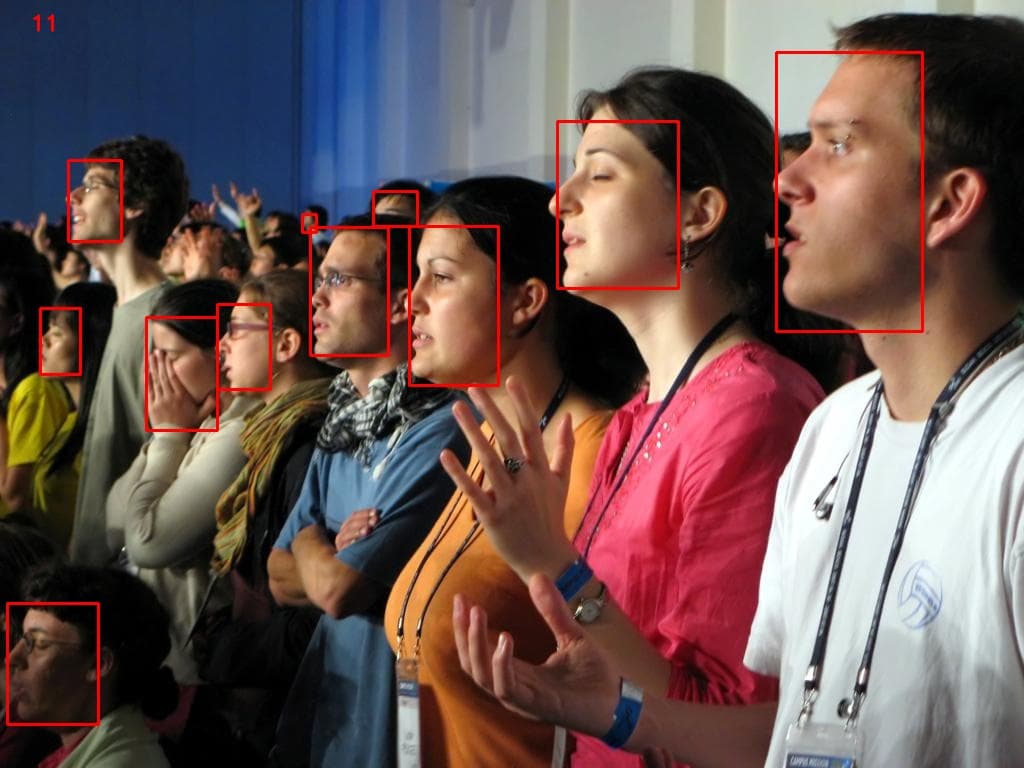
图:slim 与 RFB 两条产品线的模型文件体积与网络结构差异
convert_to_onnx.py 转换脚本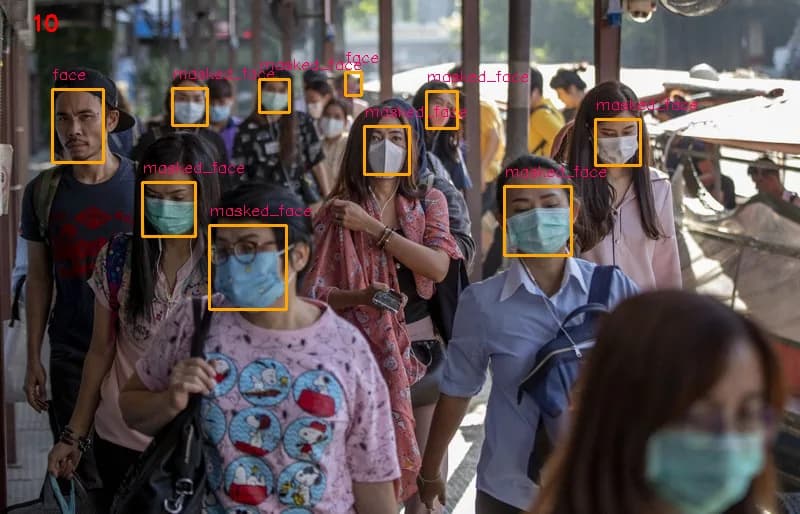
图:仓库扩展出的 masked_face 子项目——在遮挡场景下的人脸检测
另外还附赠一个 masked_face 子项目,针对戴口罩/遮挡人脸的检测做了专门训练,这在 2020 年疫情期间意外成了项目热度第二波来源。
在 WIDER FACE 验证集上,320×240 输入下:
| 模型 | Easy | Medium | Hard | 体积 |
|---|---|---|---|---|
| libfacedetection v2 | 0.714 | 0.585 | 0.306 | 3.34MB |
| RetinaFace-Mobilenet-0.25 | 0.745 | 0.553 | 0.232 | 1.68MB |
| version-slim | 0.770 | 0.671 | 0.395 | 1.04MB |
| version-RFB | 0.787 | 0.698 | 0.438 | 1.11MB |
关键在 Hard 这一列——RFB 版本 0.438,比 libfacedetection 高出 43%,这才是小脸、侧脸、模糊脸场景真正拉开差距的地方。计算量方面,320×240 输入下约 90~109 MFlops,INT8 量化后模型仅约 300KB。
在树莓派 4B 上用 MNN + int8 量化,四核推理延迟 9.511 毫秒;在 iPhone 6s Plus 上 MNN 单次推理 6.337.8 毫秒;连 Kendryte K210 这种 400MHz 的 RISC-V MCU 芯片都能跑到 65.6 毫秒(slim 版)。这个成绩单在 2019 年是相当能打的。
这是需要清醒认识的地方。
没有 Dockerfile,没有 docker-compose,没有 Web UI。 它是一个模型 + 一堆推理脚本的研究型仓库,不是开箱即用的产品。想跑起来你得自己配环境:Python 3.6、PyTorch 1.2、CUDA 10.0 + cuDNN 7.6(README 里写的是当年 Ubuntu 16.04/18.04 + Windows 10 的测试环境),这些依赖版本在今天都相当陈旧。
没有 CI、没有单元测试。 requirements.txt 里列着 torch、torchvision、torchstat、torchsummary、ptflops 这类训练侧依赖——纯推理用户根本装不完这一套。而且 detect_imgs_onnx.py 里还混入了 from caffe2.python.onnx import backend 这种只有装 caffe2 才能跑通的导入,在推理脚本里保留 caffe2 依赖是个明显的历史遗留问题。
接口是脚本式的。 没有 pip install 后 from ultralight import detect 这样的干净 API,模型路径、阈值(默认 0.7)、输入尺寸都是硬编码在脚本里的常量,要改成函数调用得自己封装。
官方仓库已停止更新。 最后一次提交是 2023 年 12 月,README 里的运行环境还停留在 PyTorch 1.2 时代。社区里有活跃的 fork(例如 clibdev/Ultra-Light-Fast-Generic-Face-Detector-1MB)把兼容性升级到了 PyTorch ≥ 2.4,修正了若干 ONNX 转换报错,并提供预训练模型的 SHA-256 校验——如果你今天要上新项目,建议直接用 fork 而不是原仓库。
值得的地方:它是"边缘 AI 小模型"这条路线早期最有说服力的样本之一,证明了一个 1MB 的模型在真实终端设备上可以做到可用精度。多后端(NCNN/MNN/TFLite/Caffe)的完整支持在当时几乎是独一份,对做嵌入式 AI 的工程师来说是极高价值的参考资料库。MIT 协议,代码可以随便用。
不值得的地方:它不是一个可以"部署"的服务,是一个可以"读懂并复用"的模型。把它当产品直接上生产,你会踩到环境依赖、脚本耦合、缺乏测试、文档停留在三年前的这一连串坑。它更适合的角色是:拿它的网络结构设计思路、拿它的多端部署经验,或者直接拿它的预训练权重去做你自己的下游任务。
从 2019 年到今天,人脸检测的竞争重心已经从"能不能在端侧跑"变成了"跑得多准、多快、多小"。MobileNet、YOLO 系列人脸检测、无锚点检测器一路演进,把轻量化人脸检测的精度天花板推得越来越高,UltraFace 的精度数字如今已经不算惊艳。
但它的方法论从未过时:先锚定一个极致的约束条件(1MB),再倒推结构设计与部署矩阵。这种"约束驱动的工程取舍"思路,和今天 TinyML 社区推崇的 NAS + 量化流水线殊途同归。在一个具体的小模型案例上,UltraFace 至今仍被大量教程、课程和项目当作入门参考。
7500 星、1550 次 fork、130 个未关闭 issue——这个数字组合说明了一件事:它已经完成了自己的历史使命,成了这个领域的一块公共基础设施。
