
Light-Science
Light0305/Light-Science加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:Light Skills 项目 Logo(MIT 协议开源,23 个技能)
凌晨两点,博士生小林终于"用 AI"写完了论文引言的初稿。他把 PDF 投给了导师。三天后导师只回了一句话:"第 42 行的这条引用,我检索不到。"
小林不是不努力。他用了 ChatGPT,用了 Claude,甚至把整篇稿子反复润色了四遍。但他从头到尾没有做过三件事:查证引用、核对图表与正文的数据是否一致、在写之前确认自己要回答的科学问题是什么。
这就是 Light Skills 想解决的那一类问题。它的官方定位是"面向科研、竞赛与创新项目的 AI 全流程技能包"——不是让 AI 更聪明,而是让 AI 的产出可以被检查、被回退、被人类接手。


如果把 Light Skills 类比成实验室的 SOP(标准作业程序),它更接近"带审计功能的 SOP"而不是"万能助手"。仓库 skills/ 目录下有 23 个技能,README 里把它们划成七条主线:
light-file-reading 读论文、PDF、PPT、表格、图片,产出结构化理解笔记;light-project-structure 搭建可复现的目录规范light-literature-search 做检索策略与证据地图,light-idea-critique 专门找"最强反例"和"审稿人攻击点"light-research-plan 把想法拆成实验矩阵、预注册草案、失败树light-data-engineering 查数据泄漏,light-experiment-coding 写可复现实验代码light-figure 程序化出图,light-paper-writing 写作,light-citation 核引用,light-consistency 跨材料一致性,light-typesetting LaTeX 排版light-venue-matching 选期刊,light-review-rebuttal 写审稿回复,light-patent-disclosure 整理专利交底light-frontend-design 与 light-system-design 做竞赛 demo 和系统架构最值得注意的是它的自我约束。light-orchestrator 的 SKILL.md 开头写着一串"不可协商边界":不替用户选研究方向、不替用户决定投稿、不因为文件存在就宣布交付完成。没有实测过的阶段只能标记为 PLANNED / UNKNOWN / UNAVAILABLE,绝不允许用散文(prose)声称某个 gate 通过。
这与传统"提示词工程"最大的区别是:Light Skills 把这些约束写成了机器可读的契约。
_shared/ 契约层是整个项目的骨架整个仓库 520 个文件、195 个 Python 文件、约 8 万行代码,但它的技术核心却集中在 _shared/ 目录的 2150 行里——这是七个跨技能共享的地基契约:
| 契约 | 解决的问题 |
|---|---|
light.findings.v1(findings_schema) | 统一 findings/gate 报告格式,支持 SARIF 导出 |
gate_runner | 把多个确定性检查聚合成一次总控确认 |
light.evidence_strength.v1 | 把证据强度映射为中英双语的措辞档位 |
light.status.v1 | 操作状态、覆盖缺口、结构化失败原因 |
light.decision.v1 | 选项、风险、授权范围与撤销状态 |
semantic_sim | 三档降级语义相似度,治"该用语义处全用词面 Jaccard" |
visual_qa | 几何检查 + WCAG 对比度 + 渲染回看 |
看代码风格能感受到作者的工程洁癖。semantic_sim.py 的注释直白地写明它要治的病是"该用语义处全用词面 Jaccard";visual_qa.py 治的病是"视觉技能从不回看"。_shared/__init__.py 里甚至给了一段推荐的 bootstrap 片段——向上遍历目录树找仓库根,避免硬编码 parents[N] 的脆弱性,并注明"三 harness + 全局/项目安装都可靠"。
依赖策略同样克制:_shared 纯标准库,无网络、无第三方包。跨技能脚本的 import 统计显示,sys / argparse / json / pathlib / re 占据前列,numpy、matplotlib、pandas、sklearn、torch 只在具体分析类技能里按需出现。
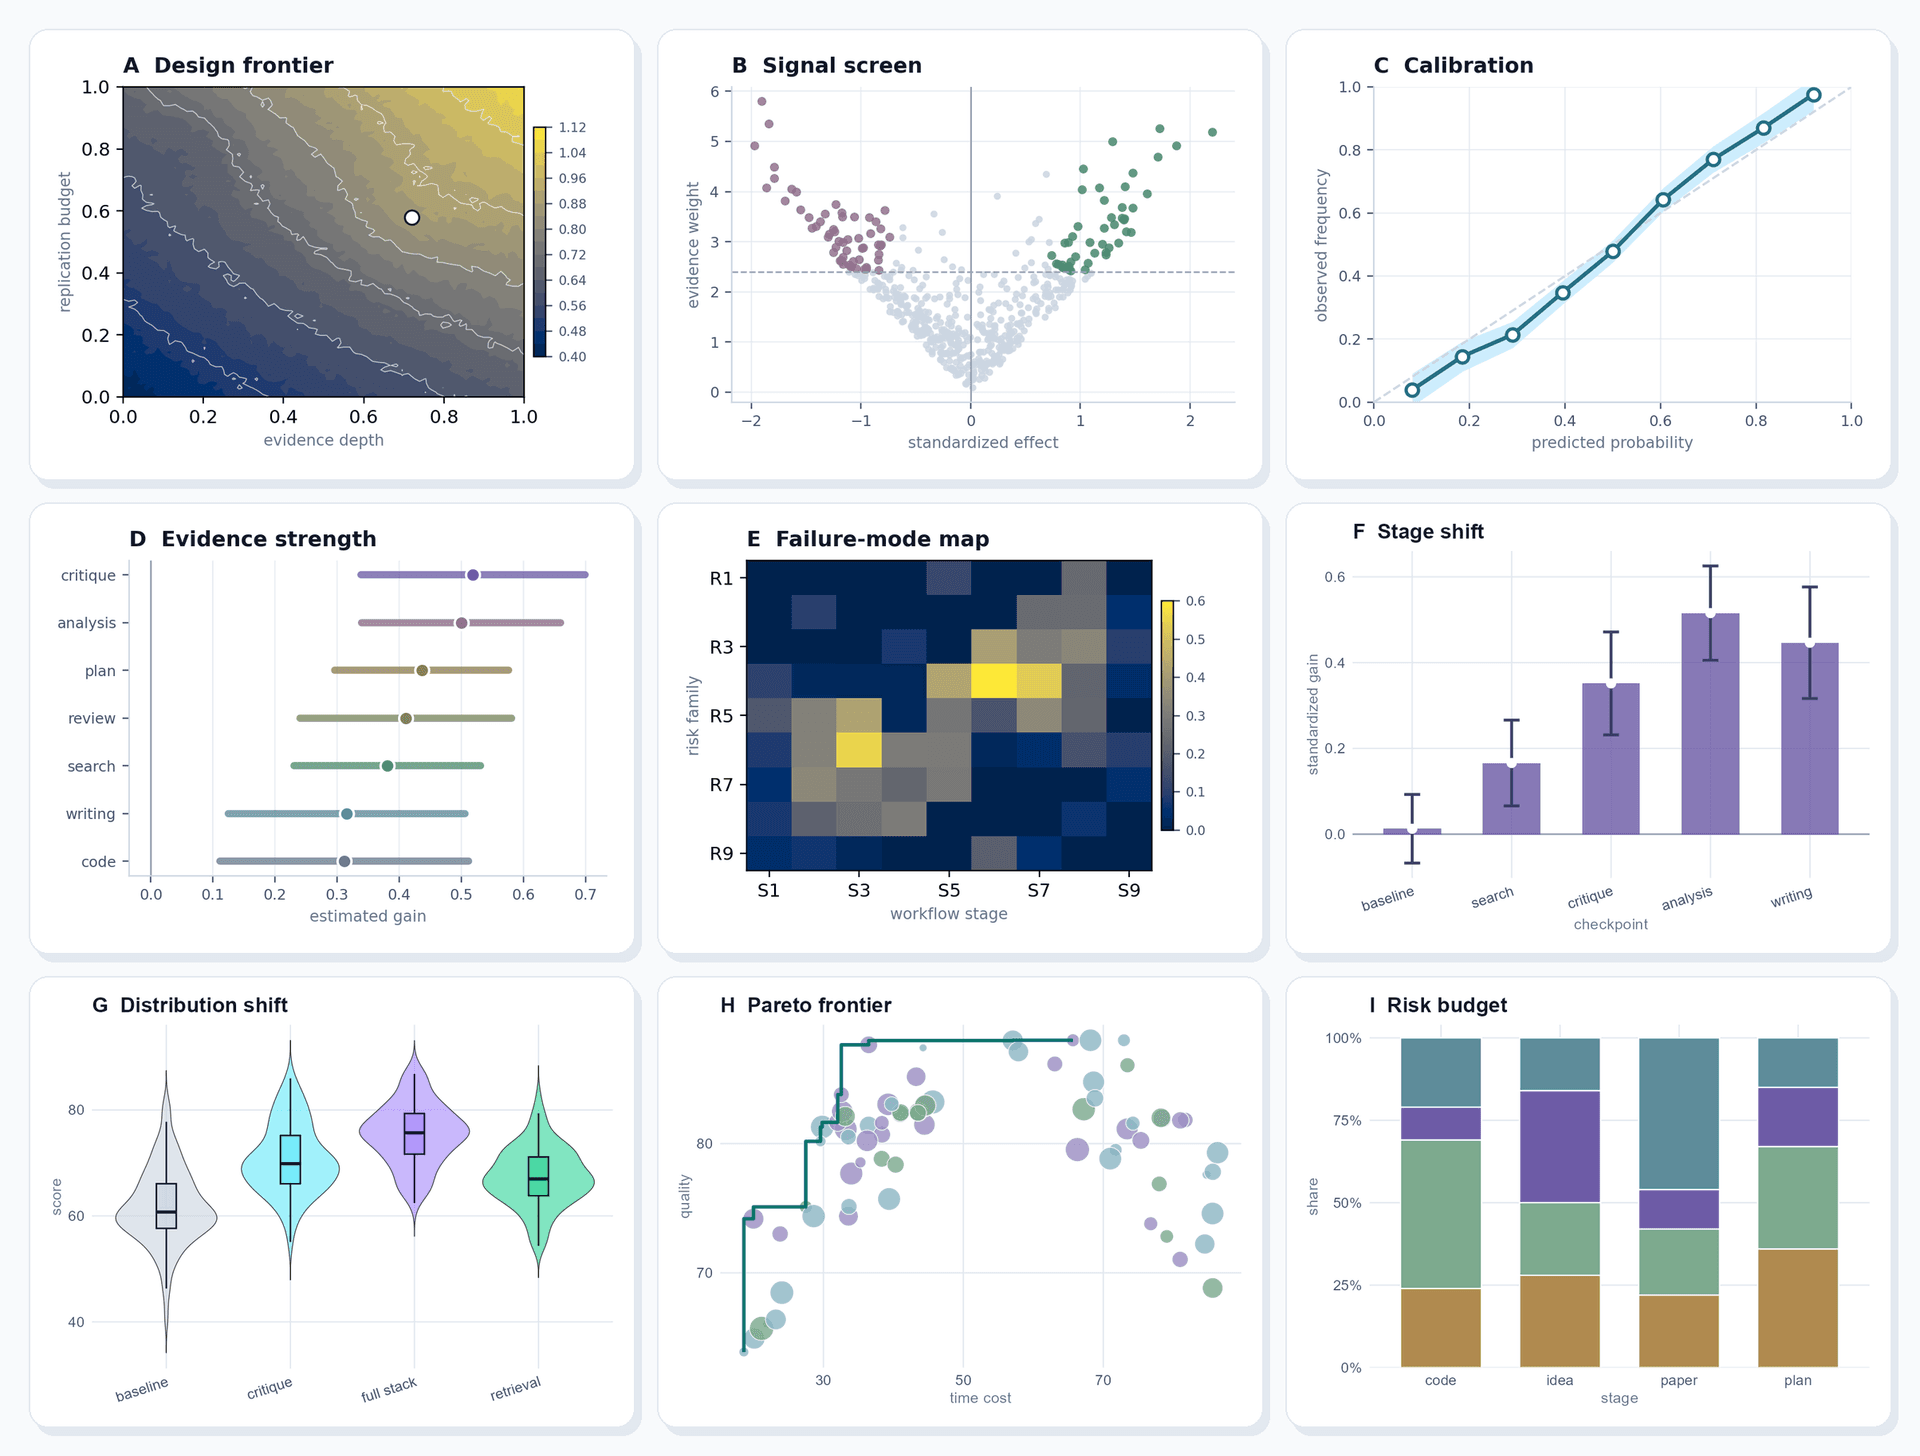
图:examples/e2e-research-demo 产出的程序化科研图(Python + R 双路径)
在 AI 辅助科研里,图表造假是一条真实的灰色地带。Light Skills 把这条线划得非常硬:light-figure 的定位里明确写着**"论文数据图程序化生成绝不 AI 生图"**,并要求每张图先回答"服务哪条 claim、删了缺什么"。
它还内置了"视觉诚实"检查项:不偷偷截断 y 轴、不用双 y 轴伪造相关性、不用 jet-rainbow 伪彩图。规格层面则要求出版级标准——栏宽、字号、色盲安全、误差棒加 n 值与显著性标记。
更值得注意的是降级策略:R/ggplot2 被定位为"增强路径,不是静默前提"。缺 R 或缺包时,技能不会自己 install.packages,而是把"继续用 matplotlib 诚实降级 / 安装或配置 R / 提供 Rscript 路径"三个选项交给用户,非交互自动流程默认降级并标记 degraded=True。不允许 AI 偷偷改动用户的运行环境——这条规矩和 AGENTS.md 里"不要静默安装或重配置本地运行时"是同一套价值观。
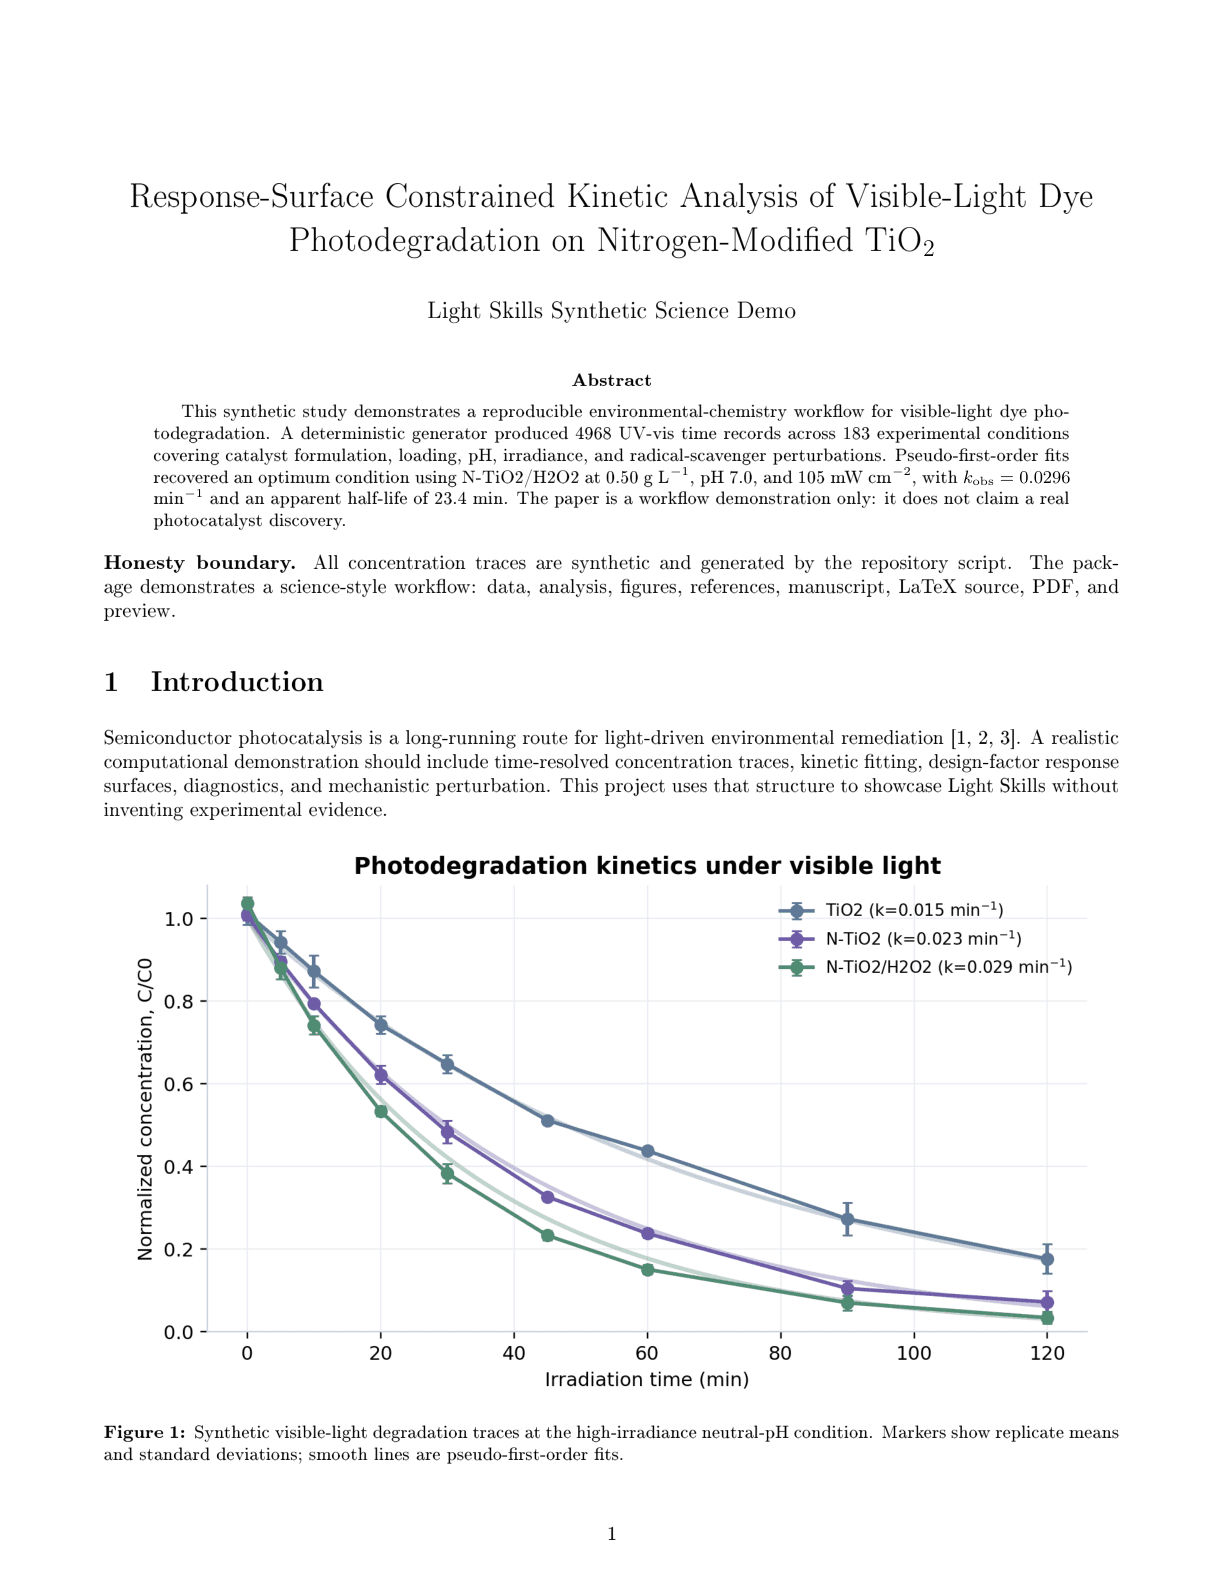
图:projects/photocatalytic-dye-kinetics-study 的可复现论文交付物(合成数据,环境化学方向)
light-typesetting 支持 latexmk、pdfLaTeX、XeLaTeX、LuaLaTeX、BibTeX、Biber,但它最值得称道的不是兼容列表,而是它对失败的态度:本机缺工具就标 UNAVAILABLE,不假装已经排版成功。仓库里还内置了一个完整论文 Demo——方向是环境化学/光催化动力学,从合成数据、分析、程序化图表一路做到 LaTeX PDF 的完整交付形态。
Light Skills 同时支持 Codex、Claude Code、OpenCode 三类 agent 客户端,三者的技能发现路径互不相同:
.agents/skills.claude/skills.opencode/skillsscripts/bootstrap_agent_skills.py 负责把这三者统一映射过去。更务实的一点是:Windows 无法创建目录 symlink 时,脚本回退为 copy,并写入 .light_generated_link 标记——这样脚本不会误覆盖用户自己的目录,修改 canonical skills/ 后重跑 --force 即可刷新。
诚实地说,这个项目有几处需要打折的地方:
1. 单人主导、提交历史极短。 GitHub API 显示仓库只有 1 位贡献者(Light0305,19 次提交),v1.0.0 于 2026-07-05 发布,此后 pushed_at 停在 2026-07-06。这是一份"一次性重构后公开"的作品,而非社区共建的项目。19 次提交里包含完整的历史,缺少持续迭代的痕迹。
2. 测试覆盖薄弱。 全仓库仅 6 个测试文件,且集中在 light-experiment-coding 的脚手架模板内(test_stats.py、test_reproducibility.py、test_experiment_contracts.py),核心 _shared 契约层没有单元测试,也没有 CI 配置(无 .github/workflows)。对于一个以"可审计、可验证"为核心卖点的项目,这是一处内在张力。
3. Windows 优先。 README 通篇使用 PowerShell 命令,$env:PYTHONUTF8="1" 是必需步骤。在 Linux/macOS 上需要自行换算。
4. 技能多≠上手容易。 23 个技能、66 份 references、上百个脚本,对新手是认知负担。README 提供了"从当前状态直接复制 prompt"的入口表,是必要的缓解,但依然需要理解阶段划分才能用好。
5. 边界声明值得肯定但也需注意。 v1.0.0 的 Release Notes 明确列出它不承诺的事:保证论文录用、保证专利/软著通过、自动产生真正的科学创新、无需检索即可获得已验证事实、不经核查的 DOI 与引用、用 AI 生图冒充科学图表。这份克制清单本身值得肯定——但在 AI 工具普遍过度承诺的环境里,也意味着它不会给你那种"一键出论文"的爽感。
2026 年上半年,AI 辅助科研工具出现了明显的分化:一类继续走"更强的通用模型 + 更长的上下文",另一类开始向流程工程转向——把学科方法论固化成 agent 可执行、可检查的工作流。
Light Skills 属于后者,而且做得相当彻底。它的 846 star 和 96 fork 相对于 2026-06-07 的创建时间不算低,说明"科研工作流标准化"这个需求确实存在。第三方目录 brycewang-stanford/Auto-Research-Skills 也把它收录进集合,说明在 agent skill 生态里已经有一定可见度。
它的真正价值可能不在于某一个技能有多惊艳,而在于它提出了一个具体的命题:AI 辅助科研的可信度,不取决于模型多强,而取决于流程有没有留下可审计的证据链。在这个意义上,Light Skills 更像是一份"科研 AI 工程化"的参考实现,而不只是一个工具包。
数据来源:GitHub API(仓库元数据、贡献者、发布记录)+ 仓库源码静态分析 + 项目 README/Release Notes/SECURITY.md。分析时间:2026-11-02。
