
reasoning-bank-slm
Lanerra/reasoning-bank-slm加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
「如果小模型也能记住自己是怎么解题的,会不会越做越好?」
这是开发者 Lanerra 在 2026 年初提出的一个核心问题。Google Research 于 2025 年 9 月发布了 ReasoningBank 框架,展示了大型语言模型(LLM)如何通过积累「解题记忆」实现自我进化。但 Google 的实验对象是 GPT-4 级别的大模型。那么,对于只有 17 亿参数的 Qwen3-1.7B——这个体量还不到 GPT-4 百分之一——记忆机制还能发挥作用吗?
ReasoningBank SLM 正是对这个问题的系统实验。
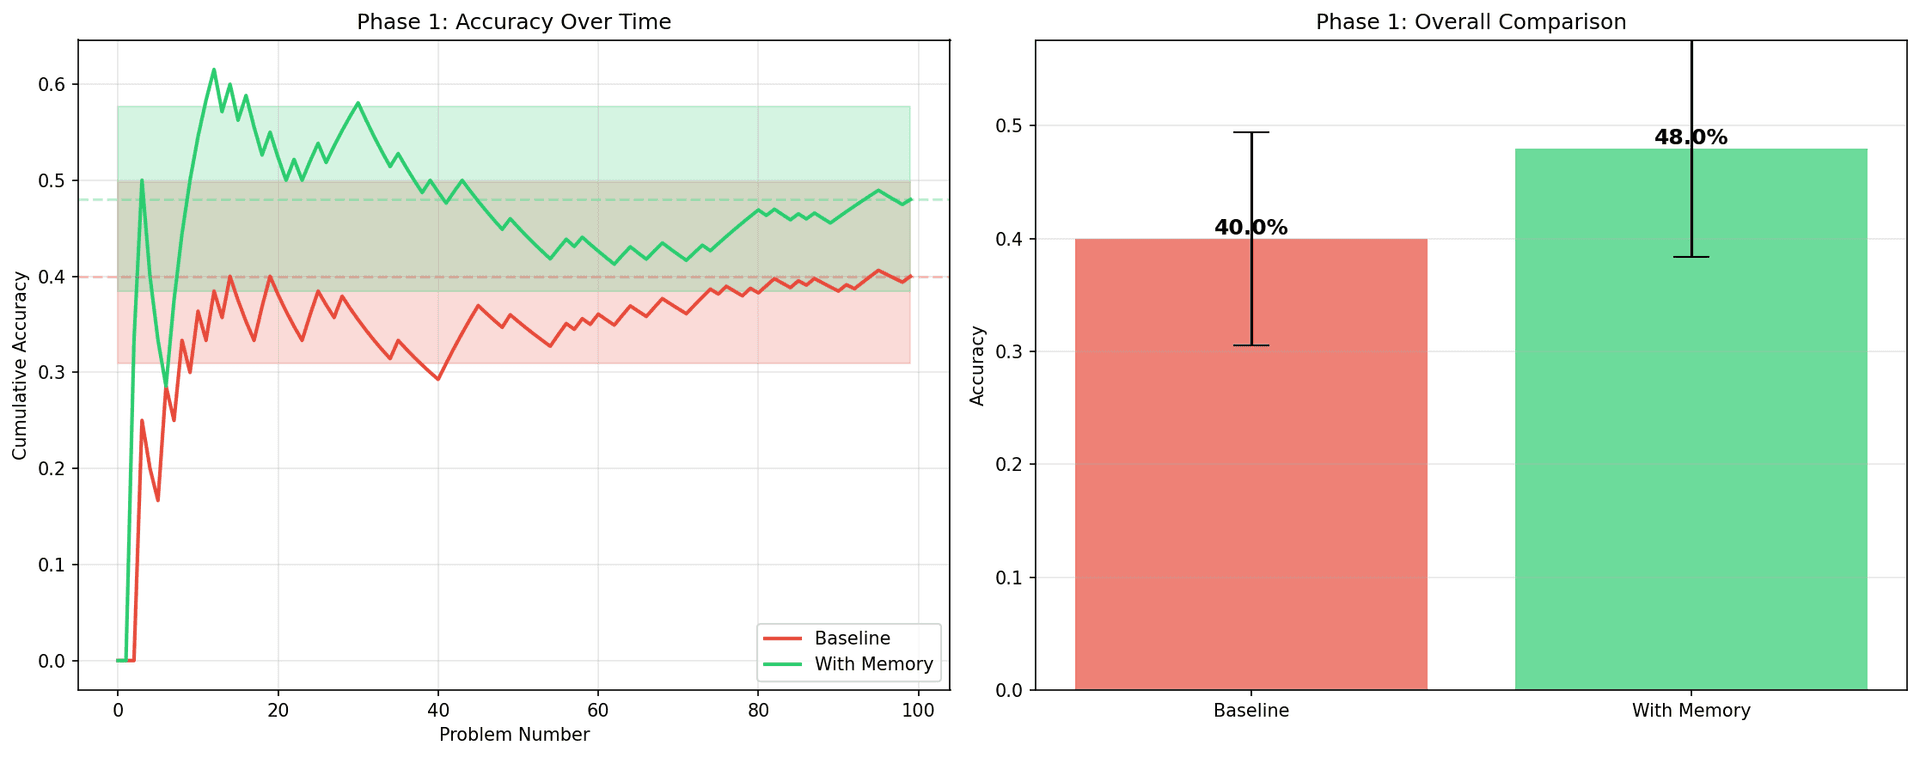
图1:Qwen3-1.7B 在 MATH 竞赛数学 Level 3-4 数据集上的基线准确率(40%)与记忆增强后准确率(48%)对比
2025 年 9 月,Google AI 发布了一篇引发广泛关注的论文(arXiv:2509.25140):ReasoningBank。这篇论文的核心贡献是提出了一个让 LLM 自主进化的框架——与其每次解题后「遗忘」,不如把解题过程中的策略性推理提炼成「记忆片段」,存入一个可检索的记忆库。
具体来说,ReasoningBank 做了四件事:
Google 的实验证明,这个机制对大型模型有显著提升。但问题是:同样的方法,对参数量只有大模型 1% 的小模型,是否同样有效?
ReasoningBank SLM 的代码结构清晰,整个系统由四个核心模块组成:
src/memory.py)采用 JSON 文件存储记忆条目,每个 MemoryItem 包含:标题、描述、详细内容、来源问题ID、成功标记和时间戳。所有记忆最终持久化到 memory_bank/reasoning_bank.json。在 Phase 1 实验结束后积累了 223 条记忆,其中来自成功解题的占 94.6%(211条),来自失败的占 5.4%(12条)。这个比例本身就说明了一个问题:小模型的成功率不高,失败案例收集相对困难。
src/retrieval/retriever.py)使用 sentence-transformers 库加载 Qwen3-0.6B-Embedding 模型,对每条记忆和每个新问题生成语义向量。检索时计算余弦相似度,选取 Top-K 最相关的记忆。
关键设计:答案泄露防护。这是该项目中一个非常实用的工程细节——检索系统会主动过滤掉包含以下内容的记忆:与测试题期望答案数值相同的结果;与原问题文本相似度超过 90% 的记忆。这套防护机制确保了实验的公平性:模型不是靠「偷看答案」提升了准确率。
src/extraction/extractor.py)每个问题被喂给 LlamaServerClient(基于 llama-server 的 OpenAI 兼容接口),模型输出推理过程后,MemoryExtractor 会用 LLM 自身来提炼策略——把一段完整的推理轨迹「压缩」成 1-3 条可迁移的记忆条目,无需人工标注。
src/judge/evaluator.py)使用 qwedsacf/competition_math 数据集(MATH 数据集的竞赛数学子集,Level 3-4 难度),MathJudge 负责判断模型输出是否与标准答案一致。
Phase 1 的实验流程非常清晰:
最终结果:
| 指标 | 基线 | 记忆增强 | 变化 |
|---|---|---|---|
| 准确率 | 40.0% | 48.0% | +8.0% |
| 95% 置信区间 | [30.9%, 49.8%] | [38.5%, 57.7%] | 重叠 |
| 统计显著性 | — | — | 不显著 |
关键发现:
ReasoningBank SLM 不是一个可以 pip install 后直接跑的项目。它更像一个可复现的研究框架,需要以下准备:
硬件门槛:需要本地运行 Qwen3-1.7B 量化版(Q8 约 2GB VRAM)和 Qwen3-0.6B Embedding 模型(1.2GB),建议 16GB RAM + 8GB VRAM 以上。Mac M 系列芯片和 Linux 多卡服务器均可。
服务依赖:核心推理依赖 llama-server(llama.cpp 的服务端封装),需先下载 GGUF 模型文件并启动服务:
llama-server -m qwen3-1.7b-q8_0.gguf -c 4096 --port 8080 -ngl 99
README 中有清晰的运行步骤,但不支持 Docker 一键部署,对于没有 GPU 环境的用户来说门槛不低。
数据偏差:Phase 1 中失败案例仅占 5.4%,意味着记忆库高度偏向成功经验。失败的教训往往比成功经验更有价值,这个偏差可能会限制模型从错误中学习的能力。
统计显著性不足:样本量(100道题)相对较小,虽然 +8% 的改善是真实的,但无法排除随机波动的可能。作者自己也承认这一点,并计划在后续 Phase 中扩大测试规模。
无许可证:项目采用 No License,意味着代码无法被合法复用和分发。这对于一个实验性研究项目来说是常见但略显遗憾的选择。
ReasoningBank SLM 的价值不在于刷出了一个 SOTA 结果,而在于验证了一个方向:即使是小模型,也能从「记住怎么做题」中受益。这个发现对以下场景有直接意义:
Phase 2(用记忆中的成功推理轨迹微调模型)和 Phase 3(多轮自我进化)尚未实现,但 Phase 1 已经证明了基本假设成立。
| 维度 | 评分 | 说明 |
|---|---|---|
| 创新性 | ★★★★☆ | 将 Google 前沿研究首次应用于 SLM 领域,填补了小型模型持续学习的研究空白 |
| 代码质量 | ★★★☆☆ | 结构清晰但无测试覆盖,记忆提取和检索逻辑缺乏单元测试 |
| 实验严谨性 | ★★★★☆ | 答案泄露防护、置信区间分析、基线对比一应俱全,但样本量偏小 |
| 文档完整性 | ★★★★☆ | README 详尽,涵盖背景、技术实现、实验结果和运行步骤,但缺乏快速部署方案 |
| 实用性 | ★★☆☆☆ | 需 GPU + llama-server + 手动配置,普通用户难以直接使用 |
一句话评价:这是一次严谨的学术复现实验,证明了「记忆对小模型有效」这个核心假设。如果你对 LLM 的持续学习和自主进化感兴趣,这是目前少有的、代码可查的小模型实践案例。
