
deep-prove
Lagrange-Labs/deep-prove加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个场景:一家医疗 AI 公司把 GPT-2 级别的推理服务部署在第三方 GPU 集群上。客户是保险公司,他们要拿模型给出的风险评分去做理赔决策。问题来了——模型权重在服务商手里,推理跑在别人的机器上,客户凭什么相信这个分数真的由模型算出来,而不是被人改了一行代码?
传统做法是让客户自己复算一遍推理,但 7B 模型的推理成本足以吃掉业务利润;更糟的是,如果模型权重属于服务商,客户连"算的是不是这个模型"都无法验证——把权重加密也不行,解密了还是黑盒。
零知识证明(ZKP)给出的答案是第三条路:不暴露模型、不暴露输入,只证明"推理结果与承诺的模型一致"。这正是 DeepProve 要做的事,而且是第一个端到端做完整 LLM 推理证明的系统。
Lagrange Labs 由 Ismael Hishon-Rezaizadeh 和 Amir Rezaizadeh 于 2023 年创立,是以太坊零知识证明扩容赛道的头部项目之一,核心产品包括 Lagrange 证明网络与开源证明库(基于 ceno 的 sumcheck/GKR 实现)。
公司成立之初做的是通用 ZK 协处理器。2025 年前后,他们意识到一个更值钱的方向:可验证 AI(Verifiable AI)。逻辑很直接——当 AI 模型开始进入医疗、金融、国防这些强监管领域,"能不能审计"会从加分项变成准入门槛。zkML(零知识机器学习)因此成为赛道热点,但此前的方案普遍很慢:zkGPT 只能证明单个 token 的局部推理,zkLLM 只覆盖 Softmax 这一个算子,都算不上"模型推理证明"。
DeepProve 系列的推进节奏很清晰:
传统的 ZK 证明思路是把整个推理重写成一堆逻辑门电路,再用电路去证明。就像让审计员拿放大镜一行行核对 7B 模型的每一个乘加运算——严谨,但慢到无法商用。
DeepProve 换了个思路,可以类比成"一次算完,出具收据":
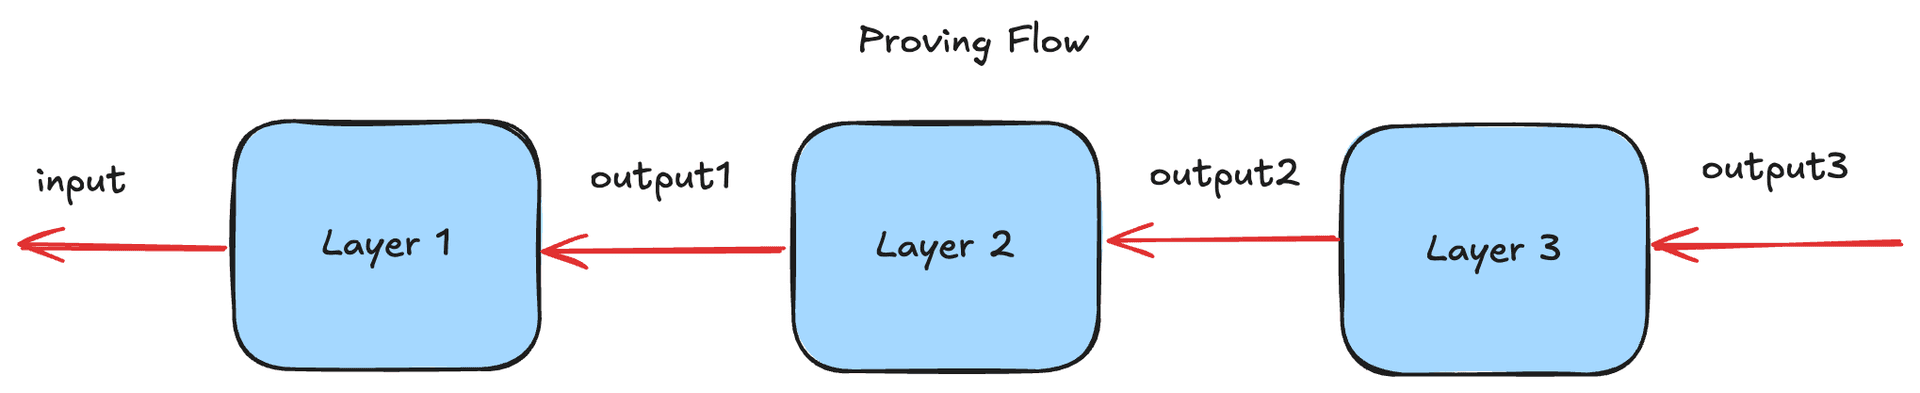
图:DeepProve 的逐层证明与链式组合流程(仓库 docs/src/assets/proving_flow.png)
| 类别 | 支持内容 |
|---|---|
| LLM | GPT-2、Gemma 3、Llama 2(全 Transformer 层:Embedding、RoPE/绝对位置编码、因果掩码、多头注意力、Softmax、LayerNorm/RMSNorm、Argmax) |
| 传统模型 | Dense、Conv2D(FFT 优化)、ReLU/GELU、MaxPool、Reshape/Flatten/Add |
| 权重格式 | SafeTensors(推荐,--hf 自动从 Hugging Face 拉取)、GGUF、ONNX |
权重和激活被量化到固定零中心区间,默认 [-2^11, 2^11-1](12-bit 对称量化),位宽通过 ZKML_BIT_LEN 调整(8/10/12/16)。开启 --accuracy 会启用离群值平滑与逐张量激活跟踪,GPT-2 在 12-bit 下与浮点基线的余弦相似度可达 99.6% 以上,代价是证明时间增加。
公开二进制使用 HyperKZG 多项式承诺方案,构建于 arkworks 之上,因此对任何配对友好曲线通用。CPU 构建默认 BN254;GPU 构建(--features cuda)当前仅支持 BN254。
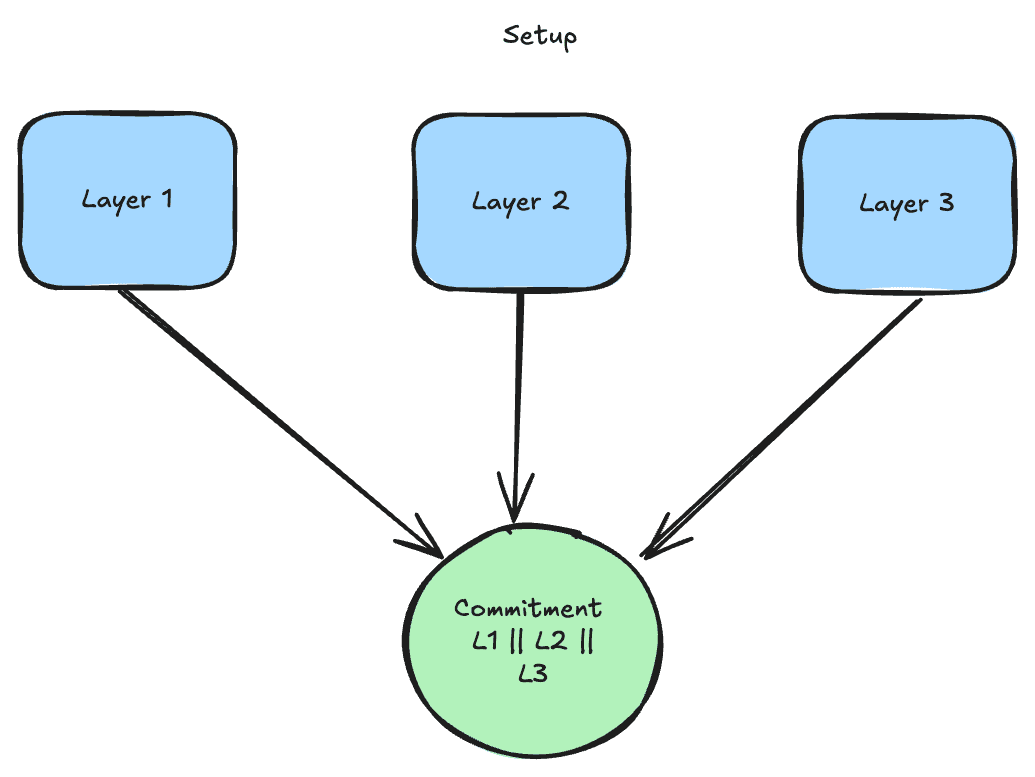
图:HyperKZG 承诺方案示意(仓库 docs/src/assets/commitment.png)
| 模型 | 序列长度 | 证明耗时 | 验证耗时 | 证明大小 | 吞吐 |
|---|---|---|---|---|---|
| GPT-2 | 64 | 2.35 min | 1.25 s | 7.95 MiB | 27 tokens/min |
| GPT-2 | 512 | 7.64 min | 1.33 s | 10.71 MiB | 67 tokens/min |
| Gemma 3 | 64 | 8.49 min | 3.69 s | 16.34 MiB | 8 tokens/min |
| Gemma 3 | 512 | 18.95 min | 4.32 s | 21.73 MiB | 27 tokens/min |
注意这里的吞吐是证明吞吐而非推理吞吐——真实推理本身很快,慢的是生成密码学证明。验证端 14 秒、证明 727 MiB,这个"验证极快、证明较慢"的组合正是 ZKP 在区块链场景下的典型特征。
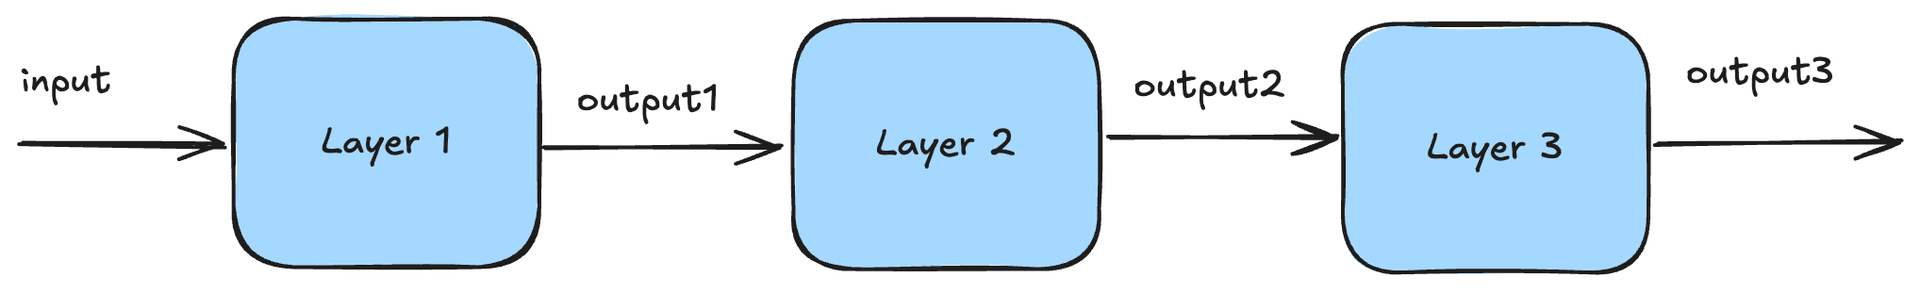
图:推理与量化流程(仓库 docs/src/assets/inference.png)
代码已支持横向证明分发与 GPU 加速两条路线:--features cuda(Linux + NVIDIA)把 PCS 换成 HyperKZGGpu 并在 burn 的 CUDA 后端跑推理,是最快路径;--features wgpu 跨平台(Linux/macOS/Windows)只加速推理,PCS 仍跑在 CPU。--distributed --num_chunks N 可在单机上模拟分块分布式协议,用于测量内存切分效果;GPU prover 集群仍在路线图上。
仓库不只是算法库,还是一套完整工程:deep-prove-worker 是证明生成服务端,deep-prove-cli 用于本地或向远端证明网络提交任务;tenstore 是张量存储门面,支持本地与 S3 兼容后端;tenvis 是交互式 CLI 调试工具;telemetry 统一 OpenTelemetry 链路追踪。
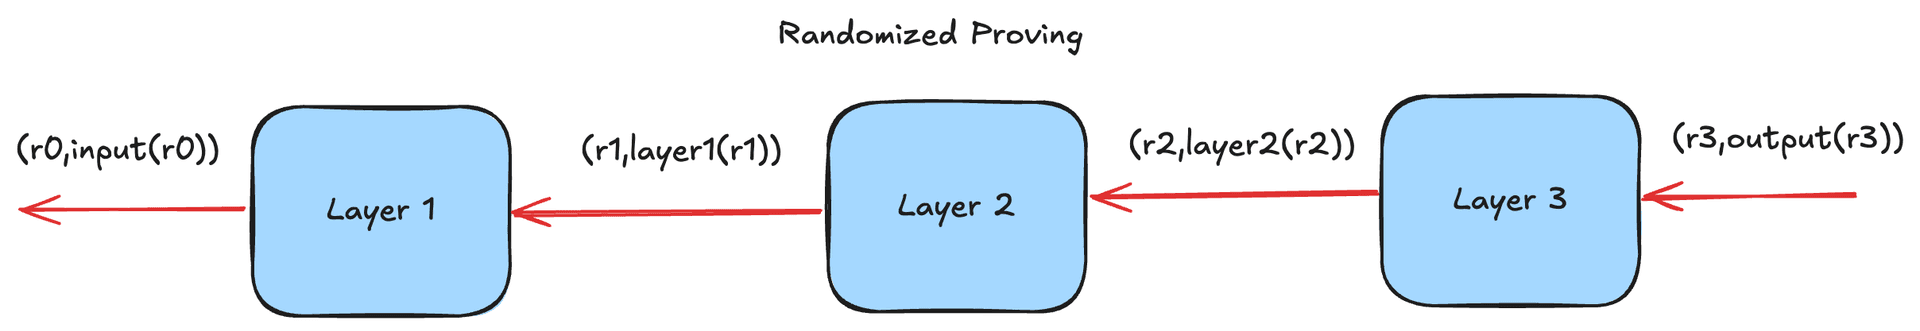
图:随机化证明机制(仓库 docs/src/assets/randomized_proving.png)
这条路的门槛明显高于普通开源项目,需要提前知道几件事:
| 环节 | 门槛 |
|---|---|
| 工具链 | Rust + Cargo,且锁定 nightly-2026-01-27 工具链(rust-toolchain.toml) |
| Python | 3.10+,仅在跑 MLP/CNN 的 bench.py 时需要 |
| GPU | 可选。CUDA 12.x + NVIDIA 驱动,仅 GPU 构建需要 |
| 硬件 | CPU 构建即可,但长上下文 LLM 证明吃内存,官方参考机是 24 核 / 504GB 内存 |
| 外部依赖 | Hugging Face 权重下载;Llama 2 属门控模型,需 huggingface-cli login |
| 子模块 | .gitmodules 存在,clone 时需 --recursive |
交互形态是纯 CLI,没有 Web UI。核心入口是 bench-llm 二进制,配套 bench.py(Python)跑 MLP/CNN 基准。典型流程:
cargo build --release -p zkml --bin bench-llm
cargo run --release --bin bench-llm -- \
  --model gpt2 --hf openai-community/gpt2 --sequence 64
容器化方面提供了 3 个 Dockerfile(deep-prove-worker、deep-prove-aws-client、deep-prove-aws-worker),多阶段构建,最终镜像基于 ubuntu:24.04,非 root 用户运行,暴露 8080 端口。但仓库没有提供开箱即用的 docker-compose 或 Kubernetes 编排,CI 里只有一份面向测试的 scripts/ci/compose.yml。
仓库 LICENSE 并非 MIT/Apache,而是自定义的 Lagrange License。关键条款:
这意味着:把它集成进商业产品对外提供服务,基本踩线;对外分发二进制也不被许可。对大多数开源项目而言这几乎是"不可商用"的等价表述,是评估落地时必须过法务的一关。
zkml/README.md 开篇即声明:"This codebase is not audited and not production ready and is provided as is. Use at your own risk."
cuda feature 仅 Linux + NVIDIA,且 GPU 构建当前只支持 BN254 曲线证明的是"量化后模型的推理",与原始浮点模型之间存在偏差。默认量化下相似度可能低于 99.6%,需要 --accuracy 模式才能达到高精度,但会显著拉长证明时间。这个权衡在合规场景里需要被明确量化——审计方一定会问:你证明的到底是不是生产环境跑的那个模型?
198 个 Rust 源文件、约 310 万字节代码规模(含测试与生成资产)、14 个 GitHub Actions workflow、38 篇 mdBook 文档、37 位贡献者,工程质量在 zkML 领域属上乘。但测试相关文件在仓库中占比偏低,贡献分布集中于少数核心成员(nikkolasg 309 次提交、matthiasgoergens 128 次)。
DeepProve 的真正意义不在于"又一个 zkML 库",而在于它把验证的对象从"一个片段"升级为"完整的一次推理":
商业侧,Lagrange 已推出 LA 代币,DeepProve 被定位为其"可验证 AI"叙事的技术底座。但要清醒看待:从研究原型到生产可用的可验证 AI 中间,还隔着许可证开放、证明体积压缩、GPU 集群 prover 这三道坎。
数据采集时间:2026-10-28 | 数据来源:GitHub API(仓库元数据、文件树、README、LICENSE、CI 配置)+ 官方博客与 IACR ePrint 论文摘要
