
quant-mind
LLMQuant/quant-mind加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
一位量化研究员每天面对的不是代码,而是几百页研报、财报 PDF、新闻流和电话会议记录。真正折磨人的从来不是"读不完",而是"读完不敢用"——模型总结出的结论从哪一页来?数据是哪一天的?上个月发布的报告会不会污染今天的判断?
QuantMind(LLMQuant/quant-mind)就是冲这个问题来的。它不是一个"更强的 RAG 框架",而是把金融原始材料先加工成带类型、带引用、带时间戳的结构化知识,再让下游检索和推理去用这些可信的产物。仓库的口号很直接:"Don't import it. Open it."——它把自己定义成智能体原生的工作台,而不只是又一个 pip 包。
项目背后是 LLMQuant Research 团队(论文作者来自剑桥、CMU、NUS、北大、中科大、上海交大、北航等),论文《QuantMind: A Context-Engineering Based Knowledge Framework for Quantitative Finance》被 NeurIPS 2025 GenAI in Finance Workshop 收录(arXiv:2509.21507)。
论文的核心贡献是两阶段解耦架构:知识抽取阶段负责把异构文档(文本、表格、公式)转成结构化知识单元;智能检索阶段负责语义搜索、多跳推理与可审计的知识感知生成。论文中的受控用户研究显示,相比无 AI 辅助和通用 AI 助手,QuantMind 在事实准确性上分别提升 1.14 分(p<0.001)和 0.43 分(p=0.001),感知帮助性显著提升(p=0.003)。
但仓库比论文走得更远。2026 年 7 月的一次大重构把项目改造成 agent-native:新增 AGENTS.md/CLAUDE.md 常驻契约、contexts/ 渐进式披露文档、可移植 skills、以及 Claude + Codex 双端 hooks。作者把这称为 harness engineering(智能体工程),核心赌注是:"弱模型 + 好脚手架,胜过强模型裸奔。"
如果把金融信息处理比作做菜:
QuantMind 的独特之处在于它两个都做了,而且都写进了仓库结构本身。
确定性的预处理层:preprocess/ 模块提供 fetch / parse / format / clean,刻意不让模型参与,保证字段忠于原文、可复现可回放。这是为了解决金融场景最敏感的"时点正确性"(point-in-time correctness)问题。
配置驱动的操作层:PaperFlow(cfg).build(input) 一次绑定不可变配置,随后按输入逐个应用;collect_news 采集可回放的源窗口;batch_run 把任意操作扇出到一批输入。用户不必自己写 asyncio.gather 样板代码。
强类型知识形状:knowledge/ 层用 Pydantic 定义了三种知识形态——FlattenKnowledge(扁平卡片,用于 News / Earnings / Factor / Thesis)、TreeKnowledge(整篇论文的结构树)、GraphKnowledge。每个产物自包含:正文、as_of 时间戳、轻量来源引用,因此可以独立持久化并按时间查询。
三层检索:底层 rag/(确定性切分 + BM25/相似度召回)、中层 library/(本地持久化 + 语义检索)、顶层 mind/(由 LLM 决策的推理式检索)。三者共同支撑 RAG、Agentic RAG、深度研究和数据 MCP 服务。
架构边界是被强制执行的:项目用 import-linter 把依赖方向写成契约——etl 是纯标准库的独立叶子,utils/knowledge/preprocess 是叶子层,configs/library 只依赖 knowledge,rag 只依赖 preprocess,flows 是顶层。
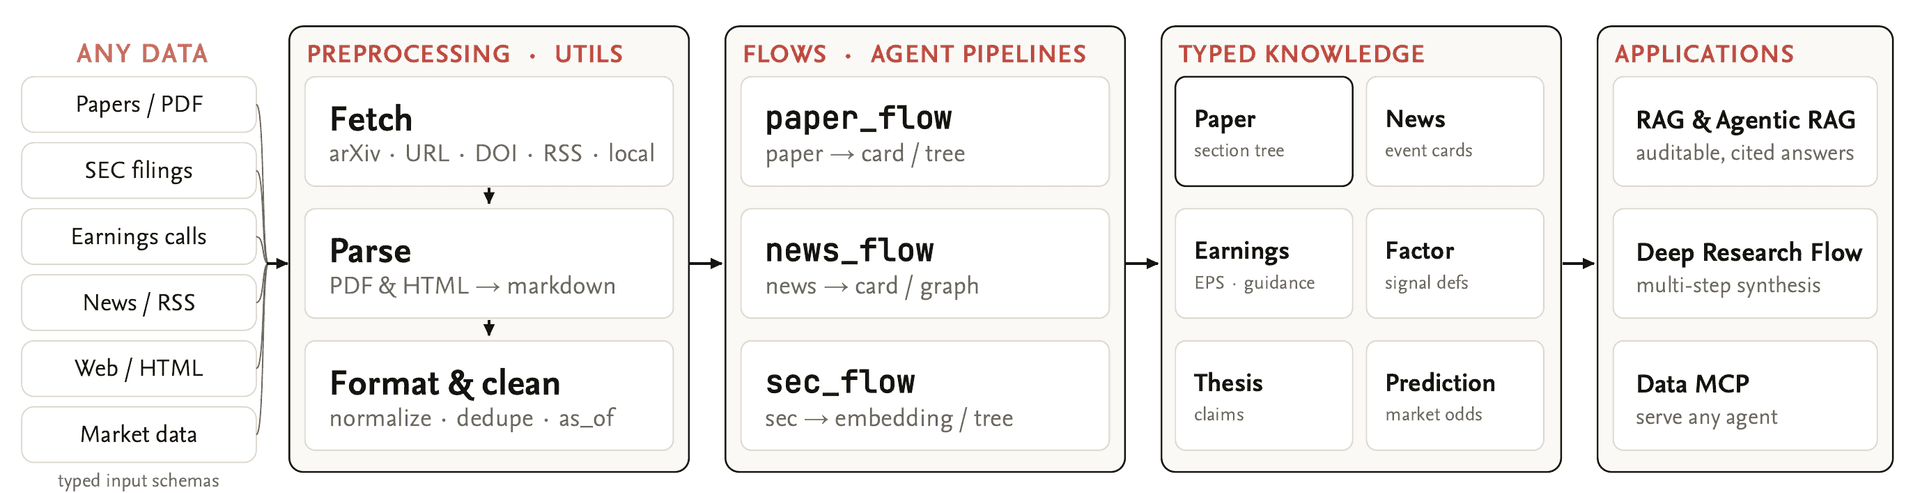
图:context engineering 链路——来源经预处理与 flow 流向强类型知识
测试与质量门禁:scripts/verify.sh 是唯一验证入口,五个快速失败步骤——ruff format --check、ruff check、basedpyright、lint-imports、pytest——且必须离线可跑。CI 工作流执行完全相同的脚本。pytest 覆盖率下限被明确设为 75%(分支覆盖率),并在 pyproject 注释里保留了迁移过程中的演进轨迹(60% → 65% → 75%)。
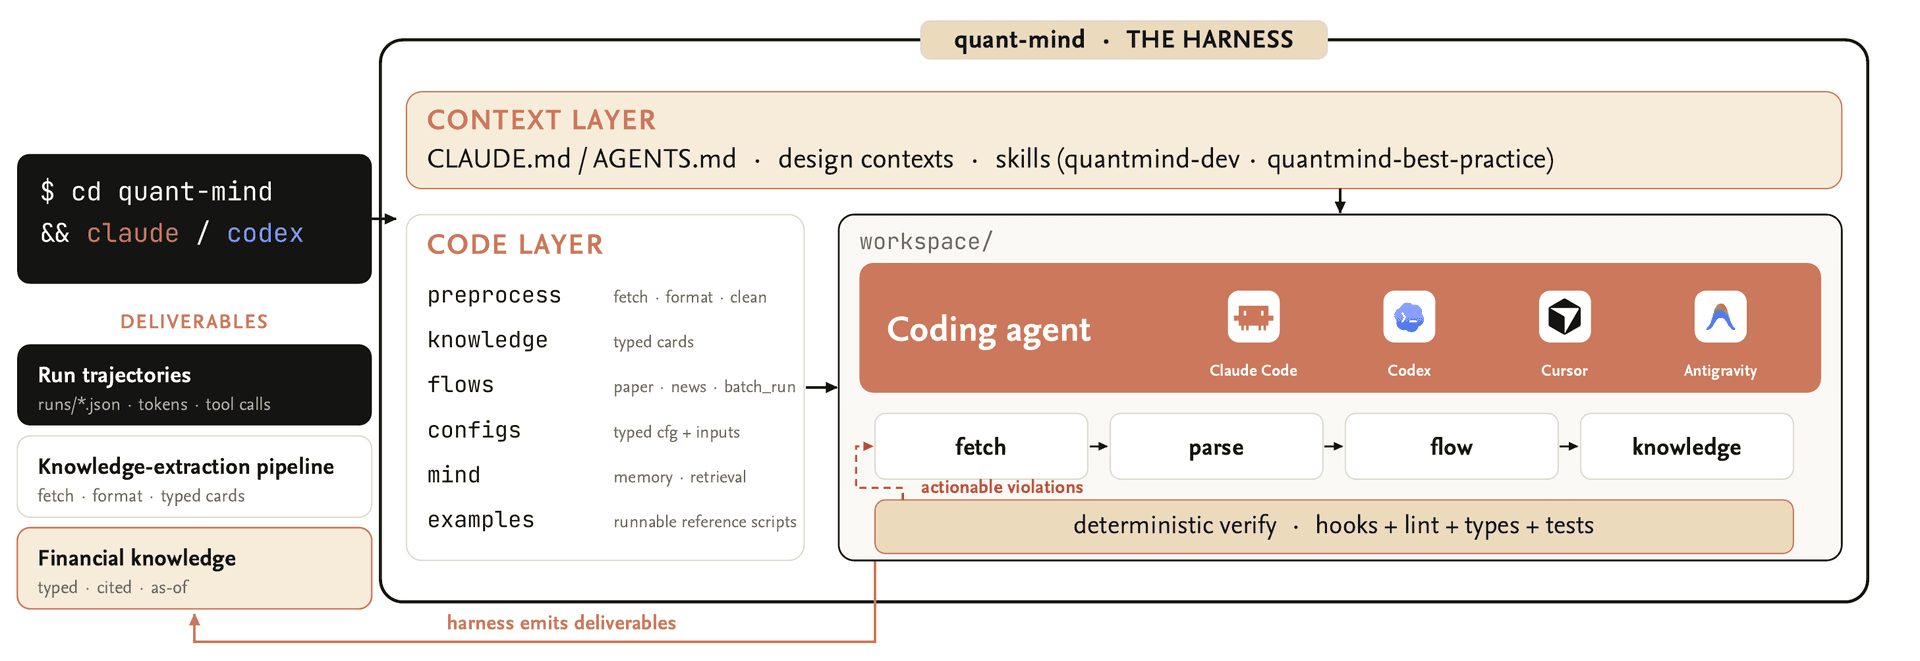
图:harness engineering——context 层、code 层、工作区、确定性校验与交付物
Agent 路径(官方推荐):
git clone https://github.com/LLMQuant/quant-mind.git
cd quant-mind && claude    # 或 codex
进去之后直接用自然语言描述需求,智能体读 AGENTS.md 契约、加载相关 contexts/ 页面、写出流水线,然后跑 scripts/verify.sh 交活。
Library 路径:
uv venv && source .venv/bin/activate
uv pip install -e .
import asyncio
from quantmind.configs import PaperSemanticCfg
from quantmind.configs.paper import ArxivIdentifier
from quantmind.flows import PaperFlow

async def main() -> None:
    flow = PaperFlow(PaperSemanticCfg(model="gpt-5.6-luna", chunk_size=512))
    result = await flow.build(ArxivIdentifier(id="1706.03762v7"))
    print(result.global_summary.summary)

asyncio.run(main())
两条路径的门槛差异明显:Agent 路径零代码但要求本地装有 Claude/Codex CLI;Library 路径需要 Python 3.10+、uv,以及 .env 中的 OPENAI_API_KEY(或 LLAMA_CLOUD_API_KEY)。项目没有 Dockerfile、没有 docker-compose、没有 K8s manifest、也没有任何 Web UI(无 Flask/FastAPI/Streamlit/Gradio 目录)——它是一个库 + 智能体工作台,不是可以一键拉起的服务。
缺乏容器化与可视化是当前最明显的短板。企业内部落地时通常需要 Web UI 与权限控制,仓库目前完全依赖使用者自行用 fastapi/gradio 包一层,官方没有提供参考实现。
外部依赖较重:核心链路同时依赖 OpenAI SDK、OpenAI Agents SDK、LlamaIndex Core/BM25 Retriever、Litellm、PyMuPDF、Trafilatura、liteparse。安装体积偏大,模型调用成本也完全由用户承担(框架本身不提供任何免费额度)。
论文与当前代码存在版本落差:论文描述的是两阶段知识抽取 + 智能检索的完整形态,而仓库 README 明确写着"当前交付面:PaperFlow · collect_news",其余能力(Earnings / Factor / Thesis 卡片、图谱知识、DeepResearch 编排)仍在 Roadmap 中。引用论文结论时需要注意这一区分。
社区规模偏小:贡献者仅 7 人,项目创建于 2025 年 3 月,3125 star / 495 fork 对应的是一个高关注度但参与者不多的早期项目;27 个 open issue 未关闭。仓库虽宣称已从"agent runtime"迁移到当前架构,且旧运行时归档在 archive/agent-runtime-final 分支,但架构演进的频率较高,早期文档存在滞后可能。
合规与数据边界未明:项目处理公开研报与新闻,但 README 未详细说明数据许可、版权与在生产环境中的合规边界,涉及付费数据源时需自行核查。
QuantMind 代表了金融 AI 的一条明确技术路线:不追求让模型直接给答案,而是先把材料加工成可追溯、可复现、可按时间查询的知识资产。这条路线的通用价值在于——任何领域只要存在"证据归属"和"时点正确性"的硬要求(法律、医疗、投研、情报分析),这套"确定性命名的预处理 + 强类型知识 + 分层检索"的范式都可复用。
另一个值得关注的现象是 harness engineering 这个概念本身。把 AGENTS.md、渐进式披露的 contexts/、双端 hooks 和确定性 verify 组织进仓库,让"任何通用编码智能体"进化为"金融知识专家",这比堆更强的模型更贴近可落地的工程现实——也解释了为什么这个没有 Web UI 的纯代码库能拿到 3125 star。
从行业趋势看,"Agentic RAG" 正从概念验证走向工程化,QuantMind 的分层检索(rag / library / mind)正是这一趋势的具体样本;而它选择把确定性留在模型之外,则是对金融场景中"不可幻觉"要求的正面回应。
