
LettuceDetect
KRLabsOrg/LettuceDetect加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你接入了 RAG 检索问答,也接入了编码 Agent。用户问"这个仓库的鉴权中间件在哪个文件?"Agent 回答"在 auth/middleware.py,其中 verifyToken() 会检查 X-API-Key 请求头"。你无法一眼判断这段话里哪一句是真的——文件名可能是编造的,函数名可能压根不存在,整段回答也可能完全正确。
传统方案给出一个二元结论:整段回答"通过"或"不通过"。这对产品化几乎没用:一条 200 字的回答里只要错了一个数字,整段就被判死,误报率高得没法上线。
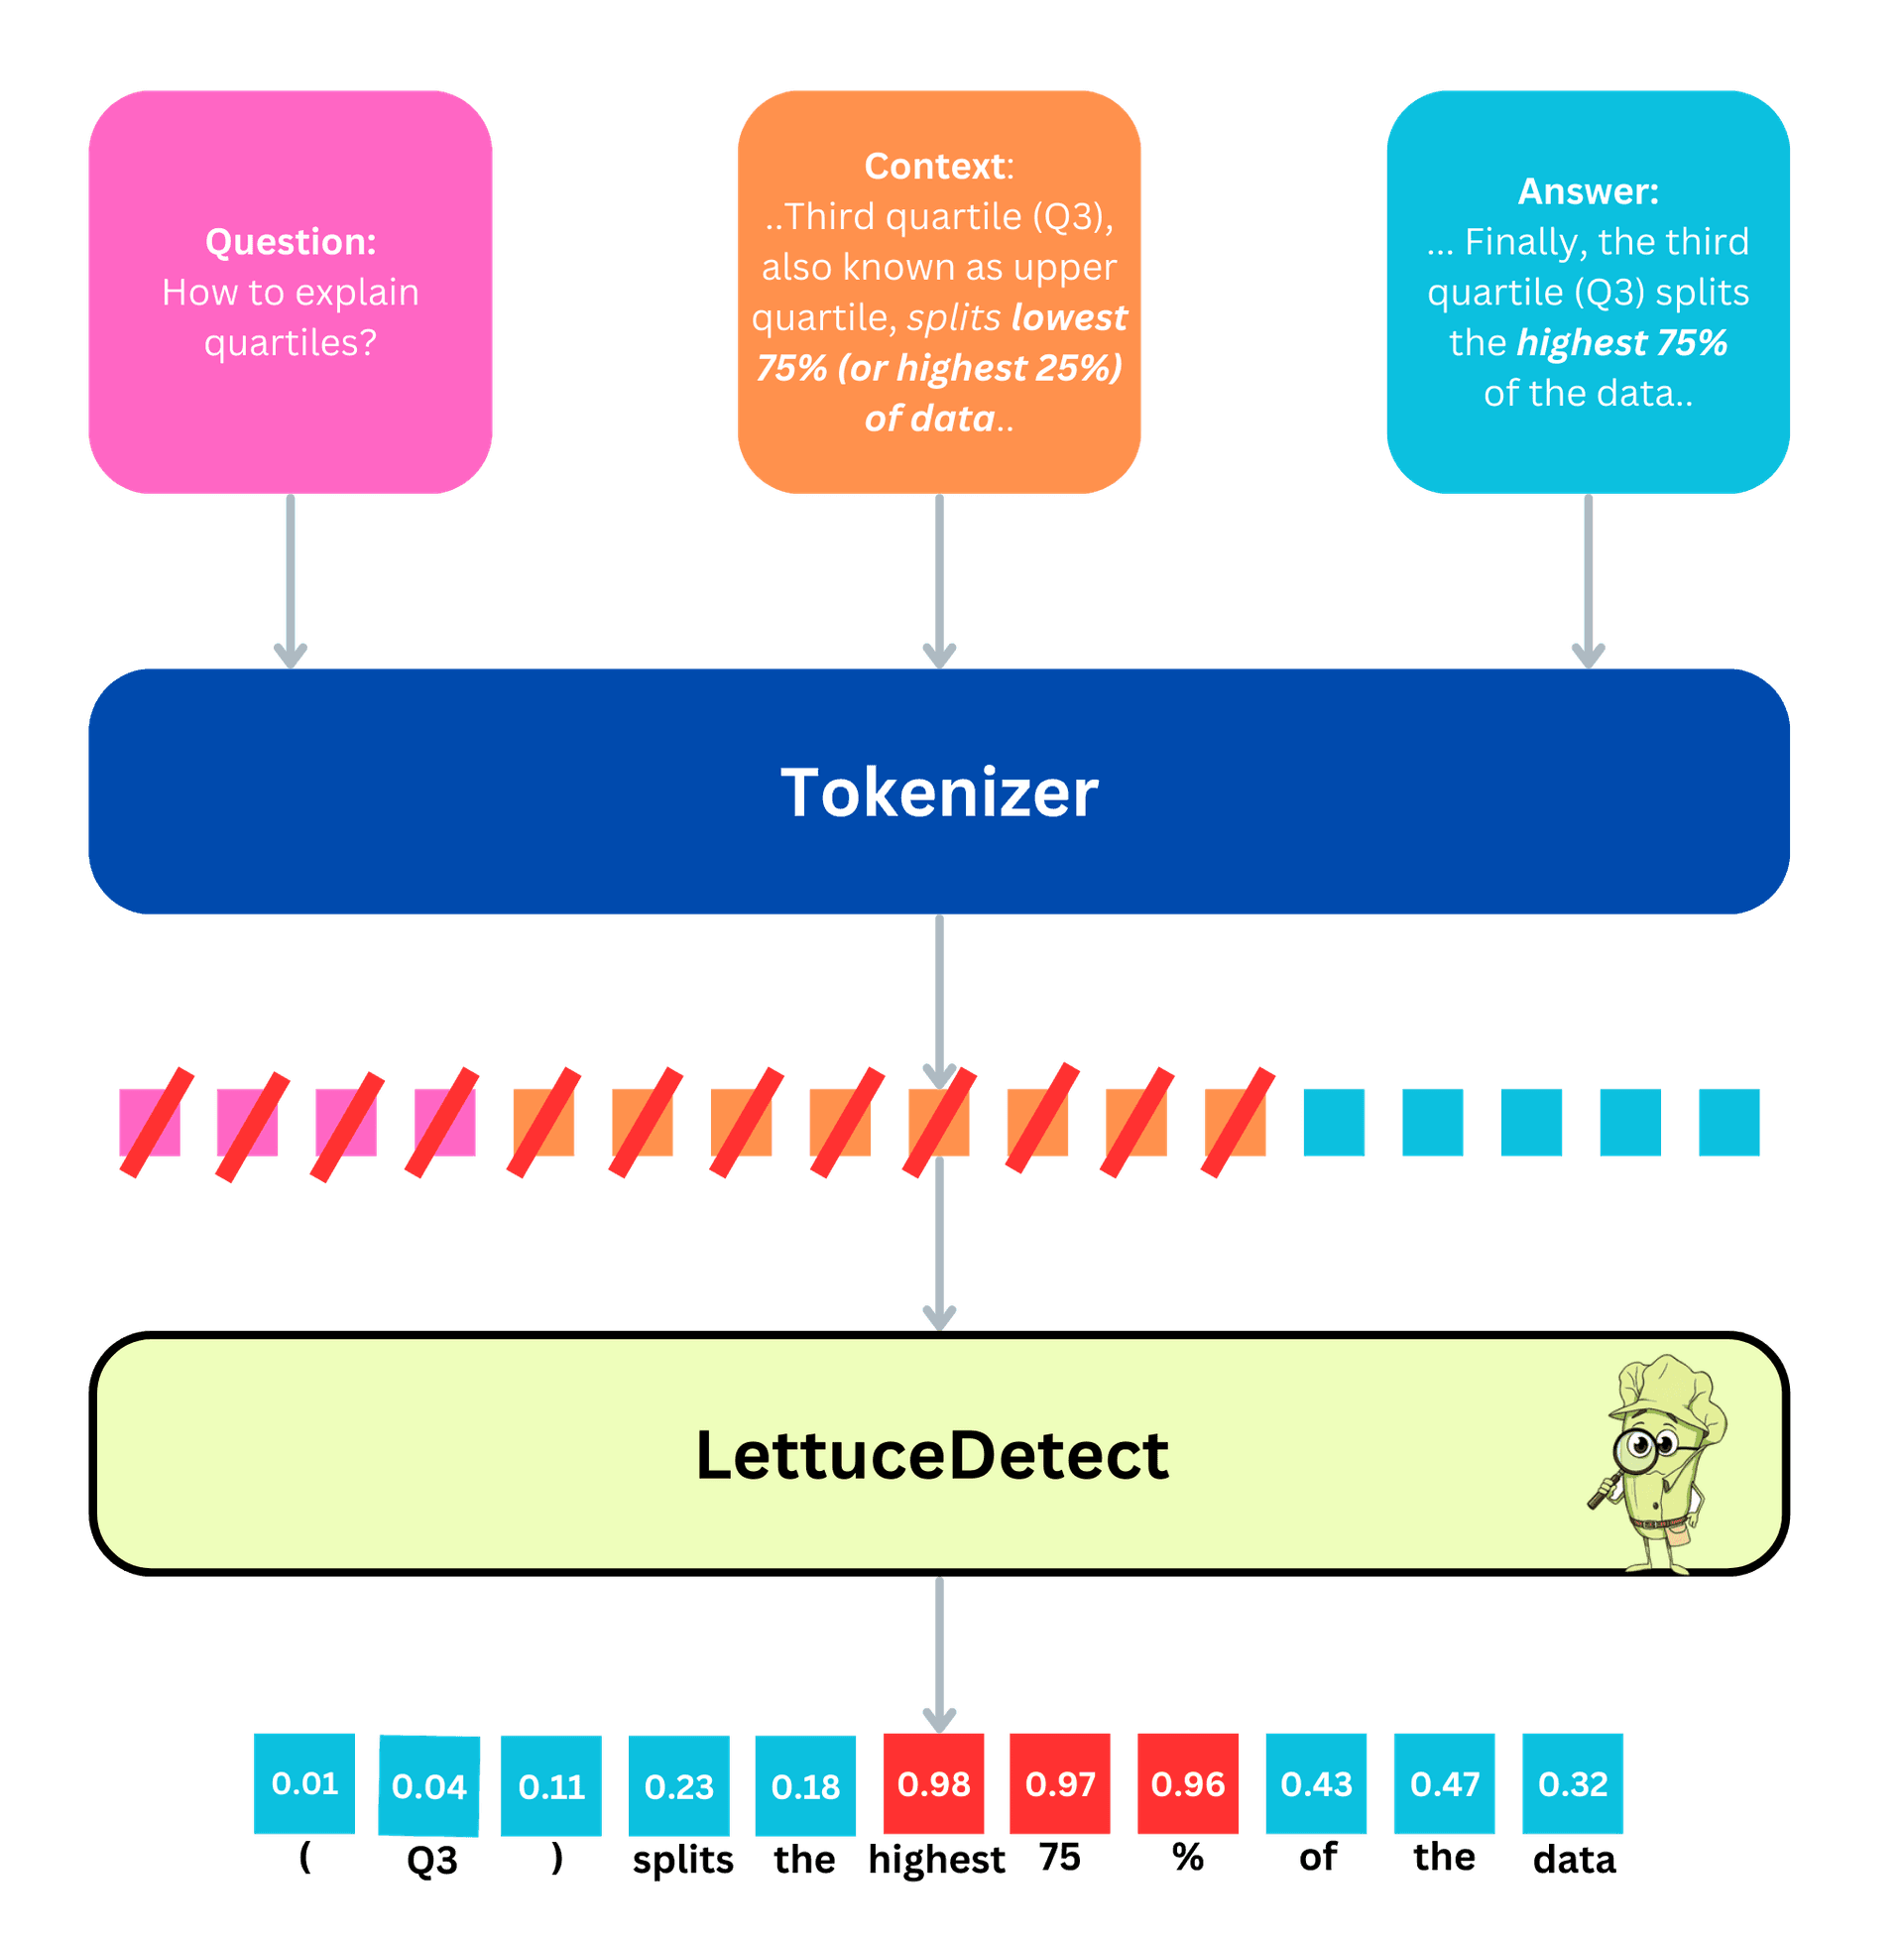
LettuceDetect 的切入点很直接——别再回答"有没有幻觉",直接告诉你"哪几个字符是幻觉"。
LettuceDetect 出自斯洛伐克科希策的 KR Labs,由 Ádám Kovács 等人主导,2025 年 2 月首次提交,配套论文发布在 arXiv(2502.17125),并有 COLING 工业界的 Luna 模型作为思想来源。项目文档站托管在 GitHub Pages,模型全部发布在 Hugging Face,MIT 协议同时覆盖代码与权重——这对企业落地非常关键。
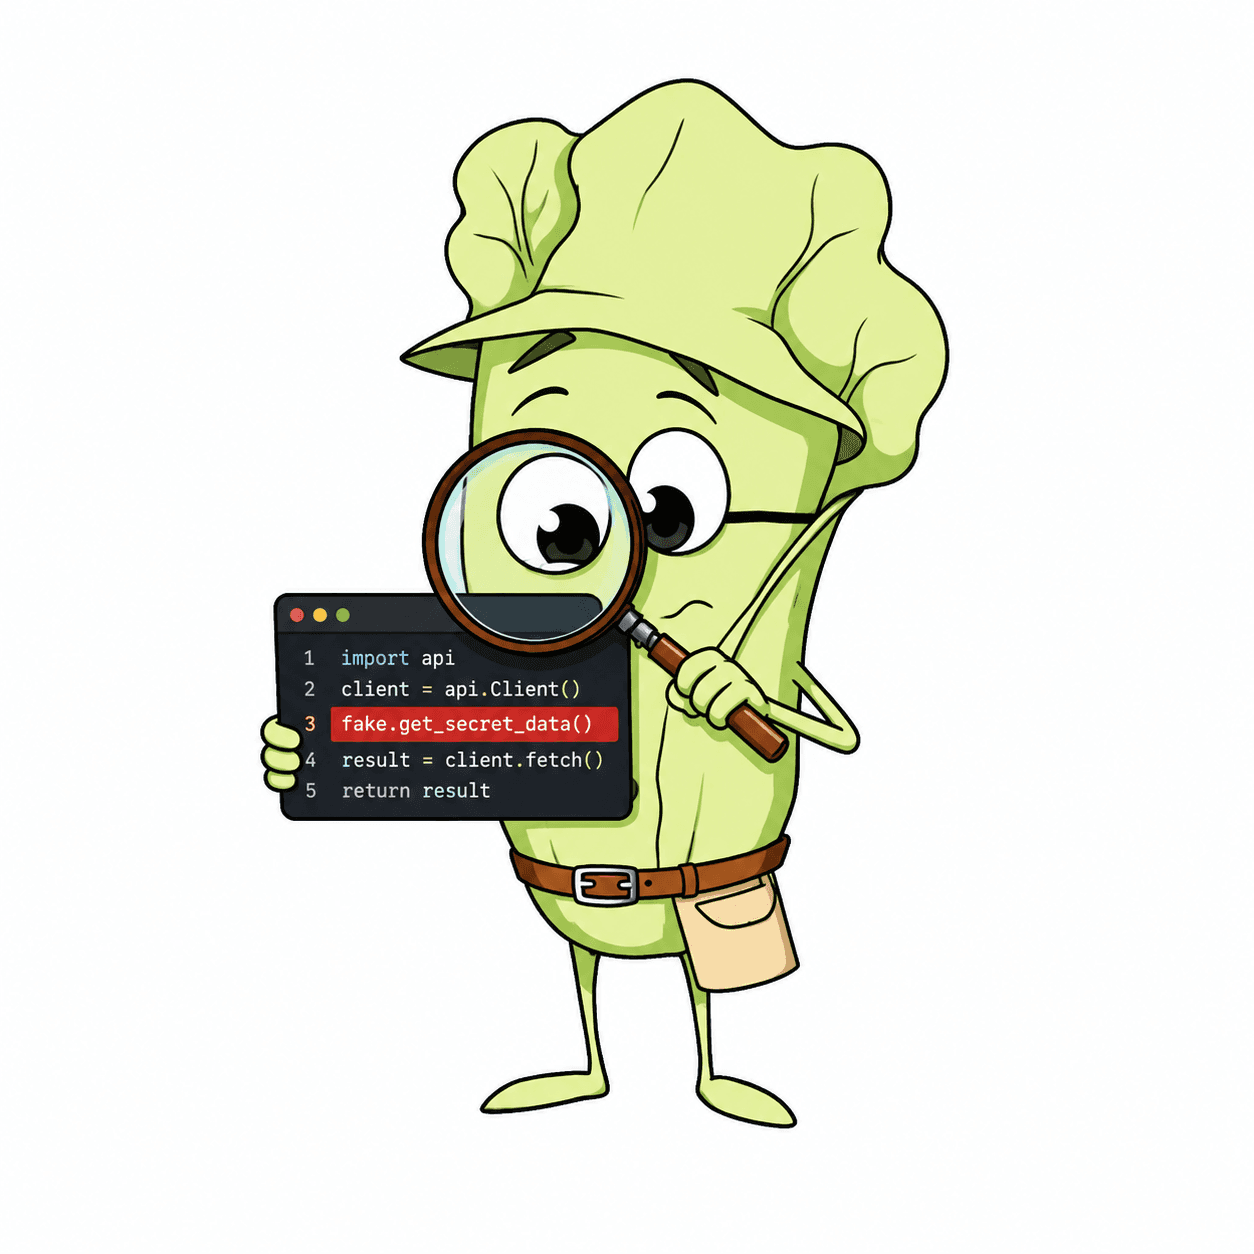
名字"LettuceDetect"(生菜检测)带着黑色幽默:AI 输出像沙拉里的生菜,看起来生鲜,底下可能藏着不新鲜的成分。项目主页那句话很传神——"Because even AI needs a reality check!"
2026 年 6 月,项目做了一次关键转向:从"文档 RAG 幻觉检测"扩展到"代码、工具输出与 Agent 轨迹的幻觉检测",也就是现在的 v2 版本。
传统 LLM Judge 像一个只会说"及格/不及格"的老师,读完全文只给一个结论。LettuceDetect 像一个逐字批改的语文老师,在答案上用红笔圈出每一处"这里没有依据",并标明错因类型——是数值错了(contradiction)、是凭空捏造了一个 API(fabricated_reference)、还是多嘴说了没要求的事(unsupported_addition)。
这套"三级类别 + 13 个子类"的分类体系是 v2 的核心增量:它把 RAGTruth 的冲突/无依据标签、FAVA 的实体/关系/编造标签以及代码幻觉研究里的命名/资源/逻辑错误做了调和。
1. 两种检测器形态
lettucedect-v2-qwen-2b,微调自 Qwen3.5-2B,单次前向直接吐出结构化 JSON,把幻觉区间连同类别、子类别一起输出,还能附带简短理由。2. 三种运行模式:本地 transformer 推理、OpenAI 兼容 API 的 LLM 判定(支持 include_reasoning、verify 二次严格复核)、以及本地 RAGFactChecker 三元组校验。
3. 统一基准:v2 的核心贡献是跨来源的统一评测集,共 10,698 条测试样本,覆盖 SWE-bench 编码 Agent 轨迹、开发者工具输出、ACL 论文片段、README、Wikipedia markdown,以及 RAGTruth 和 14 语言的 PsiloQA。数据构造方式是"从正确答案出发注入局部幻觉,再从编辑操作反解精确字符偏移"。
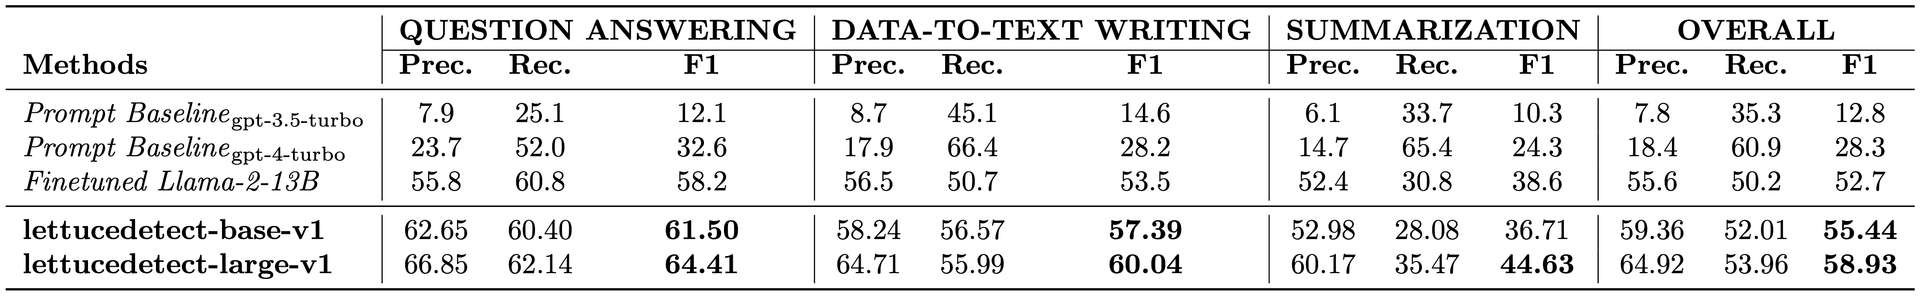
4. 性能亮点:Qwen-2B 在统一测试集上 span-F1 0.689、example-F1 0.921;在编码 Agent 答案上 span-F1 0.602,而论文中对比的 120B 自托管评审只有 0.21、550B 评审只有 0.22,HHEM/Lynx-8B/Granite-Guardian/MiniCheck 等现成检测器基本等于随机水平。这一点的意义在于:大评审模型倾向于把生成的代码全部误杀,专用小模型反而更准。
5. Agent 集成:项目提供 Claude Code Hook 集成(tests/test_claude_code_hook_pytest.py)、CLI 入口 lettucedetect、Streamlit Demo、FastAPI Web 服务与 Python/异步客户端 LettuceClient/LettuceClientAsync。
最低成本路径只有三行:
pip install lettucedetect
from lettucedetect.models.inference import HallucinationDetector
detector = HallucinationDetector(method="transformer",
                                 model_path="KRLabsOrg/lettucedect-base-modernbert-en-v1")
spans = detector.predict(context=contexts, question=question, answer=answer,
                         output_format="spans")
门槛点有三个:其一,模型首次使用需从 HuggingFace 下载(约数百 MB),离线环境需预置权重;其二,EuroBERT 系列加载远程代码,与 transformers 5.x 不兼容,必须锁定 transformers>=4.48.3,<5;其三,若要用 Qwen-2B 生成式模型,建议有 GPU,CPU 上延迟会明显上升。
Web 侧体验完整:pip install "lettucedetect[api]" 后 python scripts/start_api.py prod 起服务,或 streamlit run demo/streamlit_demo.py 跑交互 Demo。API 返回 start/end/text/hallucination_score 结构化字段,接入网关做实时拦截没有障碍。
评测协议不可跨表比较。项目自己在 README 里明确警告:v2 的统一基准分数(0.689)与 RAGTruth 切片分数(0.574)不要混为一谈,早期英文/多语言模型族有各自独立协议。跨代比较数字是常见的误读来源。
跨度型幻觉仍是难点。编码器模型擅长抓"某个具体值不对",但当整段结论"方向正确、推理链条错乱"时,token 级定位的收益递减。论文里可看到 LettuceDetect-large 在代码场景只有 0.17 span-F1,说明旧一代模型面对 Agent 输出明显水土不服。
分类级联有精度折损。taxonomy-head 单独的类型标注准确率是 category 0.82 / subcategory 0.64,端到端级联的 typed-F1 只有 0.461,低于生成式模型的 0.585。追求速度就得接受精度损失。
依赖生态摩擦。EuroBERT 的 transformers 版本锁、torch>=2.6.0 的硬性下限、以及 rag-fact-checker 这类冷门依赖,都会在企业 CI 环境里制造摩擦。仓库虽无 Dockerfile,但缺少容器化本身反映了项目的定位:它是"库与模型"而非"可直接交付的服务镜像"。
许可与商业化。MIT 协议无风险,但 HuggingFace 上的部分模型卡对不同用途有额外说明,商用前仍需逐个核对。
幻觉检测正在从"大模型自评"走向"专用小模型 + 精确标注"。LettuceDetect 代表的路线是:用领域数据微一个小模型,让它输出结构化、可定位、带类型的结果,既比通用 LLM Judge 便宜几个数量级,又比二元判定好集成。
代码 Agent 的普及让这件事变得更紧迫——Agent 的错误不再只是"话说错了",而是"造了个不存在的 API",这类错误在下游会直接变成线上故障。span 级定位正是把质检嵌入 CI 与 Agent 循环的必要前提。
值得注意的是对比图里的一条线:编码 Agent 答案上,Qwen-2B 的 0.602 对 LFM-8B 同门模型的 0.507,对 550B 评审的 0.22。
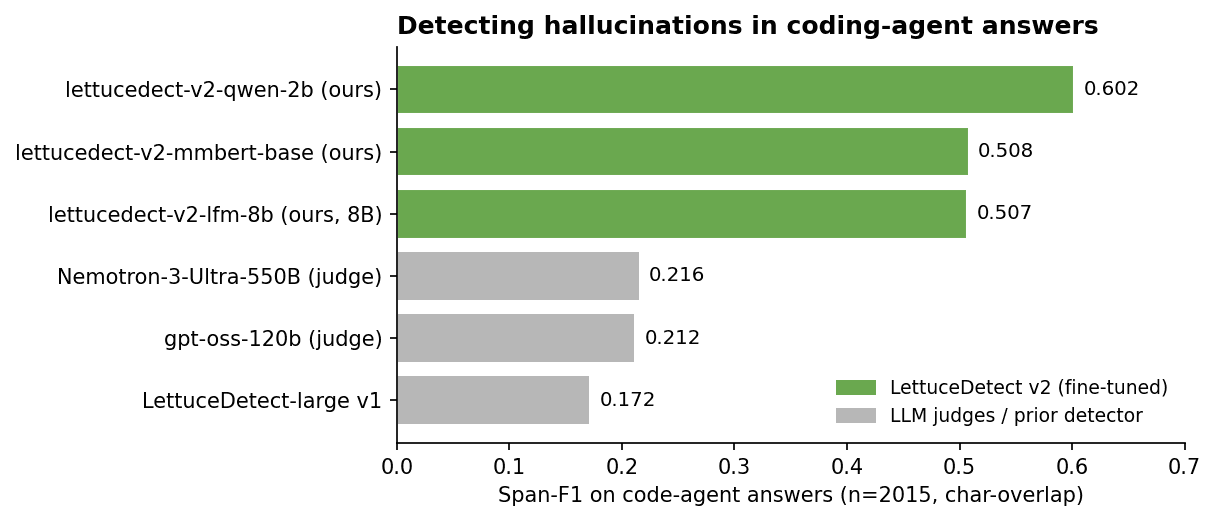
"小而专"正在打败"大而全",这可能是 2026 年 AI 质检工具链最值得记住的一条趋势。
