
AIHOT
KKKKhazix/AIHOT加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
如果你每天早上要面对 50 条 AI 资讯,你真正需要的其实不是 50 条资讯,而是 8 条「值得看的」。麻烦的是,这 8 条怎么挑出来?把 RSS 塞进阅读器,算法不认识「重要」;让大模型直接总结,它会一本正经地把营销稿和重磅发布混在一起排成一行。
2026 年 9 月 28 日,一位自称「设计师出身、半年前还看不太懂代码」的独立开发者「数字生命卡兹克」把一个已经跑在生产环境、月活百万的 AI 热点站 AIHOT(aihot.news)连同全部源代码开源了。这个项目的特别之处不在于技术栈,而在于它把「什么是热点」这件最難的事,从代码里搬了出去,搬进了 29 个可以随便改的 Markdown 提示词文件。
AIHOT 最早只是作者深夜里的一个小念头:一个自动找热点、自己写日报的 AI 资讯站。做了半年后,陆续有做法律、做 HR、做金融、做贵金属的朋友问他:能不能也给我们的行业做一个?
作者的回答很直接:「我做不了。我不懂你们的行业,不知道哪些信源有用。」但紧接着他补了一句:「但你们懂。既然我没办法满足所有人,那就把火种交到大家自己手上。」
于是这个原本属于个人的小工具被重写了一遍:半年时间从「设计师+AI 协同编程」成长为一个 npm workspaces 组织的 TypeScript 单仓,8.4k 星、2k fork,MIT 协议。仓库里带了 18 个公开的海外 AI 资讯源作为示范,但不包含 AIHOT 自己的完整信源名单和运营数据——作者明确要求使用者不要沿用 AIHOT 的名字和 Logo。
有意思的是,这个仓库不是「精心打磨的通用框架」,而是直接从线上生产环境导出的引擎代码。模型榜、Codex 重置监控、主题页大事记这些只对 AI 行业有意义的特性被刻意留在了线上站,开源仓库只保留可迁移的骨架。
如果把 AIHOT 想象成一家报社,而不是一个爬虫项目,整个设计就说得通了。
industry/prompts/ 里那 29 个提示词,就是这家报纸的编辑手册。真正的杀手锏是最后一条:所有提示词原文和入选门槛都公开,改标准不用改代码。用户拿一两百条自己标注的样本,用 scripts/eval-selection.ts 跑一遍校准,再回头改提示词,形成闭环。
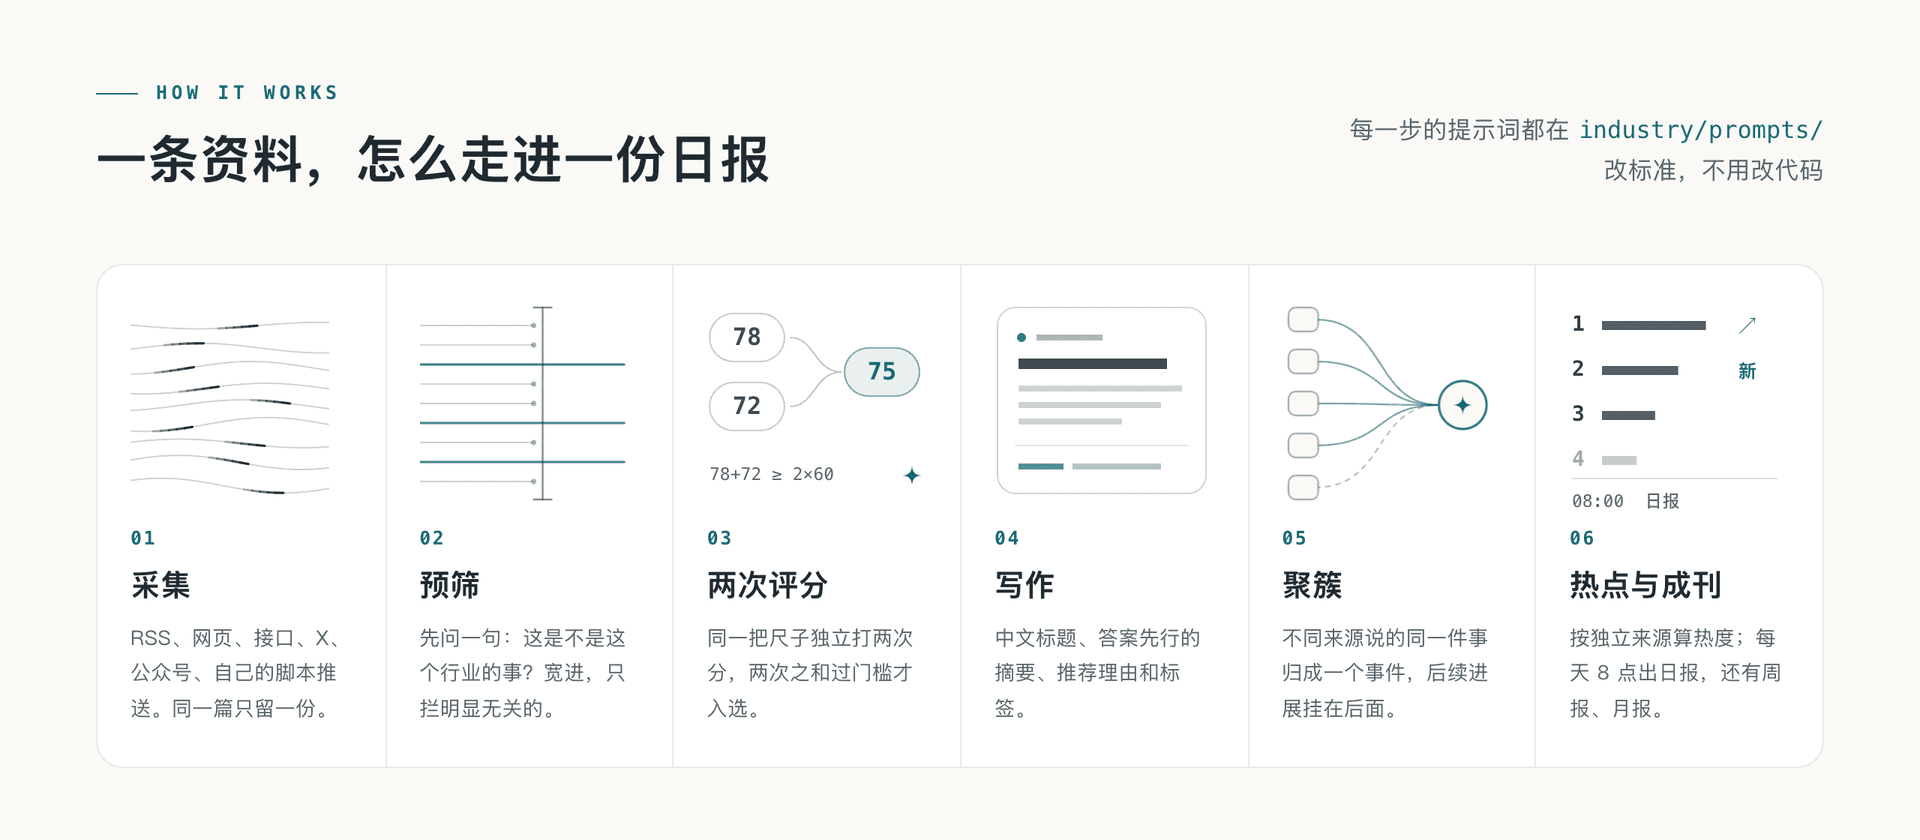
采集层支持六种信源并做三级分层(官方一手 / 官方账号与准官方 / 媒体与个人),各级入选门槛不同,抓取频率按产出自动调整。有一条很务实的设计:发现时已发布超过 48 小时的资料、新信源第一次导入的存量,都按原文时间归档,不进「今天」也不推送——旧文不刷屏。
精选层是最吃工程的部分。评分标准是一份独立文件 industry/prompts/selection-score.md,模型对同一份资料独立打两次分,两次都过阈值且不是已有精选的重复才入选。这在工程上用一个很朴素的办法解决了 LLM 输出的方差问题。
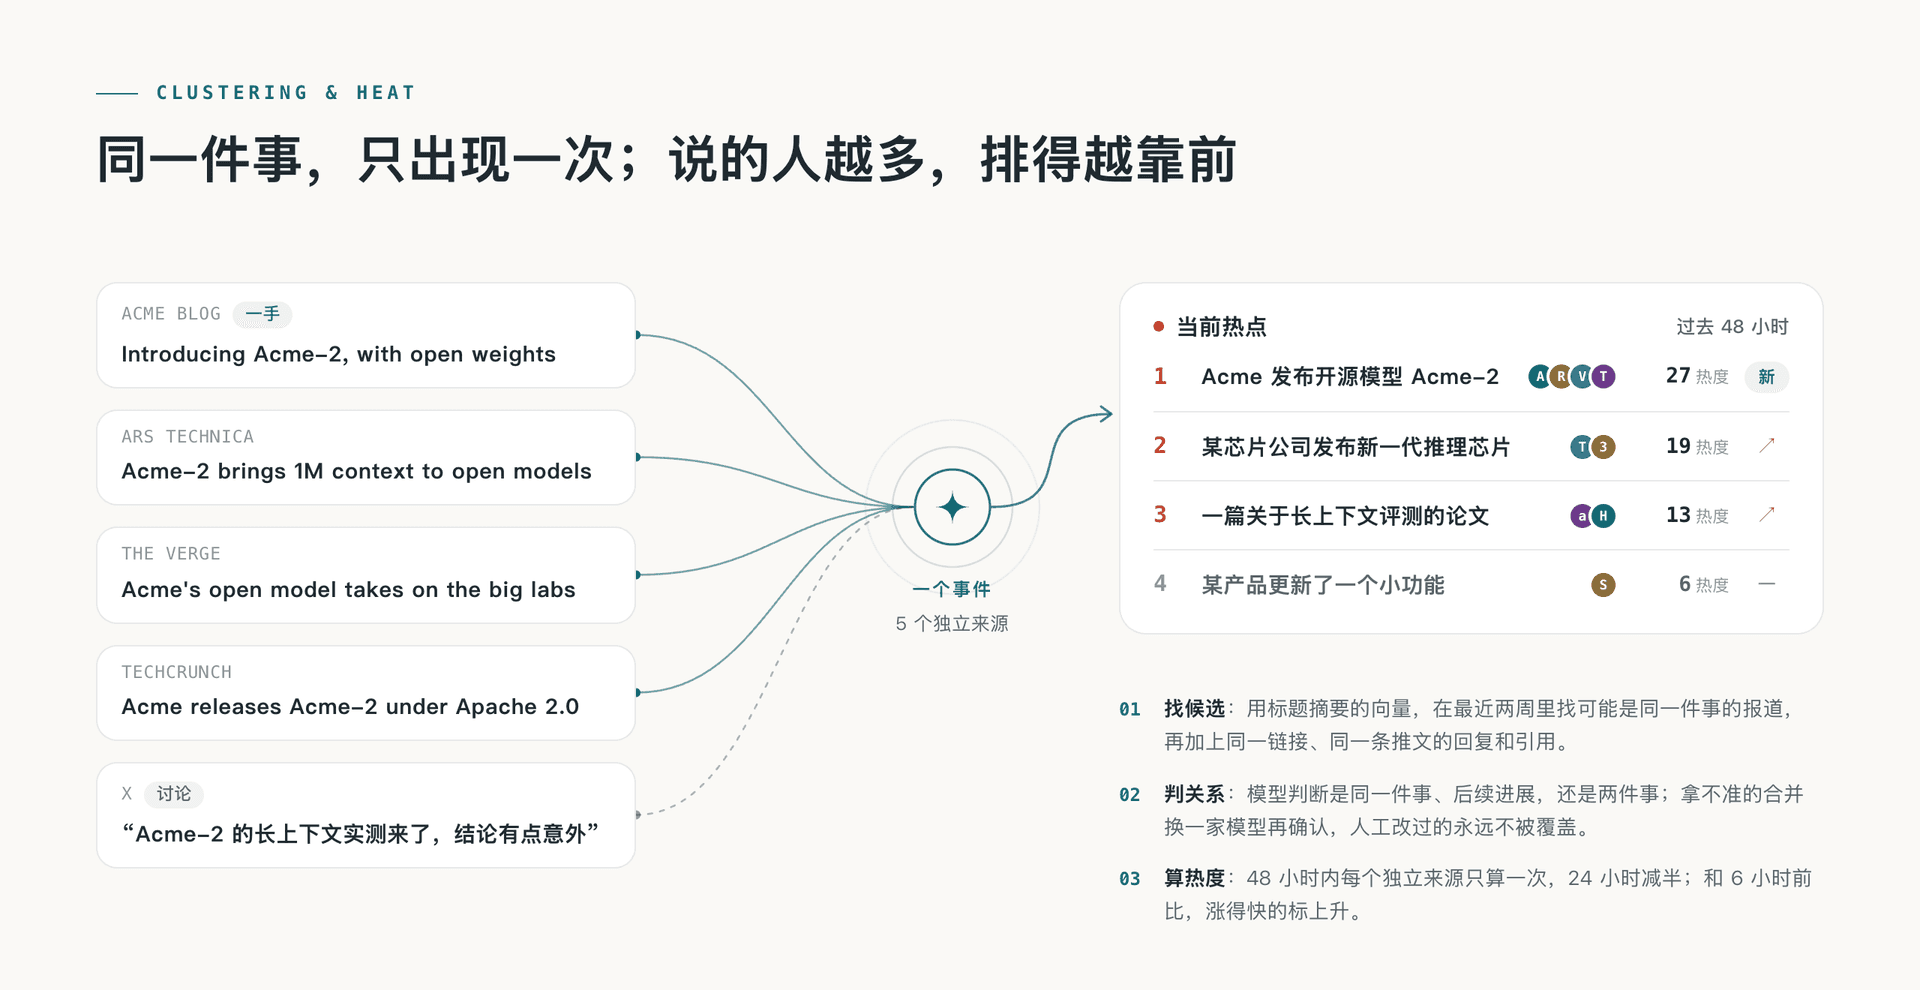
聚簇层先用标题摘要的向量(没配向量服务时降级为文字重合度)在最近两周内找候选,再让模型判断是「同一件事」「后续进展」还是「两件事」;拿不准的合并,写入前再让模型复核一遍,复核环节可以单独换一家模型(GROUP_REVIEW_MODEL)。人工改过的归属不会被覆盖。
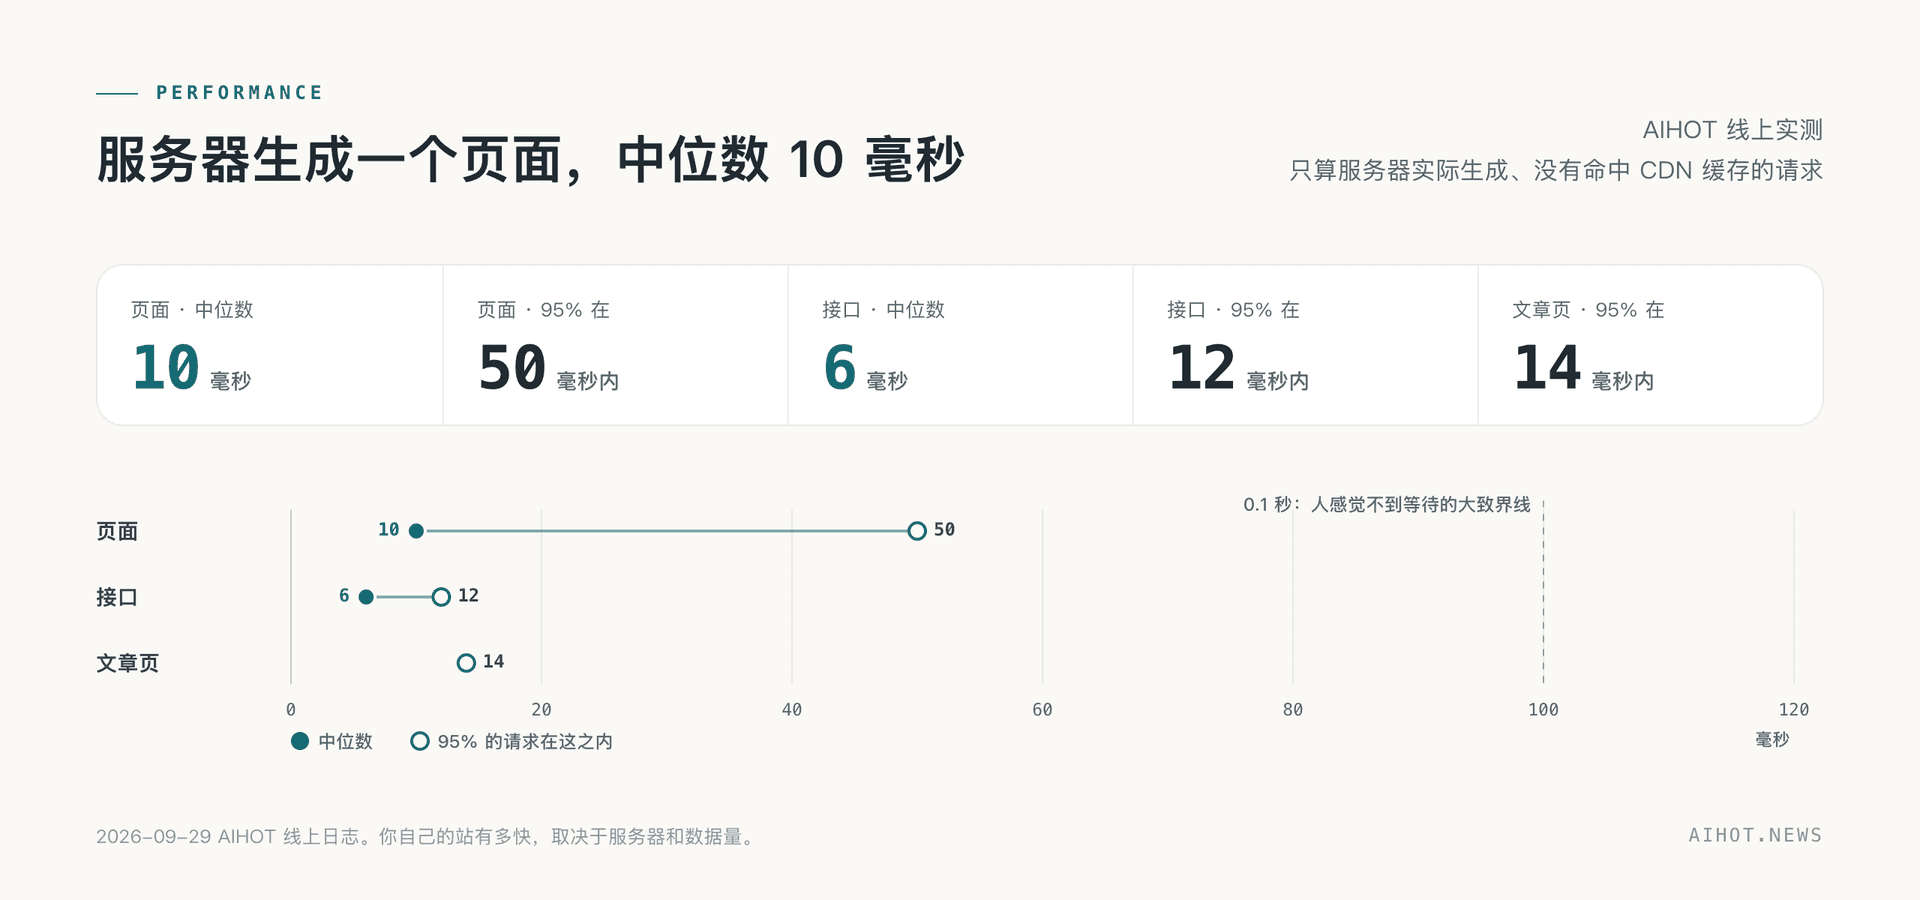
输出层做得相当完整:网页、RSS(精选/全部/全文/日报/周报/月报)、公开 API v1、MCP、Agent Markdown、llms.txt、站点地图、分享图——同一份内容既给人看也给 Agent 用。/openapi-v1.json 直接暴露接口说明。
工程约束也写进了架构文档:页面不调模型(模型只在 worker 任务里调用);花钱的请求先记「回执」再调用,重试时复用已付费结果,不重复花钱(providers/receipts.ts);每个付费服务有每分钟/小时/天上限的预算熔断;缓存不延长旧内容寿命;公开内容匿名,后台只允许管理员。
技术栈:Node.js 24 + TypeScript、React Router 服务端渲染、Fastify、PostgreSQL 17、pg-boss 任务队列、Tailwind CSS、Docker Compose。三进程分离——api(Fastify)、worker(pg-boss 队列与定时任务)、web(SSR,只通过 HTTP 读 api,不碰数据库),业务代码集中在 packages/backend/。
测试与文档:仓库内 184 个测试文件,含 tests/architecture.test.ts 这样的模块边界检查,也有不依赖数据库的 test:standalone 套件。文档有 7 篇专题(部署、架构、定制、信源、精选校准、归组评测、综述评测),外加给 Agent 用的 AGENTS.md。
这是一个没有 CLI 的 Web 应用项目,上手路径完全围绕 Docker:
git clone https://github.com/KKKKhazix/AIHOT.git myhot
cd myhot
node scripts/init-env.ts --llm-key <你的模型 API Key>
docker compose up -d --build
打开 http://localhost:3000,后台在 /admin,管理员密码在 .env 的 ADMIN_PASSWORD。一两分钟后开始有内容,第一次导入的资料大约半小时处理完。
前置条件有三项:Docker、Node.js 24(跑 init-env 生成配置要用)、一个 OpenAI 兼容的模型 API Key(DeepSeek、千问、智谱都行)。默认按 DeepSeek 配置,换厂商改 LLM_BASE_URL、LLM_MODEL、LLM_EXTRA_JSON;用推理模型还要设 LLM_REASONING_TOKENS 留出推理额度。
值得一提的工程细节:Dockerfile 是单镜像多角色(setup/api/worker/web 共用一个镜像,用 command 区分),build 阶段用 ARG NPM_REGISTRY 支持切换到 registry.npmmirror.com——这是给中国大陆服务器准备的。docker-compose.yml 里带 caddy profile,一条命令就能加 HTTPS。
不改代码的行业定制路径同样清晰:把仓库丢给 Claude Code 或 Codex,说一句「把这个站改成 XX 行业的热点站,我关心的是……」,然后让它跑 npm run typecheck、npm test 和 node scripts/smoke.ts。要改的东西集中在 site/(站名文案、出刊时间、品牌)和 industry/(分类、信源、提示词、门槛)两个目录。
作者在 README 里主动承认:「我不是专业的开发者。」这句话有实际后果,值得认真对待。
第一,维护带宽有限。作者明说 Issue 不一定能很快回复,一年的线上站同时维护多个行业分支并同步上游更新,在实践中很容易失控。虽然仓库有 Discussions 区分问答、想法、创作展示三个区,也有 CONTRIBUTING 规范,但社区治理的成熟度对一个刚开源一个月的项目而言仍是未知数。
第二,它不是通用框架。作者反复强调这是线上引擎的直接导出。这意味着代码里可能残留 AI 行业的历史包袱,通用抽象只做了一半。
第三,成本不可忽视。采集 + 双次评分 + 聚簇 + 复核,每条资料都要调多次模型。「两次独立评分」「写入前再复核一遍」都是用 token 换准确率,付费服务还带预算熔断保护,这意味着小团队部署后可能很快触到上限而被迫降频。README 里也提到 X 抓取、公众号、Jina 都可能产生费用。
第四,信源依赖第三方。RSS 源随时可能改版或失效,X 与公众号的抓取还可能受平台风控影响,仓库给了降级路径(文字重合度替代向量服务),但整体数据质量仍然系于外部信源的稳定。
第五,MIT 协议 + 品牌隔离的双重要求意味着使用者必须自行承担换牌、换文案、换分类体系的工作量。所谓「改造成你的行业」,说到底是把 industry/ 目录下那一整套内容重写一遍。
AIHOT 代表的不是又一个「AI 摘要工具」,而是一次分工的重新划分:过去「判断什么值得看」这件事必须由人承担,而人无法规模化;现在它被拆成了「评分标准」和「执行流程」两部分——标准用提示词写成可读可改的文本,流程用工程固化。
这条路线在 2026 年被反复验证:无论是从模型能力溢出到应用层,还是 Agent Skills 成为新的分发单位,AIHOT 都同时踩中了两个热点——它自己提供了 RSS / API / MCP / Agent Markdown / llms.txt 一整套 Agent 友好出口,甚至作者自己也在 khazix-skills 仓库里给 AIHOT 做了一个可直接安装的查询 Skill。
更值得注意的是它选择的开源姿态:不追求「什么都能干」的通用性,而是明确说「我把火种交给你,行业 KnowHow 你自己写」。8.4k 星、2k fork、半个月涨到近 3000 星的速度说明,垂直行业信息基础设施的需求真实存在,只是此前没有人把「选材标准」也一并开源出来。
对团队而言,这个项目的可借鉴之处可能比代码本身更有价值:当你要给一个垂直行业做内容聚合时,真正需要先回答的问题不是「用什么爬虫」,而是「你的入选标准写在哪里、能不能被别人看见、能不能被校准」。AIHOT 把这个问题的答案做成了 29 个 Markdown 文件。
