
colibri
JustVugg/colibri加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个场景:你的同事兴冲冲地想在自己那台没有独显的旧笔记本上跑一个 744B 参数的前沿大模型。你几乎可以预见对话的走向——"买张 5090 吧""租个集群吧""还是用 API 吧"。这是过去两年所有人对本地大模型的共识:模型必须装得进显存,否则一切免谈。
然后你把 colibri 的 README 翻到最上面那一段,它的回答只有一句话:"Tiny engine, immense model."(小引擎,大模型。)
这不是营销话术,而是这个项目在 2026 年 7 月 1 日创建之后四个月内冲到 46,689 星、5,390 fork 的原因——它登上 GitHub Trending 104 天,最高峰时排到全站第一,30 天内新增 7,200 星,平均每天 239 星,一度成为 GitHub 上最被 star 的 C 语言项目之一。
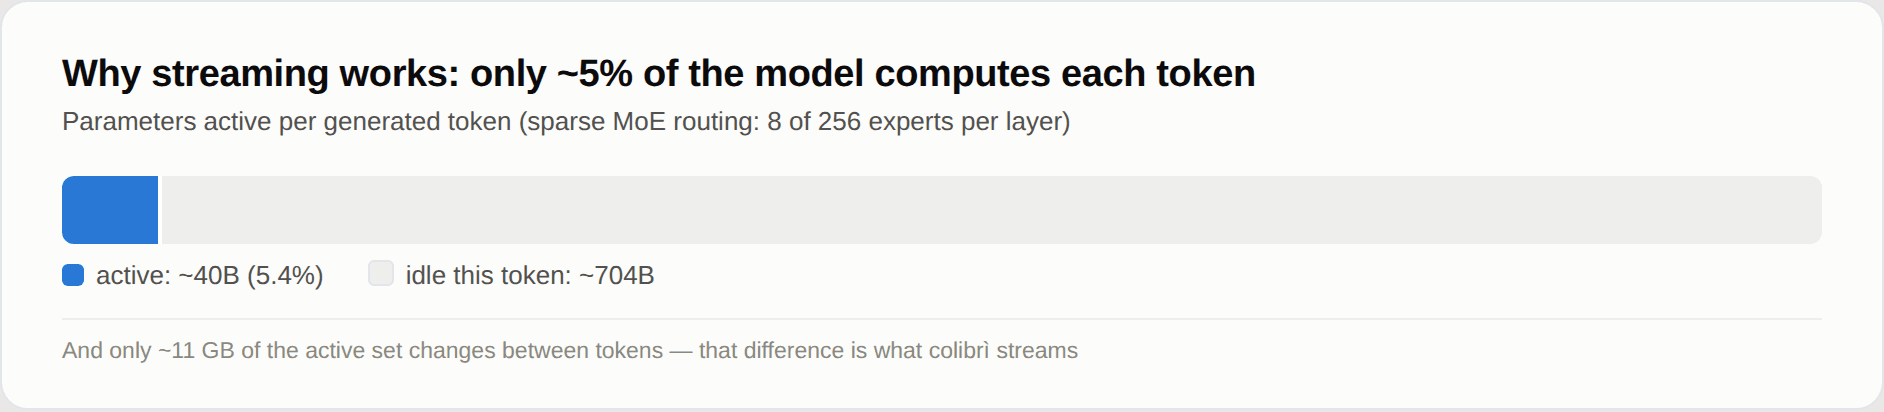
要理解 colibri,先要理解混合专家(MoE)模型的一个特性。以 GLM-5.2 为例:它有 744B 参数,但每个 token 实际只激活约 40B。而真正随 token 变化的,是那些"路由专家"(routed experts),大约 11 GB。
colibri 的核心洞察是:模型不需要"装进"内存,它需要被"安置"(placed)。
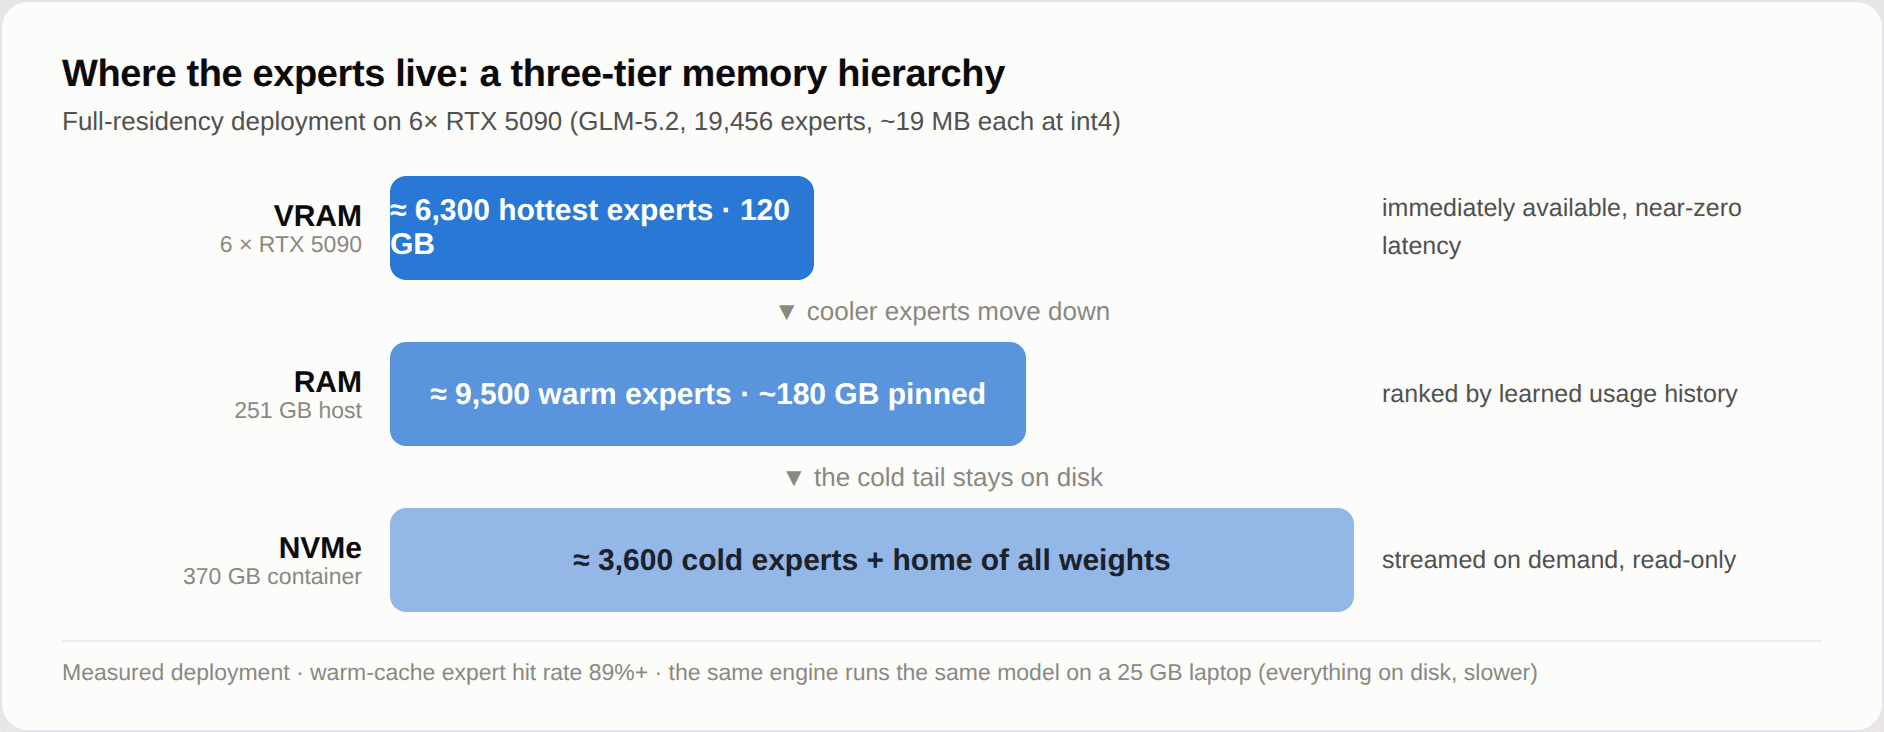
colibri 把显存、内存、NVMe 当成同一套"三级存储层次"来调度,权重放在哪一级只影响速度,不影响模型本身的精度和路由决策——这一点是它的设计红线,README 里写得很明确:更少的内存可以更慢,但绝不能悄悄改变模型的行为。
如果你习惯用别的东西来类比:ollama、llama.cpp 是"把整个模型压缩进一个能塞进显存的盒子";colibri 则是"把图书馆搬进你家,索引放在手边,常看的书放书架,罕见的书从地下室取"。后者更慢,但能搬进原来搬不进去的书。
项目主体是 C 写的(1300 万行字符级别的 C 代码,530 个 .c/.h/.cu 文件),运行时不依赖任何第三方库——没有 BLAS,没有 Python 运行时,没有 ggml。Python 只出现在三个地方:安装脚本、启动器、模型转换器和 API 网关。
这条路线的好处非常直接:没有依赖地狱,没有版本冲突,编译出来就是全部。作者自己的说法是,引擎小到任何人都能测量它、改进它。
代价是所有的东西都要自己写:SIMD 量化内核、CUDA kernel、Vulkan 后端、Metal 后端、投机解码、MTP 头、路由热度的预取策略、GGUF 解析、内存规划器。仓库里有 337 个文档文件、693 个测试与基准文件,c/tests/ 目录下摆满了各种 bench_*.c 和一致性对比脚本。
十三个引擎同时在跑,覆盖 GLM-5.2/5.3、GLM-5.3-Flash、Kimi K3(2.8T)、DeepSeek V4 Flash(284B)、DeepSeek V4.1 Flash(552B)、MiMo-V2.6 Flash/Pro、Qwen3.8-Flash-Next、Qwen3.6、Qwen3-Coder、OLMoE、Qwen-Image-2.1(画图),外加三个决策模型(Laya、GLiNER2.5-Decide、Clef)。也能直接读现成的 GGUF 文件,从 IQ1_S 到 BF16、MXFP4,不重新量化。
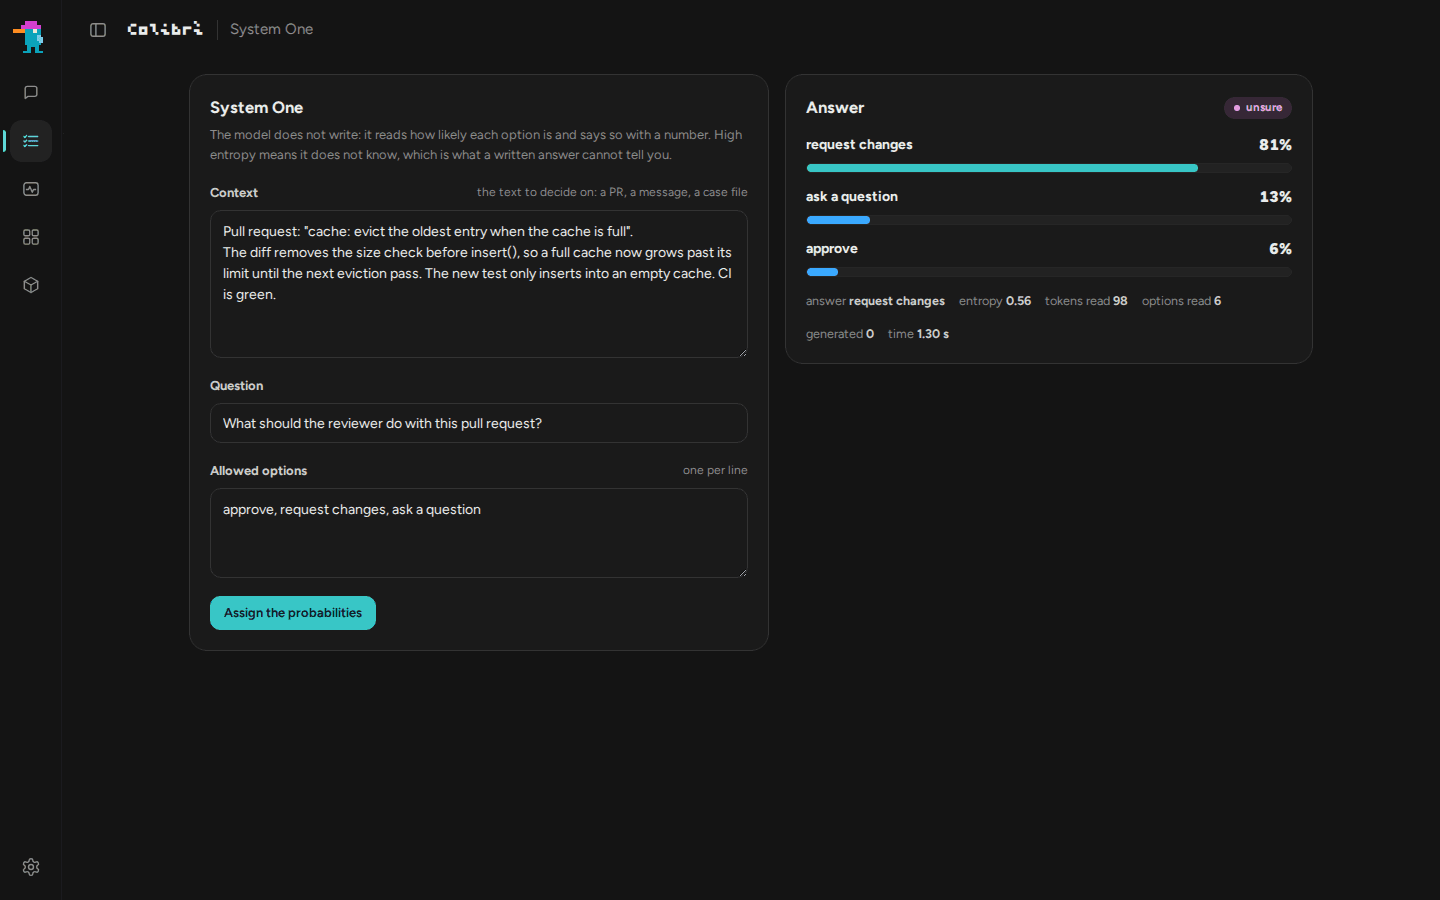
/v1/chat/completions、/v1/completions、/v1/models,支持流式、JSON 模式、stop 序列、logprobs;/v1/messages,所以 Claude Code 和 Anthropic SDK 可以直接连;/v1/systemone 给定状态和封闭选项,返回每个选项的概率和置信度,不生成文本。文档里提到,在 Qwen3.6 上,对同一份文档问四个问题的速度比生成同样答案快 5.7 倍;coli serve --kv-slots N 最多 16 个会话并行解码;coli mcp 暴露硬件检测、模型推荐、安装、启停等工具;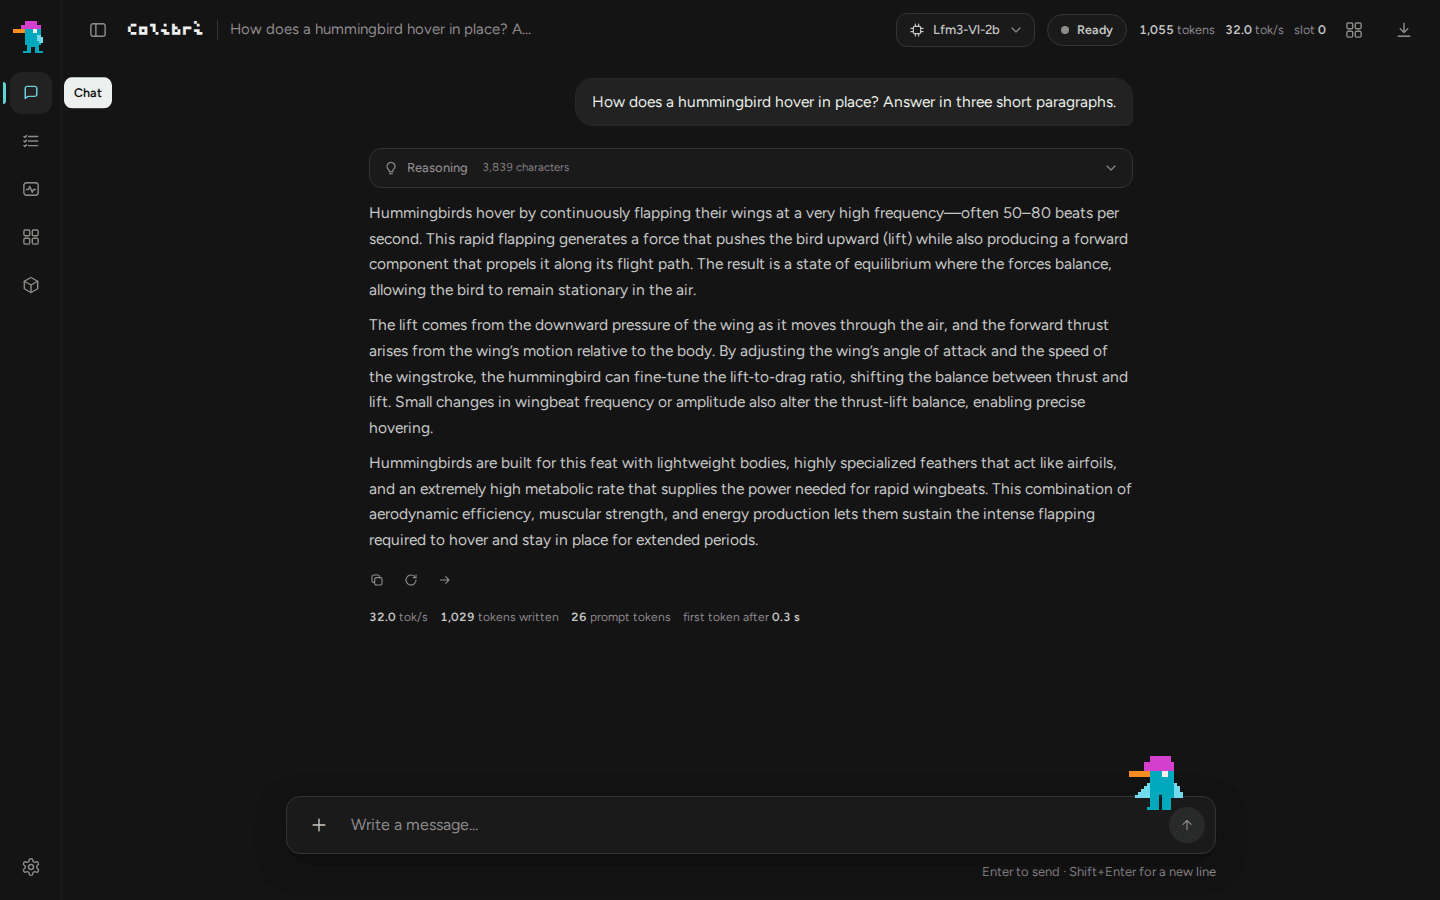
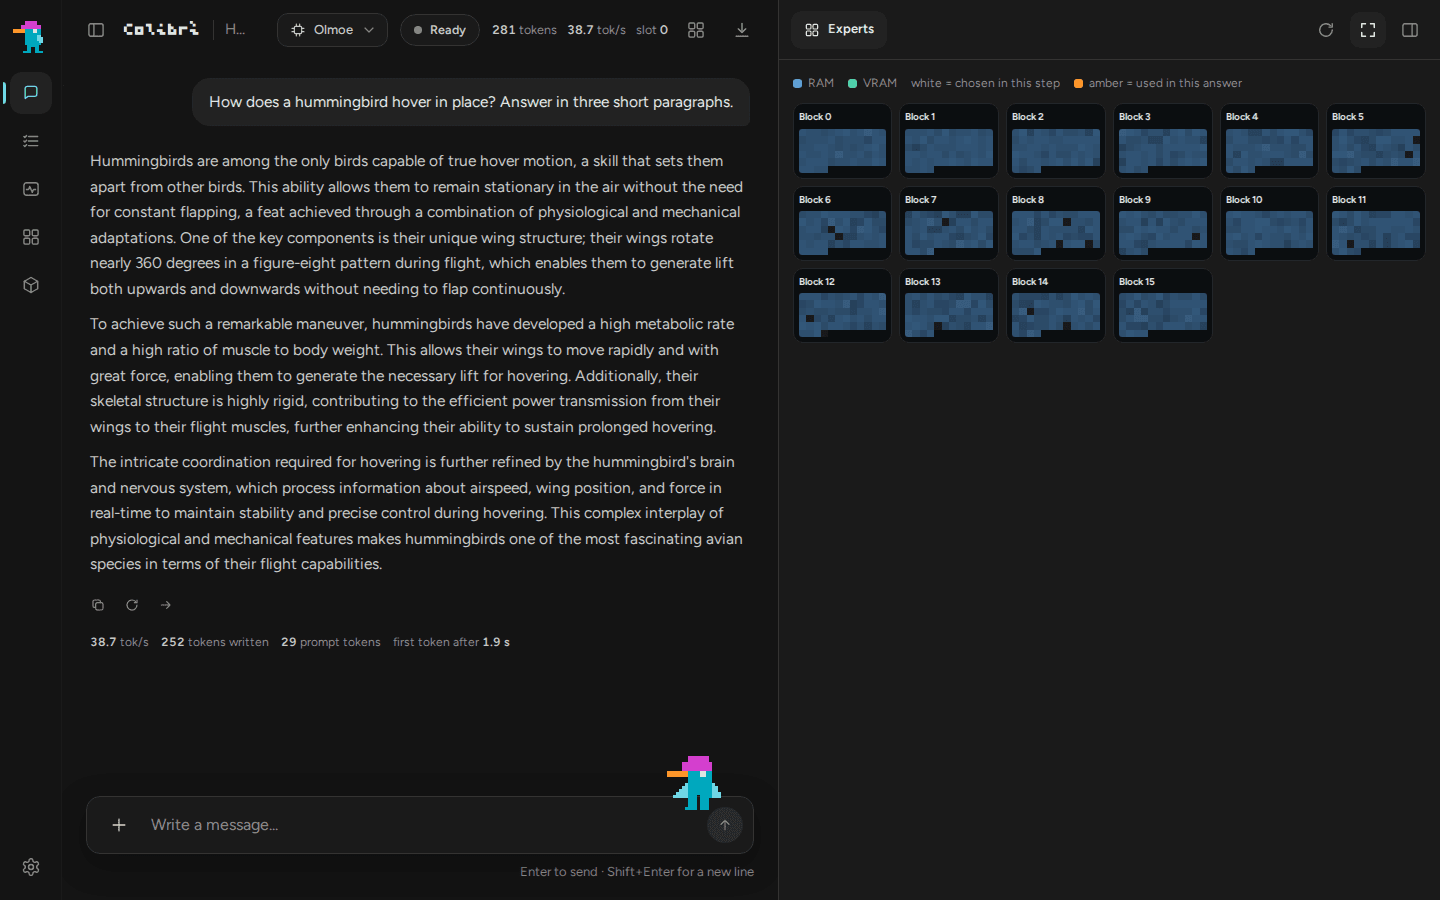
仪表盘是这个项目最有说服力的部分——它把"专家路由"直接画出来,你能看到每个专家在什么时候被点亮,热力图式的 Brain 视图、Profiling 页面按阶段拆解每一轮耗时。跑 OLMoE 时,16 个 block 每个 expert 一格,当前步选中的是白色,本轮用过的变成琥珀色。
安装体验做得相当克制。Linux 上三行命令,Windows 上双击 START-HERE.bat,macOS 上先 brew install libomp。脚本会自己探机器(内存、磁盘、CPU、GPU),然后推荐一个装得下的模型,缺什么包就打印准确的安装命令然后继续用 CPU 跑,模型下载支持断点续传。
但甜头是有代价的——你要先把模型搬回家:
| 模型 | 下载量 | 最低内存 | 实测速度 |
|---|---|---|---|
| Qwen3.6-35B-A3B | 23 GB | 10 / 20 GB | CPU 6.0 tok/s,CUDA 30.0 tok/s |
| DeepSeek V4 Flash | 167 GB | 16 / 32 GB | CUDA 1.5-1.6 tok/s |
| GLM-5.2 | 429 GB | 16 / 24 GB | 6×RTX 5090 上 9.0-9.2 tok/s |
| Kimi K3 | 1.56 TB | 32 / 64 GB | 约 9.4 秒/token |
坦白讲,GLM-5.2 在 25GB 内存的笔记本上冷启动只有 0.05-0.1 tok/s——比人阅读还慢。它的价值在于"可跑"和"可研究",而不是"日常对话够快"。docker/README.md 里作者自己也很诚实:低配机器上测出来是 0.01 tok/s。
容器化两条路:docker/Dockerfile 是单阶段、进去 git clone 源码现场编译;docker/Dockerfile.slim 是多阶段构建,产出纯运行时镜像,模型通过 -v /nvme/glm52_i4:/model:ro 挂进去,compose 文件直接给了 COLI_RAM、shm_size: 2gb 这类细节——都是踩过坑的痕迹。模型目录千万别放网络挂载,专家流式读取是延迟敏感的。
colibri 代表的趋势可以概括为:推理侧的竞争重心,正在从"模型有多大"转向"模型怎么放"。 当稀疏化让模型参数规模膨胀到 T 级别,硬件却没跟上,一个新的学科出现了——权重放置(weight placement)。colibri 用三级存储层次、路由热度驱动的 JIT 式权重迁移、异构协同计算,给出了目前最完整的开源答案。
它的实验方法论也值得注意:任何优化要进默认路径,必须有可复现的端到端测量支撑,且"默认策略绝不静默改变模型精度或路由语义"。这在充满"benchmark 刷分"风气的大模型生态里,是一种稀缺的态度。
对一个中国团队来说,colibri 的意义还在于它是极少数从零手写底层推理引擎、并且愿意把每一个 token 的路由、每一次内存搬运都摊开给人看的中文作者项目。它的贡献者里有 218 次提交的 ZacharyZcR、156 次的 monotophic,也有中国的 rudycelekli(139 次)。
从 2026 年 7 月 1 日创建,到 10 月 31 日发布 v2.1.0,仓库里有 2,530 个 PR 合并记录。四个多月,20 个 release,13 个引擎,46,689 颗星。
小引擎,大模型。 这句话的分量,要等你真的在凌晨三点的旧笔记本上,看着 429GB 的模型一字节一字节从 NVMe 流向内存的时候,才算读懂。
项目地址:https://github.com/JustVugg/colibri | Apache-2.0 | 最新版本 v2.1.0(2026-10-31)
