
Chisle
JayPokale/Chisle加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:Chisle 项目 Logo,一个面向 AI 编程智能体的效率插件
你有没有发现,Claude Code 这类工具越用越"话痨"?它写 130 行代码的时候,你真正需要的可能只有 40 行;它跑一条 grep,返回 8000 行日志,整段原封不动塞回上下文,然后下一轮再为这些内容付一次费。到了月底,账单比项目本身还刺眼。
Chisle(作者 Jay Pokale,2026 年 6 月底建仓)就是冲着这个问题来的。它不是又一个"提示词技巧合集",而是一套可安装、可测量、跨智能体的工程化方案。截至 2026 年 10 月,它已收获 700 Star、50 Fork、9 位贡献者,MIT 协议,npm 包名就叫 chisle,版本迭代到 3.8.1。
Chisle 的起点和这个领域大多数项目不一样。2026 年 6 月,作者把自家项目喂给 AI 编码助手,得到一个"标准答案":一个订单状态机,包含 Enum、自定义异常类、完整类型标注、逐方法 docstring、文件写入,外加一套测试框架——125 行,1342 个回答 token。
然后他把需求原样丢给加了 Chisle 规则的模型。对比结果几乎是行为艺术:同样的功能,只剩 54 行、450 token,状态转换逻辑用一个字典加一个校验方法表达完事。行为一致,token 少了三分之二。
这个对照实验后来演变成 Chisle 的核心资产——仓库里存着 benchmarks/results/ 下逐格原始记录(raw cells),不是结论,是可以被任何人重新计算的证据。这一点在当下的 AI 工具圈里极其稀缺。
大多数"省 token"工具只做一件事:把模型说的话变短。Chisle 的独特之处在于同时切三刀。
第一刀是输出侧的措辞。 Chisle 的 skills/chisle/SKILL.md 规定得很具体:丢掉冠词、填充词、寒暄与对冲语气;因果关系写成箭头(X → Y);技术术语、函数名、报错字符串逐字保留。关键约束是"简洁 ≠ 残缺"——所有决定性事实(修复方案、坑点、注意事项、原因)必须保留,只砍围绕事实的词。
第二刀是输出侧的代码。 项目提出一条"效率阶梯",让模型在写代码前自问七个问题:这事需要存在吗?代码库里已有吗?标准库能做吗?平台原生能力覆盖吗(如用 CSS 代替 JS、用数据库约束代替应用代码)?已装依赖能解决吗?一行能写完吗?——只有到第七级才写"能跑通的最小实现"。阶梯在读完之后运行,绝不代替理解;并且显式豁免安全、信任边界校验、数据丢失防护和无障碍——这些场景下作者主动放弃"偷懒"。
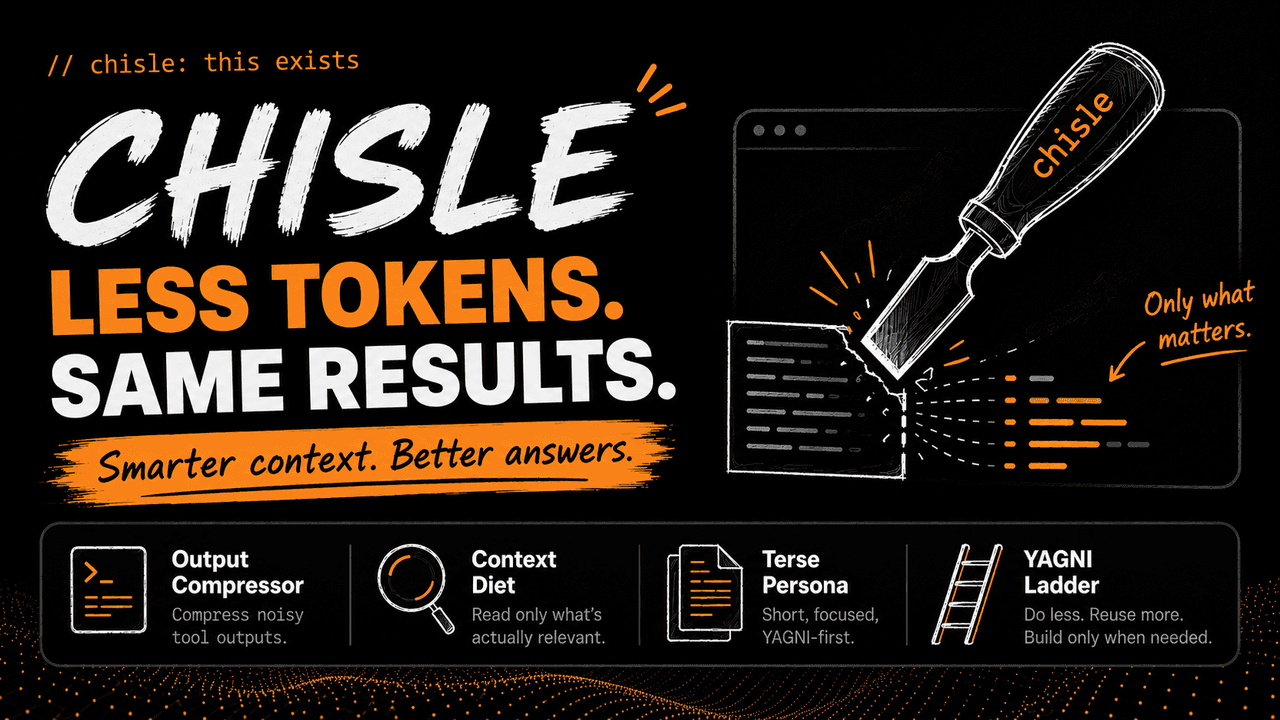
图:项目主视觉,规则集同时作用于输出措辞与代码形态
第三刀是输入侧的上下文。 这是 caveman、ponytail 这类同类工具都没碰过的地带。Chisle 挂了一个 PostToolUse 钩子(hooks/chisle-compress-output.js),在工具结果进入上下文窗口之前动手:超过 1KB 的输出先做无损清洗(去 ANSI 转义、折叠空行、把连续重复行折叠成 [repeated N×]),超过阈值的再"剪头留尾"——保留头部命令上下文、尾部结果与错误,并从被裁掉的中段里抢救出疑似报错行,逐字保留。
这里有两个设计细节值得单独说。其一,Read/Edit/Write 被刻意排除在压缩之外——因为 Read 的输出会喂给后续 Edit 的 old_string 匹配,裁剪它等于让模型对着自己没见过的文本做替换。工具白名单而非黑名单,是刻意的安全设计。其二,整个压缩器是确定性、零 LLM、零网络的纯字符串处理,坏掉的钩子必须抛不出异常,否则会拖垮整条工具链。
npx chisle mcp wrap 则把同一套压缩逻辑推到 MCP 层面:在 Cursor、Windsurf、Cline、Kiro、Gemini、Qwen Code、Copilot CLI 的 stdio MCP 服务器前面架一个代理,只压缩超限的 tools/call 结果,其余字节原样转发。
安装是一条命令:npx chisle。安装器(bin/install.js)纯 Node 标准库实现,会自动探测本机装了哪些智能体并逐一接线——Claude Code 走插件市场、Pi 走包机制、Gemini CLI 走扩展机制、Codex/Copilot CLI/OpenCode 走规则文件追加、Hermes 走 ~/.hermes/skills 的 Agent Skills 标准,Cursor/Windsurf/Cline/Kiro 则在当前目录落下项目级规则文件。--dry-run 预览,--only claude 限定范围,--uninstall 完全回滚。Windows 另有 install.ps1。
Node.js 需要 18 以上,无任何运行时依赖,安装包 2.7MB 上下,不需要 GPU、不需要服务端、不需要数据库——它是一组写进智能体配置目录的规则文件加几个钩子脚本,谈不上"部署",更接近"装个插件"。
代价也很明确。项目自己在 docs/comparison.md 里做了一次相当诚实的数据回撤:2026 年 6 月那个 52% 的漂亮头条被主动作废,因为它依赖单一异常基线,且有四个测试格可能被规则示例"预热"过;去掉这些污染后实际是 70%。2026 年 10 月 12 日的工具关闭重测更直接:Chisle 计费 82%(95% CI 67–104%),caveman 81%,ponytail 127%——三者都没能证明低于裸模型,区间都跨过了 100%。而且每一个方案在 26 格中有 12 到 18 格比"完全不装插件"更贵,主要发生在"本来就没啥可省的短提示"上。规则集甚至会推高模型的隐藏推理量(164%–483%)。
换句话说,Chisle 省下的钱,主要来自第三刀(工具输出压缩,171 个会话实测约砍 46%,OpenCode 上一个 30KB 日志让新鲜输入 token 降了 87%),以及可见回答的变短(裸模型的 56%);而"账单端"的收益在当前数据下并不显著,甚至常常打平。作者把这个叫"backfire",并且专门写了文章解释为什么还坚持发布失败数据——理由是:唯一公开自己会失手的工具,反而是这类工具里唯一能让用户做决策的。
图:官方站点图标,项目配有 Next.js 静态官网 chisle.jaypokale.me
从仓库结构看,Chisle 更像一个小型工程组织而不是一段提示词。1245 个文件里,测试占了 11 个:test_compress.js、test_compress_copilot.js、test_hooks.js、test_installer.js、test_mcp_proxy.js、test_opencode.js、test_pi_extension.js、test_replay.js、test_settings.js、test_tracker.js,另有 fake-mcp-server.js 作为夹具,用 Node 内置 node --test 跑,不引入测试框架依赖。基准目录里连"噪声日志""重复路径"这类故障夹具都备好了。
规则本身由 scripts/build-rules.js 生成,--check 模式可在 CI 里校验生成物是否与源码同步;scripts/build-chart.js 负责出图。CI 徽章是绿的,CHANGELOG 按 Keep a Changelog 格式逐版本记录,每个版本都能看到具体 PR 号。
有意思的是作者把 AI 协作写进了署名:"Built by Jay Pokale with Claude, Antigravity, and Codex as co-engineers",README 里还专门有 "AI co-engineers" 区块,注明配对工作记录在 commit trailer 和 changelog 里。这种透明度在开源项目里不多见。
MIT 协议,最短的那一种。项目由 caveman(简洁措辞)和 ponytail(懒惰资深工程师的代码规则)合并演化而来,两者的 MIT 声明保留在 NOTICE 里——这个溯源做得很干净,没有回避出身。
隐私方面几乎无风险:压缩器是本地纯字符串处理,不发任何网络请求,不调用任何 LLM,规则集与钩子全部落在本机用户目录。唯一外部交互是安装时的包下载与可选的官方站点访问。
把 Chisle 放进行业视角看,它标志着 AI 编程工具竞争的重心正在从"能力上限"转向"单位任务成本"。同期出现了一堆同族项目——caveman、ponytail、rtk,以及各类 token 优化器。第三方评测给这些工具的读数相当冷淡:有人在 48 个 Django 任务上测五个省 token 工具,宣称 60–90% 的节省全部没站住,最好的一位只省了 31.6%,其余落在 6%–15%;JetBrains 的评测里,caveman 广告 -65% 实测 -8.5%,ponytail 广告 -54% 实测 -15%。
这些第三方读数与 Chisle 自己 2026 年 10 月的"82%、不显著"结论其实是互相印证的。这恰恰是 Chisle 最有价值的地方:当一个赛道的宣传数字普遍虚高时,唯一拿出可复算原始数据、并主动作废自己最好看的那版数据的项目,就成了这条赛道的度量衡。
值得注意的是作者也承认,独立第三方复现目前仍然稀缺——他重测竞品时用的是对方已安装的插件,样本仍是自己设计的提示词集合。要把"省 token"从营销话术变成工程指标,接下来需要的是跨项目、跨模型、盲测的统一基准。
适合:每天在 Claude Code / Pi / Cursor 里跑真实工程任务的开发者与团队,尤其是能接受"AI 少写但需要自己复核"的工作方式;对 MCP 工具输出膨胀感到肉疼的人收益最直接。
不适合:只写一次性小脚本、上下文本来就短的用户——这类场景 Chisle 自己测出来就是打平甚至更贵;以及期望"装完立刻看到账单下降"的用户,输入侧压缩需要会话量积累才会显现。
数据来源:GitHub API(repo JayPokale/Chisle,2026-10-23 采集,700 Star / 50 Fork / 9 贡献者 / MIT)、仓库 docs/benchmarks.md 与 docs/comparison.md 基准文档、benchmarks/results/ 原始记录。
