
llmaz
InftyAI/llmaz加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:凌晨两点,你终于调试好了一个 LLM 服务的 YAML 配置文件,apply 之后却发现 Pod 卡在 Pending 状态——GPU 不足、端口冲突、推理引擎版本不兼容,三座大山同时压过来。这就是当前 LLM 部署的真实写照:模型本身可能只有 10GB,但让它在生产环境稳定运行,需要跨越的工程鸿沟远不止文件大小。
llmaz(发音 /lima:z/)正是为解决这个痛点而生。它是 InftyAI 团队推出的 Kubernetes 原生 LLM 推理平台,目标是让任何拥有 K8s 集群的人——无论你是创业公司 AI 团队,还是高校实验室——都能用最少的配置将大模型跑起来。
LLM 推理不同于传统的 REST API 服务,有几个独特的工程挑战:
第一,GPU 资源调度复杂。 不同模型对显存需求差异巨大——从 1GB 的 facebook/opt-125M 到 400GB+ 的 Llama-3-405B,需要动态分配 GPU 而非静态配额。
第二,推理引擎碎片化。 vLLM 适合 Throughput 优先的场景,TGI 在 Function Calling 场景更稳定,SGLang 对结构化输出有优化……每个引擎各有优劣,没有银弹。
第三,多副本水平扩展困难。 LLM 推理是有状态的——多副本之间需要协调权重版本、分片路由,否则同一对话两次请求可能落到不同版本模型上,输出完全不一致。
llmaz 的出现,就是要让这些底层复杂性对用户透明。
llmaz 的使用体验被设计得非常简洁。以部署 facebook/opt-125m 为例,用户只需要写两段 YAML:
# 定义模型
apiVersion: llmaz.io/v1alpha1
kind: OpenModel
metadata:
  name: opt-125m
spec:
  familyName: opt
  source:
    modelHub:
      modelID: facebook/opt-125m
  inferenceConfig:
    flavors:
      - name: default
        limits:
          nvidia.com/gpu: 1
# 定义推理 Playground
apiVersion: inference.llmaz.io/v1alpha1
kind: Playground
metadata:
  name: opt-125m
spec:
  replicas: 1
  modelClaim:
    modelName: opt-125m
Apply 两行,kubectl port-forward 暴露服务,就能通过标准 OpenAI 格式 API 调用。整个过程不需要写 Dockerfile,不需要配置推理引擎,llmaz 会根据模型特性自动选择最合适的 backend。
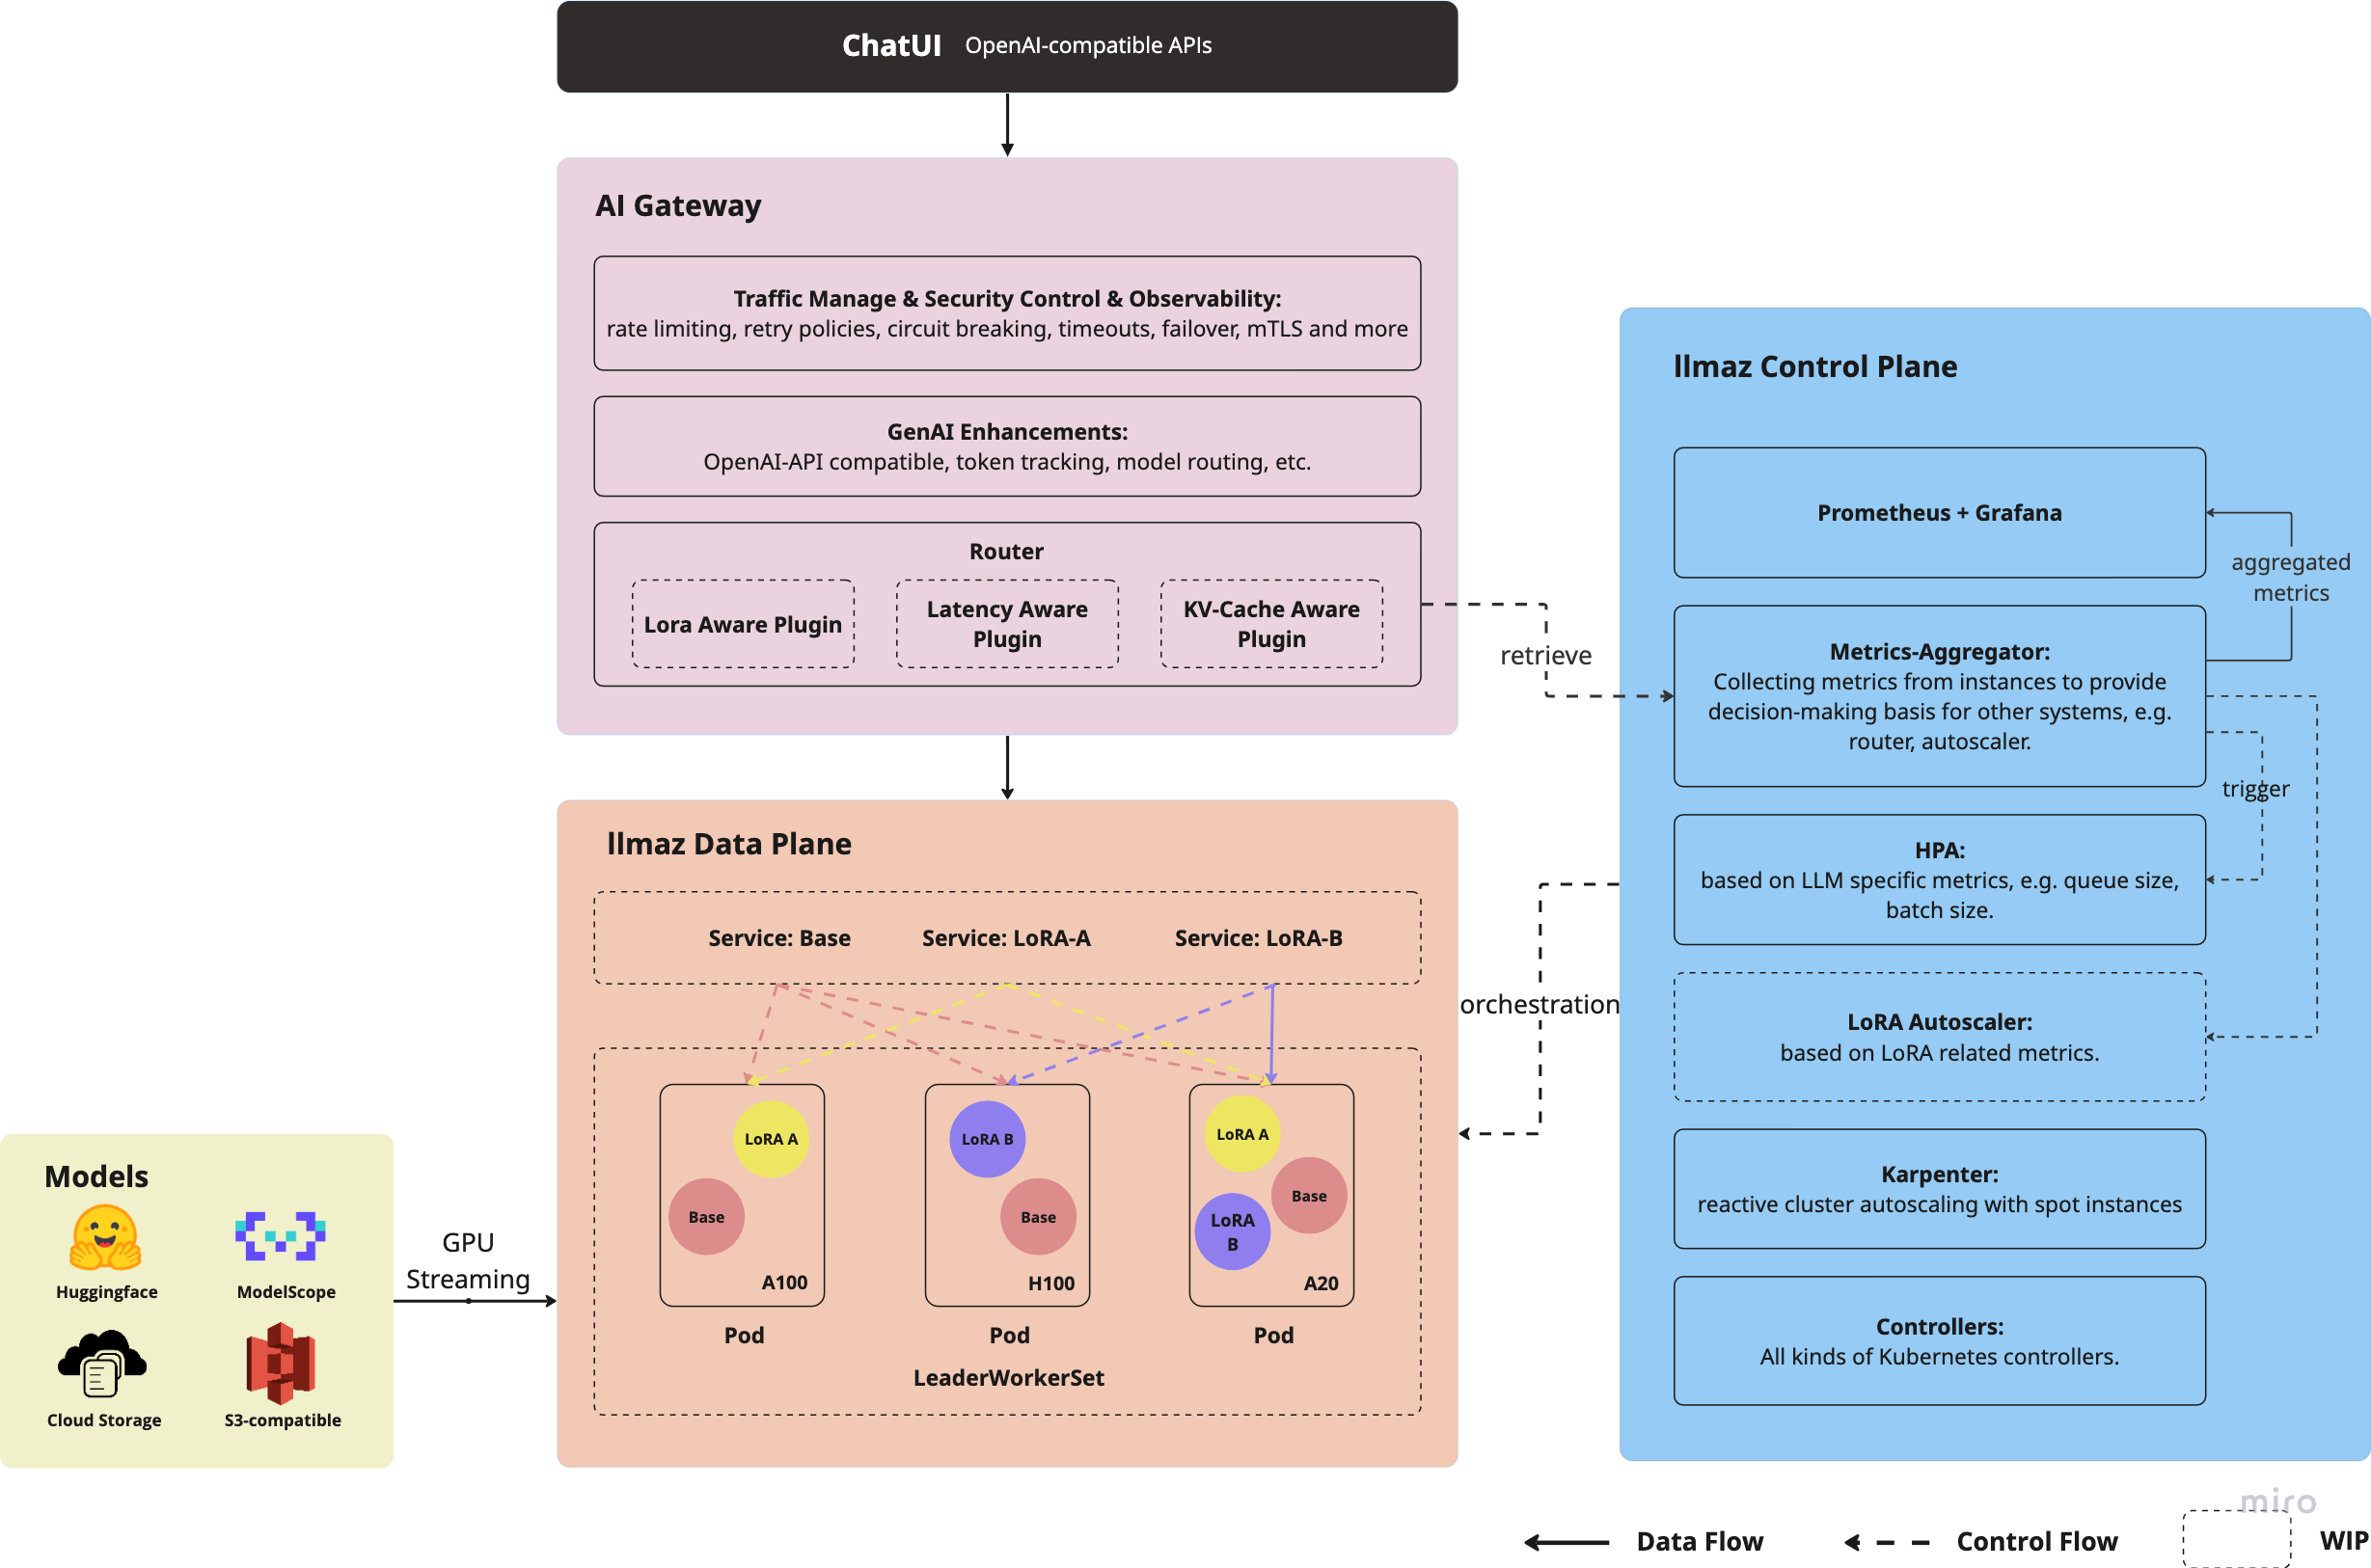
llmaz 的架构设计值得细看。它采用了 Kubernetes Operator 模式,在控制平面定义了三个核心 CRD:
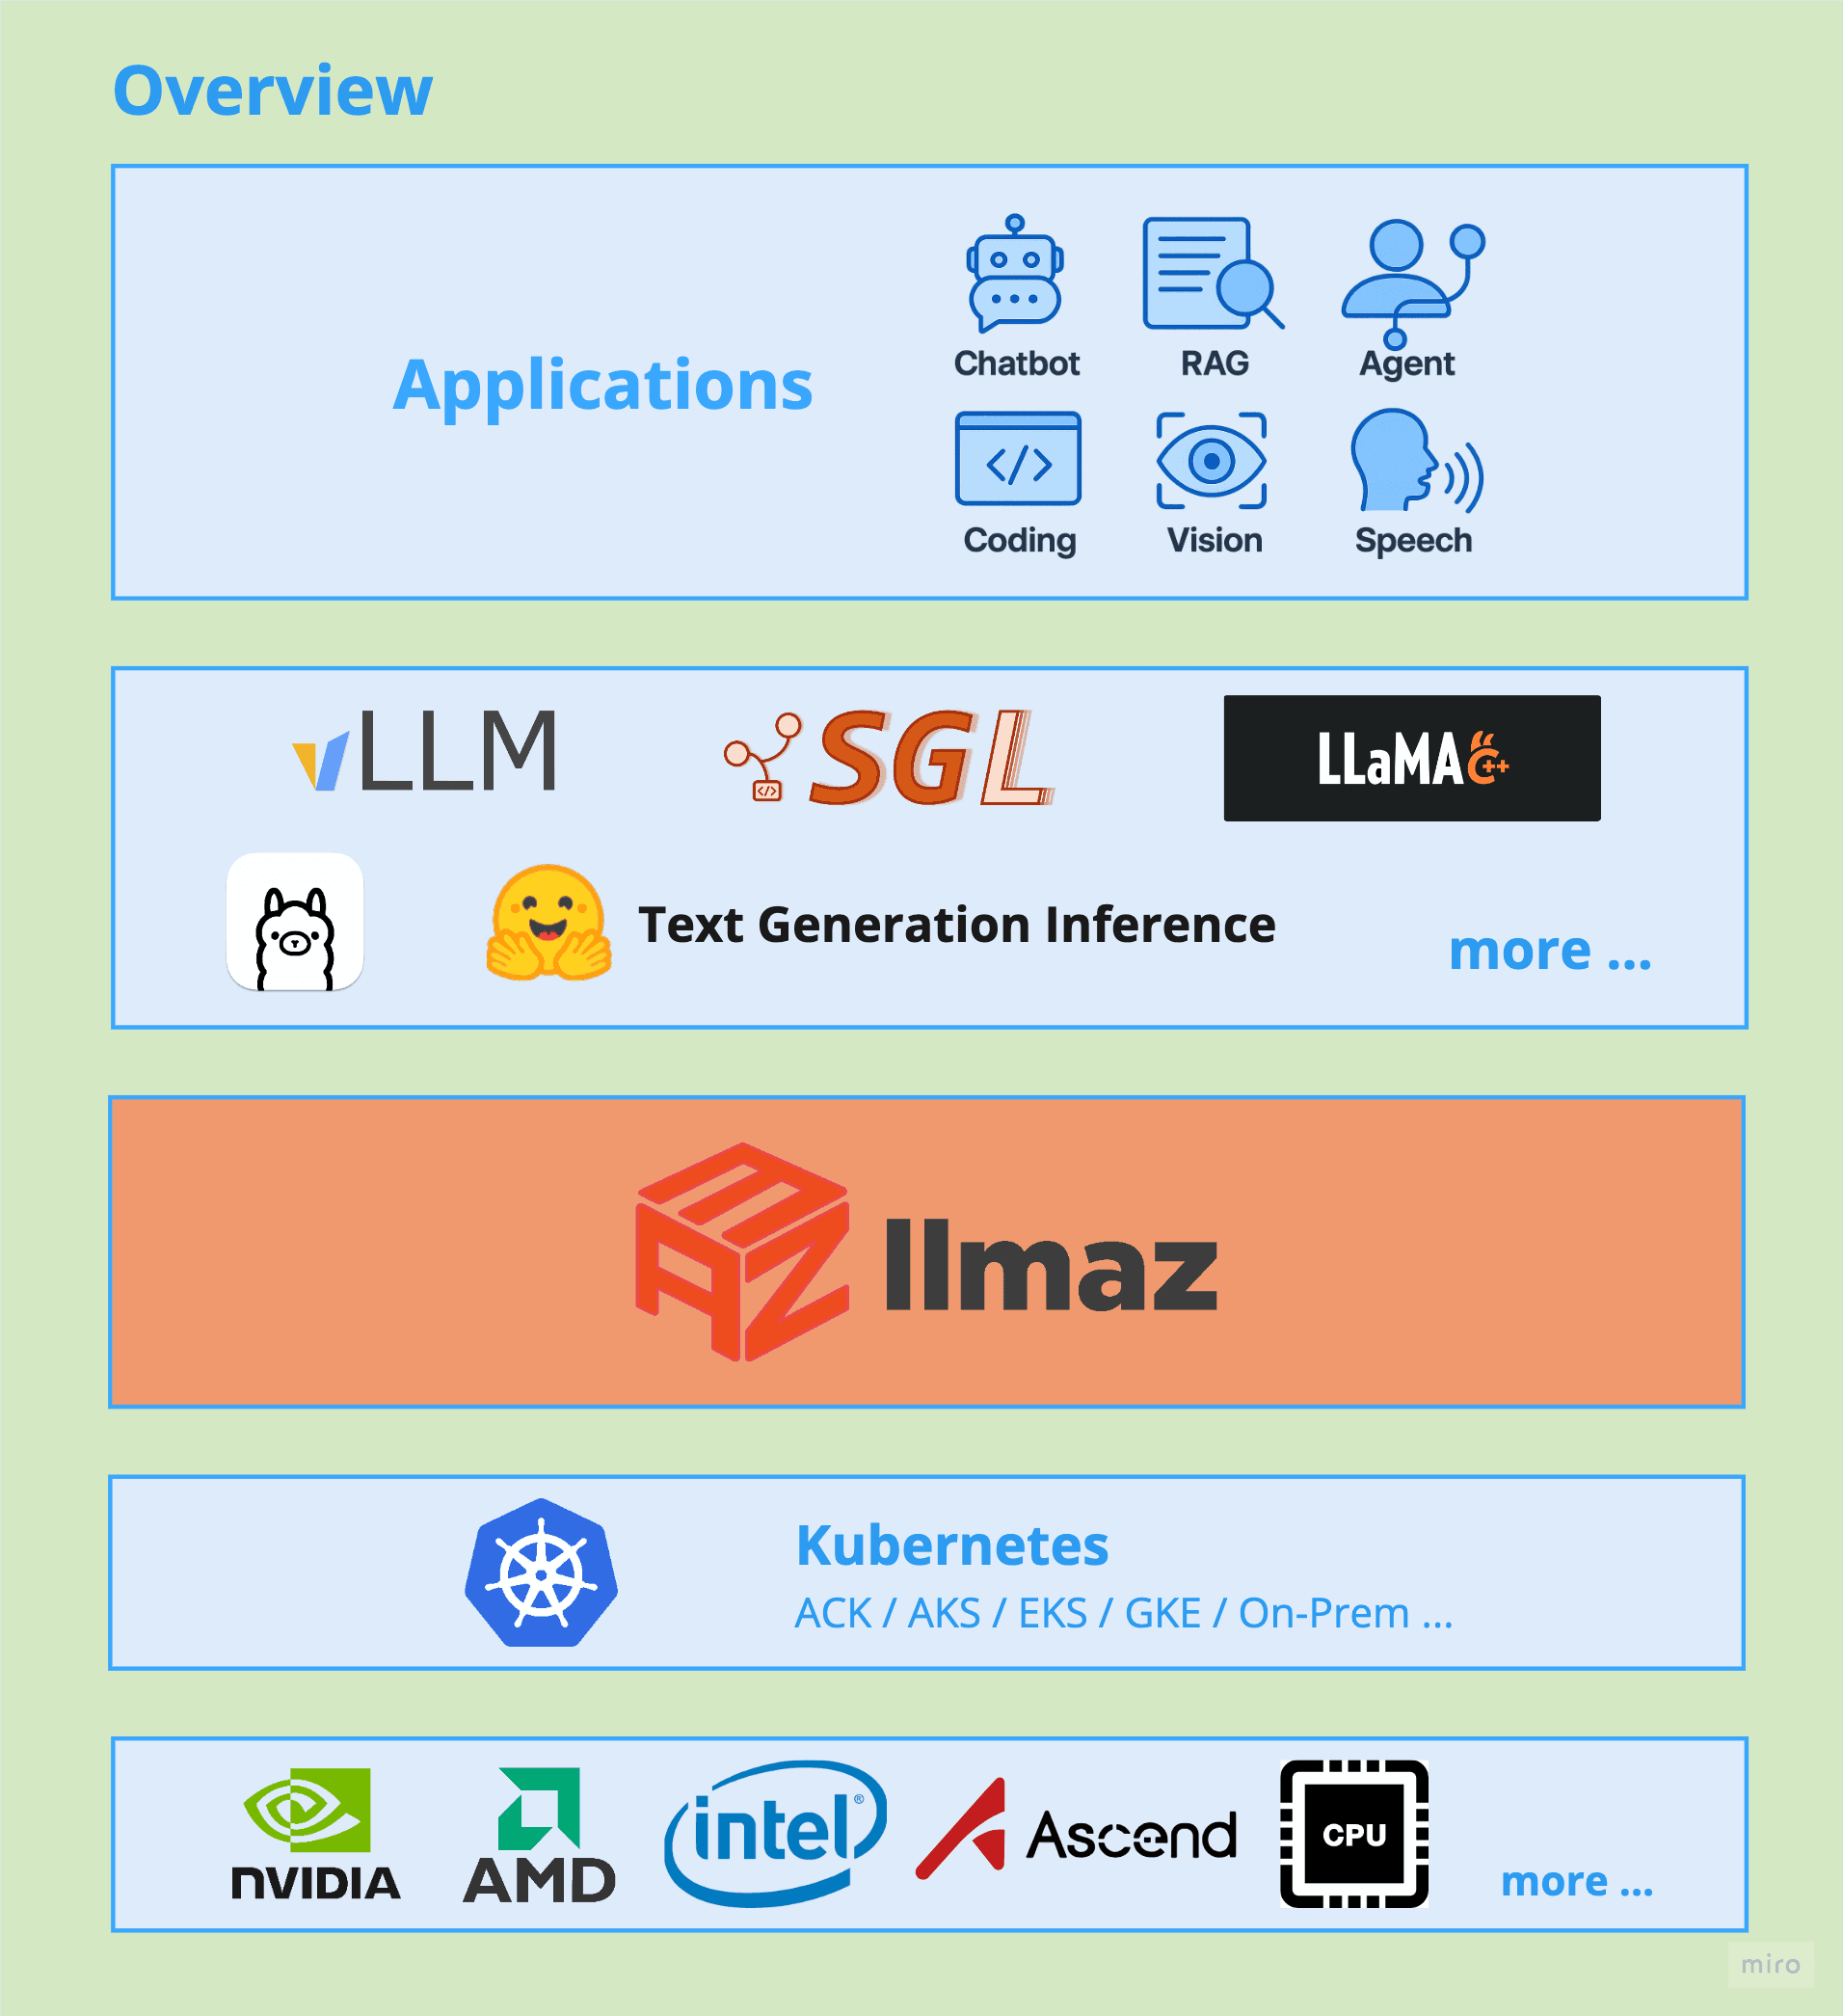
在执行层面,llmaz 不绑定单一推理引擎。它内置支持:
| 推理引擎 | 适用场景 | 特点 |
|---|---|---|
| vLLM | 高吞吐批量推理 | PagedAttention,吞吐极高 |
| TGI (Text-Generation-Inference) | Function Calling / RAG | Transformers 原生支持 |
| SGLang | 结构化输出 / Agent | RadixAttention,前缀缓存 |
| llama.cpp | CPU / 边缘推理 | 无 GPU 也能跑小模型 |
| TensorRT-LLM | 极致性能优化 | NVIDIA 官方优化 |
通过 InferenceBackend CRD,用户甚至可以同时部署多个引擎版本,对比同一模型在不同 backend 上的表现。
llmaz 还有一个差异化能力——异构 GPU 集群调度。在 InftyAI Scheduler 的配合下,它可以将 Llama-3-70B 的推理负载分配到 NVIDIA A100 和 AMD MI300 混合节点上,用成本更低的 AMD 卡承载部分 Prefill 阶段,NVIDIA 卡专注 Decode。这种精细化的调度策略,对于有多品牌 GPU 资源的团队(尤其是超算中心)极具吸引力。
llmaz 深度集成了 Open WebUI,提供了开箱即用的 Web 聊天界面。这个界面不仅支持基本的对话,还支持 Function Calling、RAG(检索增强生成)和 Web Search——这些都是当前 AI 应用的核心能力。
配合 Kubernetes HPA(水平 Pod 自动扩缩容),系统可以根据实际请求量自动增减副本,结合 Karpenter 实现 Spot 实例的动态节点伸缩,真正做到按需付费。
适合谁: 有 Kubernetes 基础的 AI 平台工程师、MLOps 团队、有私有化 LLM 部署需求的企业。
门槛在哪: 虽然 llmaz 大幅降低了部署复杂度,但你仍然需要:
对于完全没有 K8s 经验的团队,仍然有一定学习曲线。
第一,Alpha 阶段,API 不稳定。 项目方明确声明"API may change before graduating to Beta",生产环境直接使用有风险,需要锁定版本号。
第二,对国产 GPU 支持有限。 目前主要针对 NVIDIA CUDA 优化,昇腾、天数等国产芯片需要社区贡献支持。
第三,监控运维体系尚在完善。 虽然集成了 Prometheus 指标导出,但生产级的告警规则、容量规划文档还不够丰富。
llmaz 代表的趋势是大模型推理基础设施的民主化。过去只有大厂才能玩转的 GPU 集群管理、推理引擎调优,正在被 Operator + CRD 的模式标准化。就像 Kubernetes 让微服务部署变得简单,llmaz 正在让 LLM 推理服务变得触手可及。
从 GitHub Star 增长曲线来看,llmaz 处于早期快速爬升阶段,315 颗星虽然不算多,但考虑到它 2024 年才发布、且专注于 K8s 这个相对垂直的赛道,增长势头值得关注。
综合评价: llmaz 是目前开源社区中,Kubernetes 原生 LLM 推理平台里设计最完整的项目之一。如果你已经在用 K8s 管理基础设施,它值得优先评估。
