
RAG-Enterprise
I3K-IT/RAG-Enterprise加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你是某大型律所的 IT 负责人,律师们每天要翻阅成百上千份合同、判例和内部文件,用关键词搜索常常漏掉关键信息,用云端 AI 工具又涉及客户隐私数据不敢上传——这就是 RAG Enterprise 试图解决的真实痛点:让企业既能享受 RAG(检索增强生成)技术带来的智能文档分析能力,又能把所有数据牢牢锁在自家长 Infra 里。
RAG 并不是什么新鲜技术,但随着大模型能力爆发式增长,一个新问题浮出水面:企业真的愿意把核心商业机密、机密法律文书、病人病历上传到第三方 API 吗?答案在大多数受监管行业里都是否定的。
欧盟 GDPR、中国《数据安全法》、美国 HIPAA 等法规让数据跨境传输成为高风险操作。与此同时,Ollama、Qdrant 等开源工具的成熟,使得"全本地化 RAG"的技术门槛大幅下降。RAG Enterprise 正是踩在这个时间节点上出现的作品——作者 Francesco Marchetti 来自意大利 I3K Technologies 公司,专注于服务受监管行业的信息安全需求。
RAG Enterprise 的核心理念是"零配置上线"。用户只需三步:
git clone https://github.com/I3K-IT/RAG-Enterprise.git
cd RAG-Enterprise/rag-enterprise-structure
./setup.sh standard
安装脚本会自动完成 Docker + Docker Compose 配置、NVIDIA/AMD GPU 驱动适配(根据硬件自动选择 CUDA 或 ROCm 路线)、Ollama + Qwen3:14b 大模型拉取、Qdrant 向量数据库初始化,以及前后端服务的编排启动。首次部署约需 1 小时(含 embedding 模型下载),400Mbps 网络下可压缩到 15 分钟以内。
系统支持 PDF、DOCX、PPTX、XLSX、ODT、RTF、HTML、XML、TXT、MD 等十余种常见文档格式,内置 Apache Tika + Tesseract OCR 引擎,即使是扫描件也能处理。向量检索基于 BAAI/bge-m3 多语言 embedding 模型,语义匹配能力覆盖 29 种语言——这对多语言法律咨询或国际业务往来频繁的企业尤为实用。
推理层默认使用 Qwen3:14b(Q4 量化,约 10-12GB VRAM),用户也可切换为 Mistral 7B、Qwen3:8b(5GB VRAM)、Qwen3:4b(3GB VRAM)等轻量模型,甚至在纯 CPU 模式下运行 1.7B 模型(1.5GB RAM)。整个推理链路完全不调用任何外部 API,所有计算在本地完成。
从 docker-compose 编排来看,系统分为四个核心服务:
LangChain 在 RAG Pipeline 中负责将用户查询 embedding 化、执行向量相似度检索、组装 prompt 并调用 Ollama 生成答案。权限体系分为三级:普通用户(只读查询)、超级用户(可上传/删除文档)、管理员(用户管理+完整系统配置)。
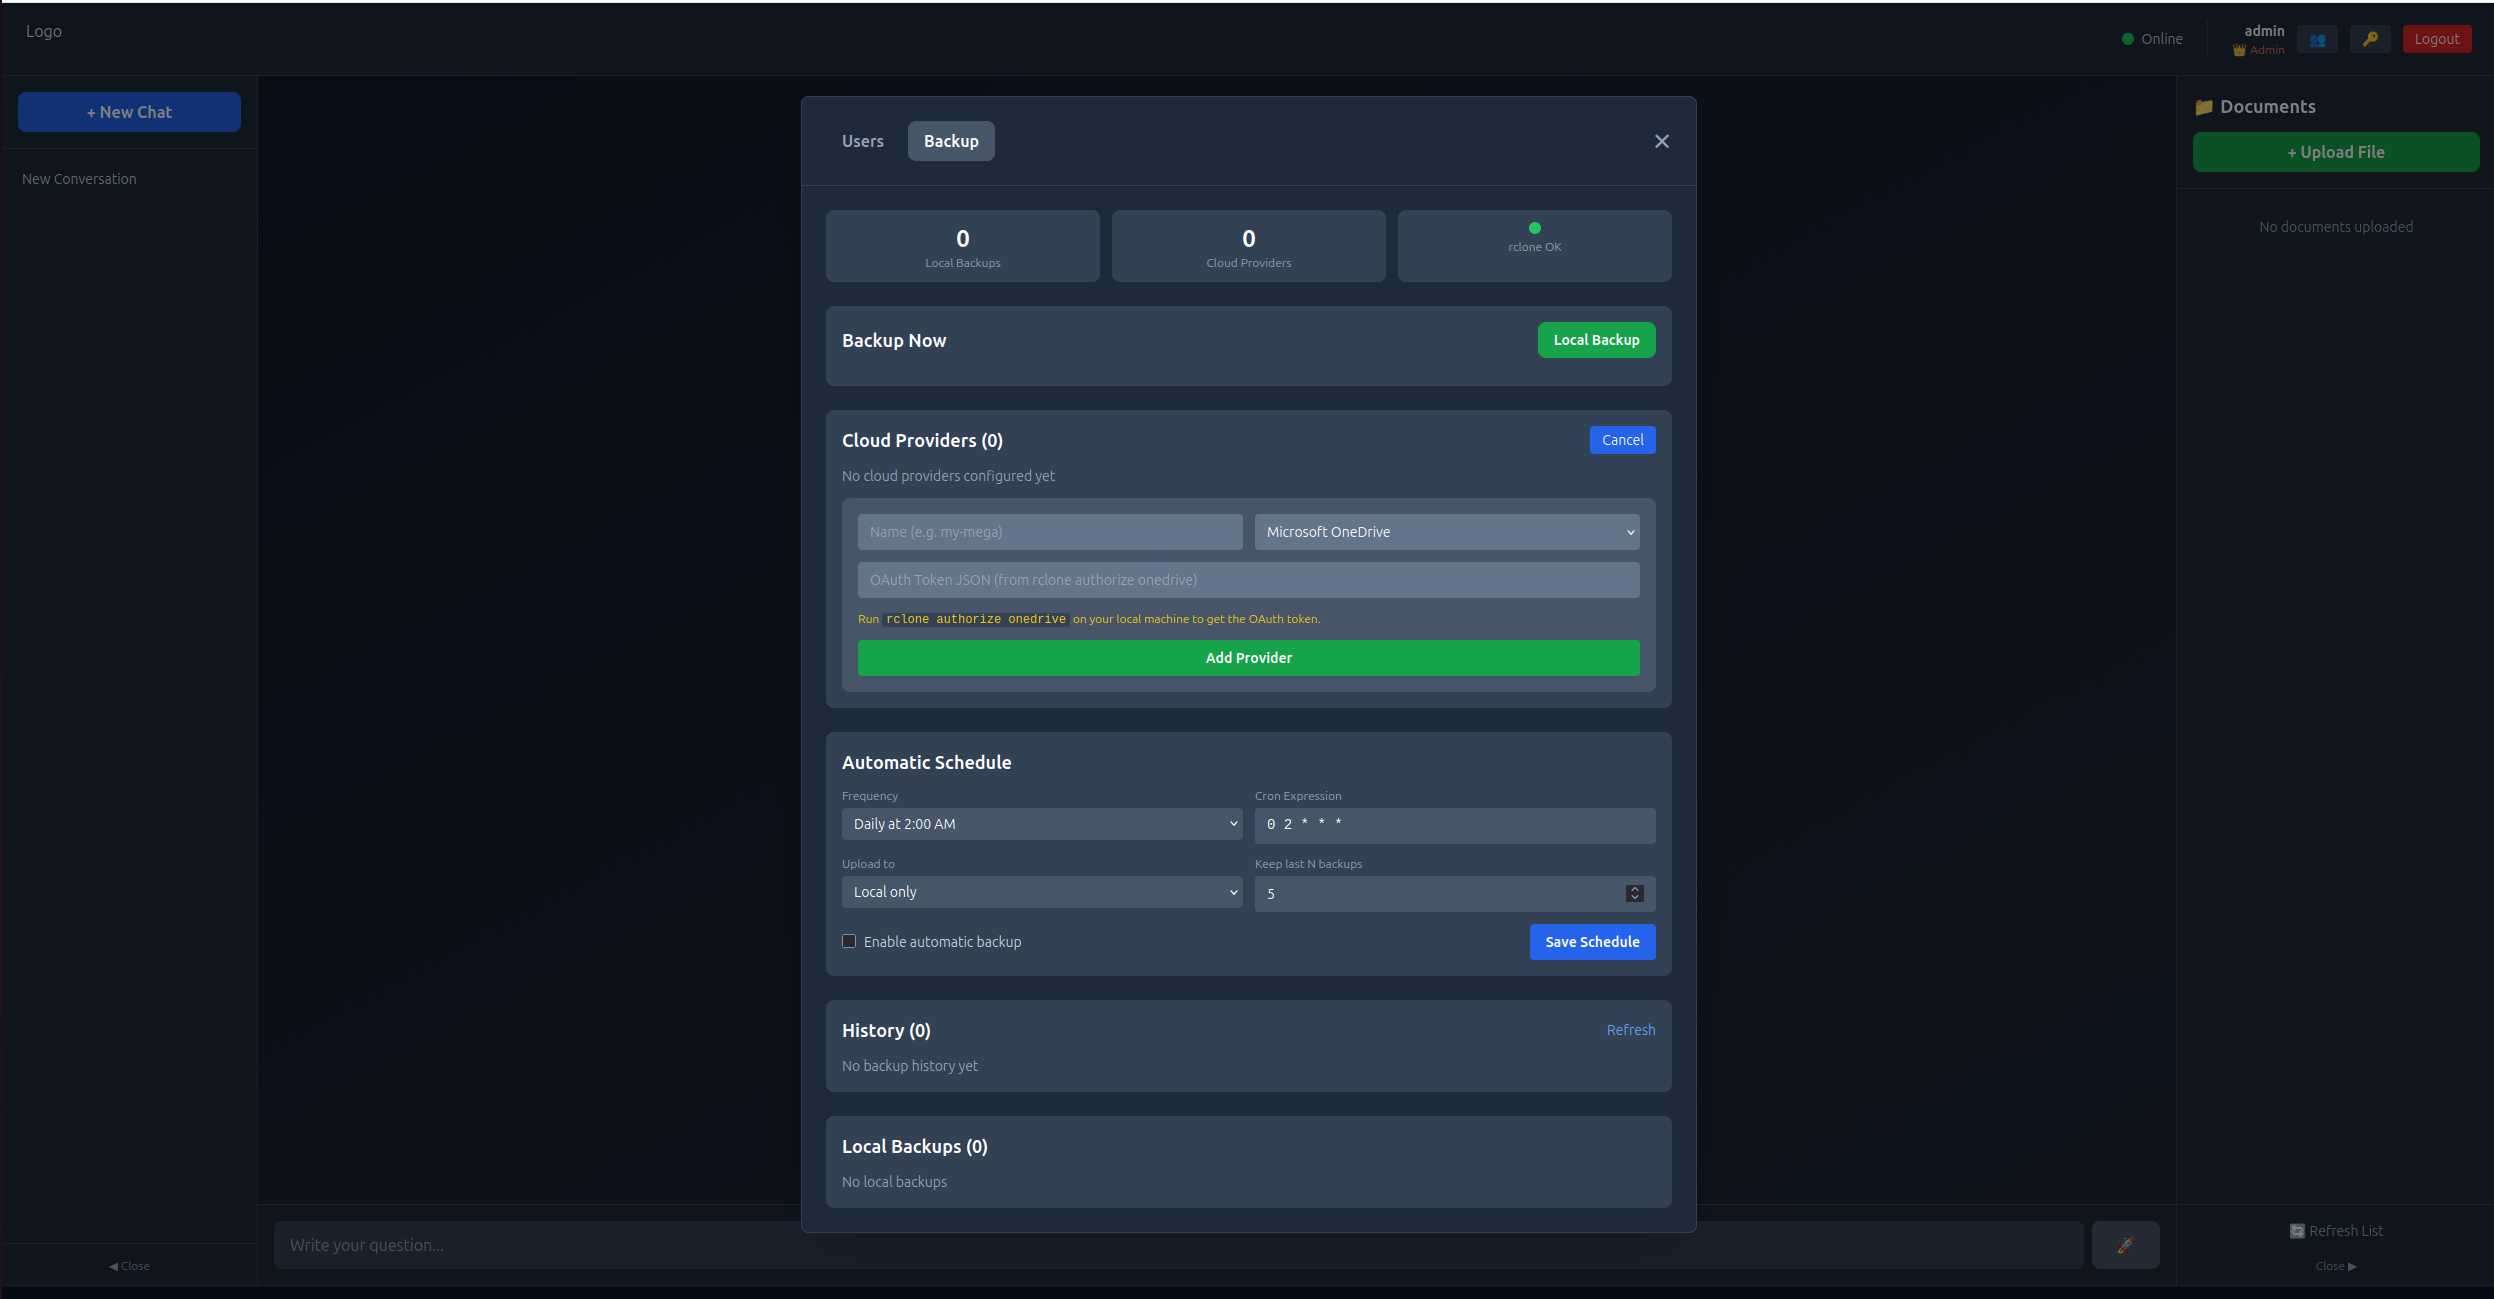
RAG Enterprise 特别值得称道的是其备份系统。作者调研了大量企业场景后发现,很多团队愿意用开源工具,但往往在数据备份这一步栽跟头——没有备份,再好的系统也不敢说生产级。
该系统的备份方案接入了 rclone,支持 Mega、S3/MinIO、Google Drive、OneDrive、Dropbox、WebDAV(Nextcloud)、FTP、SFTP、Backblaze B2、pCloud 等 70+ 云存储提供商。管理员可以在 UI 上直接配置定时备份任务,选择性恢复数据库、原始文档或向量索引,并通过 cron 表达式自定义保留策略。
尽管宣传"一键部署",实际体验中仍有几道门槛需要注意:
硬件门槛不可忽视。虽然没有 GPU 也能运行 CPU 模式,但推理速度会从 80-100 tokens/s 骤降至数分钟出一个答案。实际推荐配置是 NVIDIA RTX 4070 以上(12GB VRAM)或同等 AMD ROCm 显卡。安装脚本在 Ubuntu 20.04+ 上测试最充分,Windows 和 macOS 用户需要额外折腾。
首次启动需要等待。embedding 模型(BAAI/bge-m3,约 2.3GB)会在首次启动时才下载,80Mbps 网络下约需 9 分钟。这期间 backend 容器会显示 "unhealthy" 状态,容易让新用户误以为部署失败。文档里有说明但字体偏小。
AGPL-3.0 许可证的影响。该许可证要求:如果修改系统并以服务形式对外提供,必须开源你的修改版本。对于只是内部使用的企业用户来说无影响,但如果要做二次开发并商业化 SaaS,需要注意合规风险。
RAG Enterprise 的定位是"完整但专注",而非"大而全"。它的局限主要体现在:
不支持分布式部署。当前架构所有服务都是单节点,适合部门级或中小企业使用,但无法水平扩展到百人以上并发场景。
相似度检索精度有限。benchmark 数据(RTX 5070 Ti)显示,事实性查询相似度约 65-69%,概念性问题约 50-62%,复杂分析类约 45-55%。这个水平在业内属于中等偏上,但如果用户期望"精准问答"而不是"相关片段召回",需要结合实际文档质量做 prompt 工程调优。
没有内置评估和反馈机制。系统没有提供 query-answer 对的标注工具或效果评估面板,如果要做持续优化,团队需要自建评估管道。
RAG Enterprise 的出现反映了 2025 年以来一个明确的趋势:本地化 AI Infra 正在从极客玩具走向企业级。Ollama 让本地大模型推理门槛从"专业 GPU 集群"降到了"一块消费级显卡",Qdrant 提供了比 pgvector 更成熟的向量检索方案,而 RAG Enterprise 做的事是把这些组件用一条命令串起来,加上企业级的认证和备份,让非 DevOps 背景的人也能快速上手。
从 GitHub 增长来看,项目目前 57 star,虽然规模不大,但 README 中的 benchmark 数据、Zenodo DOI 引用、多语言文档(29 种)说明作者在认真运营,而非"练手项目"。对于医疗、法律、金融等数据敏感行业,这套系统提供了一个无需依赖任何外部服务的完整 RAG 落地方案,填补了开源生态中的一个真实空白。
如果你正在寻找一个生产级的本地 RAG 原型、或者为受监管行业评估 RAG 落地可行性,RAG Enterprise 值得花两小时亲手跑一遍——它能帮你快速建立一个"数据永远不出门"的基线认知。
