
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你在维护一个客服智能体。上线第一周它答得不错,但一周后你发现:它对退款政策的理解有偏差、对高频问法措辞不敏感、遇到边缘订单会绕圈子。传统做法是——工程师复盘 badcase、手写 prompt、重新跑一轮评测、上线。整个闭环以周为单位,人力成本极高,而且大部分时间花在"发现问题"而不是"解决问题"上。
Reef 要做的事情,是把这条闭环变成一个常驻运行的基础设施:服务请求 → 记录反馈 → 生成更新 → 评估发布。它的自我描述很直接——"Infrastructure for continually self-improving agents"(面向持续自我改进智能体的基础设施)。
Reef(发布名为 reef-infra,导入包名为 reef)由 Human-Agent-Society 社区维护,2026 年 8 月 31 日创建至今约两个月,已积累 7787 star、731 fork、623 次提交、42 位贡献者与 743 个 PR,最新发布版本为 v0.1.3(2026-10-14)。项目采用 Apache-2.0 协议。
理解 Reef 的关键,是先理解它的六个核心概念:
x-reef-agent-record-id 返回,是后续反馈锚定交互的唯一凭证。一句话概括:Reef 把"训练数据管线 + 灰度发布 + 在线服务"这三件通常各自为政的工程活,收敛成了一条可编程的闭环。
Reef 最聪明的设计决策是承认"让智能体变强"有两条路径:
权重演化(Weight training):配合 Slime(THUDM)、SGLang、vLLM 做真实的强化学习/监督微调。需要 GPU 训练栈,产出 checkpoint,评估通过后推理服务热加载新版本。仓库 recipes/ 下的 SAO、SDFT、SDPO、OPD、TTT-Discover、Guidance-TTT 等方法均属此类,对应 IMO AnswerBench、AIME 2024/2025、SciKnowEval、ToolAlpaca 等基准。
骨架演化(Harness optimization):不碰一个权重,只优化智能体的提示词、规则与技能文件树。Reef 把 harness 抽象成 Git 里的文本树,每步由某种 Method 产生候选树,用真实 agent 在任务集上跑评测,胜出的候选即发布为 release。这条路径不需要本地 GPU 训练卡,只需要一个 OpenAI 兼容端点——对多数团队,这才是真正能落地的入口。
值得注意的是,Reef 把 harness 当成一等公民而非附属品:reef/harness/ 有专门的适配器、渲染器与轨迹记录,GET /reef/harness 可直接拉取发布出去的树,每一步改了什么还会在 work/replay.html 里生成可回放的可视化。
从 GitHub 仓库结构看,这是一个规模相当严肃的工程,不是 demo 级别的样例:
docs/site/ 是 Next.js 应用。reef/ 下有 18 个职责清晰的包——core(共享类型与线契约)、dispatcher+scenario(协调、提交顺序、故障恢复)、service(HTTP/鉴权/流式)、recipe+train(策略与训练流水线)、evaluation(候选评估与发布决策)、runtime+surface(服务与制品交付)、inference(引擎适配)、artifact+storage(版本化制品与记录存储)、harness、execution(沙箱)、observability(OTLP 追踪)、tinker。recipes/*(sao、tttd、openclawrl、gepa、meta_harness、ace、reasoning_bank),beta 方法放 recipes/beta/(coral、spade、autoenvscaling、reefine)。硬性约束是 reef/ 下的任何代码都不反向导入方法包,共享契约永不依赖具体集成——这是干净的六边形架构。harbor 提供任务目录的容器化 rollout,另有 E2B、Modal 云沙箱可选。tests/ 目录 624 个测试文件按包镜像布局;有 pre-commit、dependabot 自动合并、RFC issue 模板(架构、公共契约、持久化变更强制走 RFC)、Claude Code 自动 Review 工作流,以及一份 2.2 万字符的 AGENTS.md 供 AI 协作编码使用。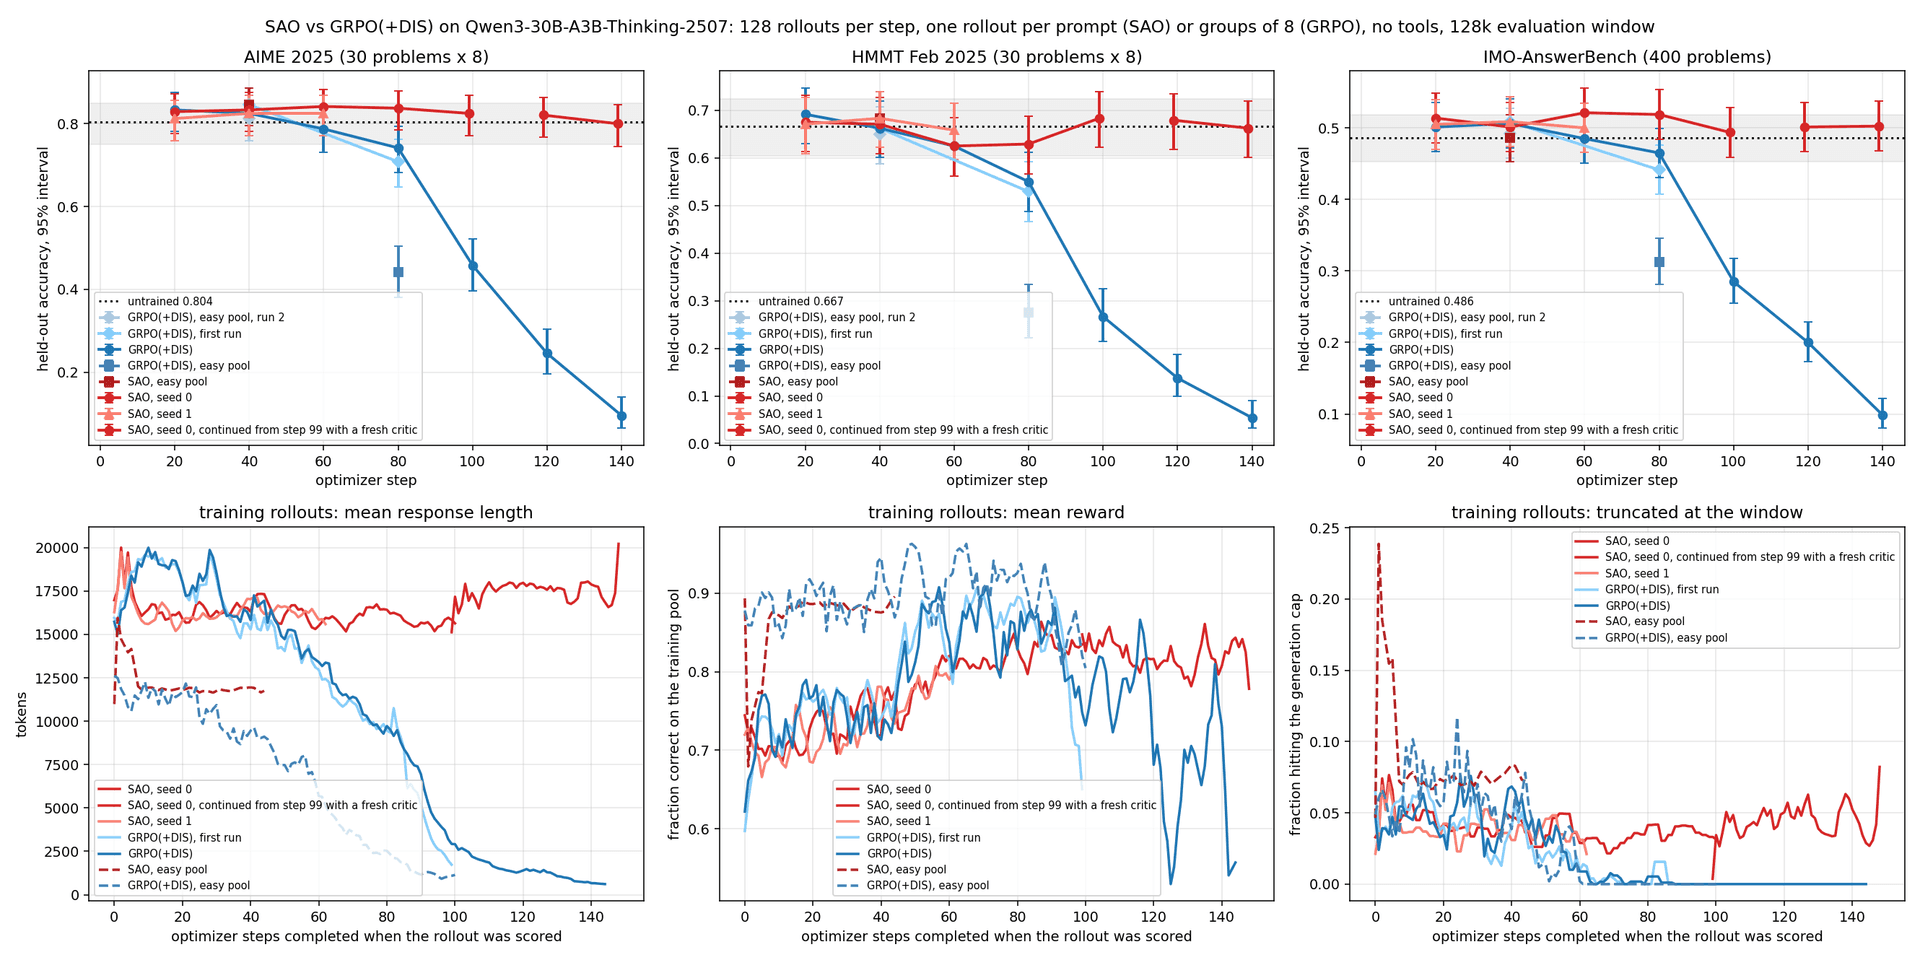
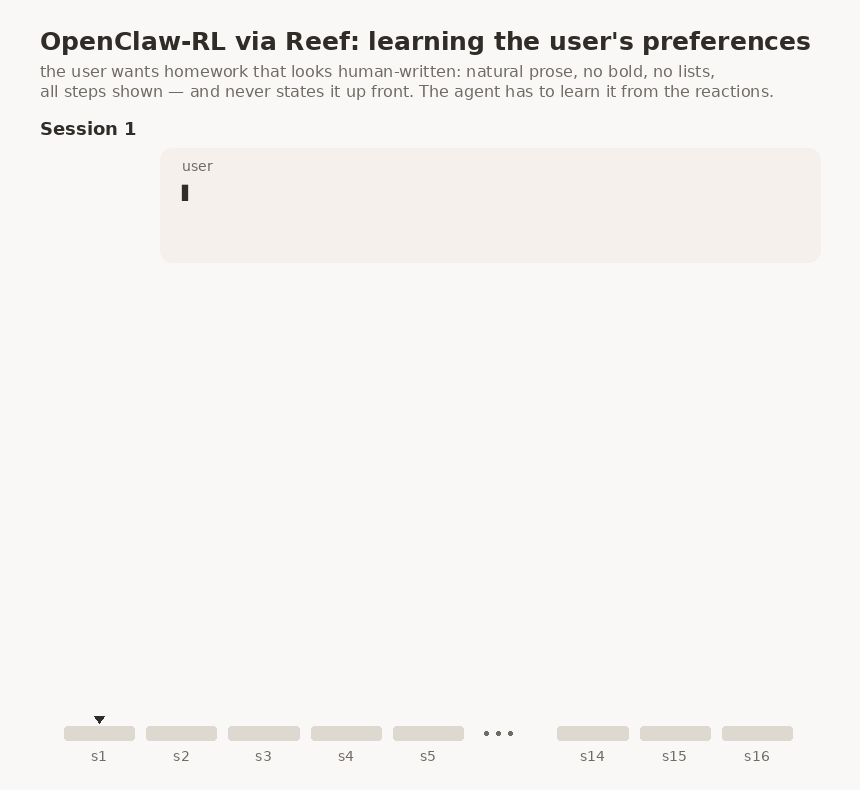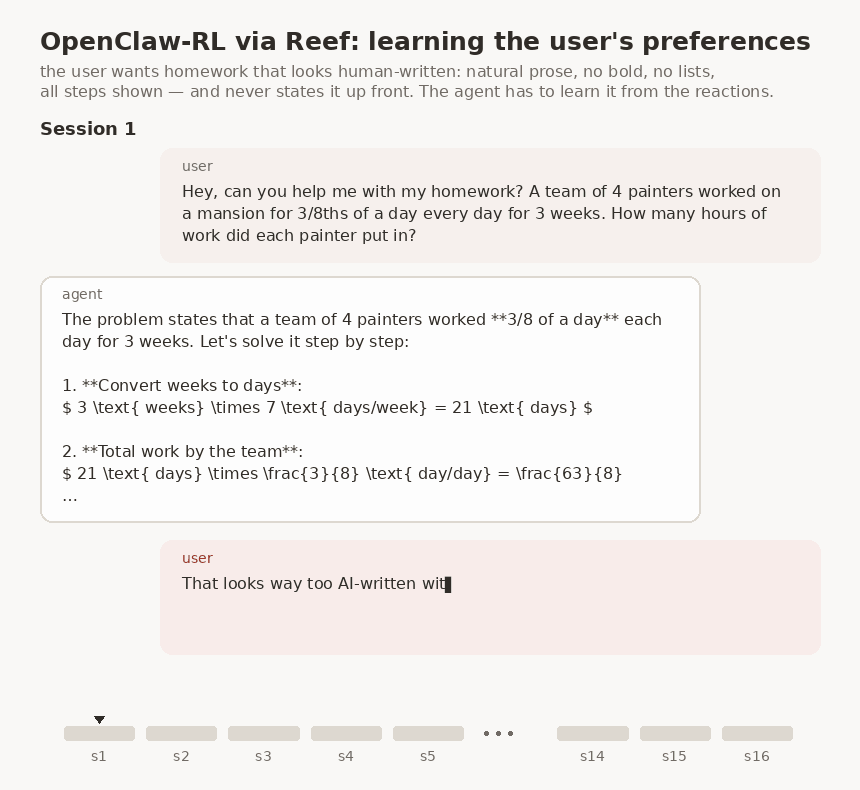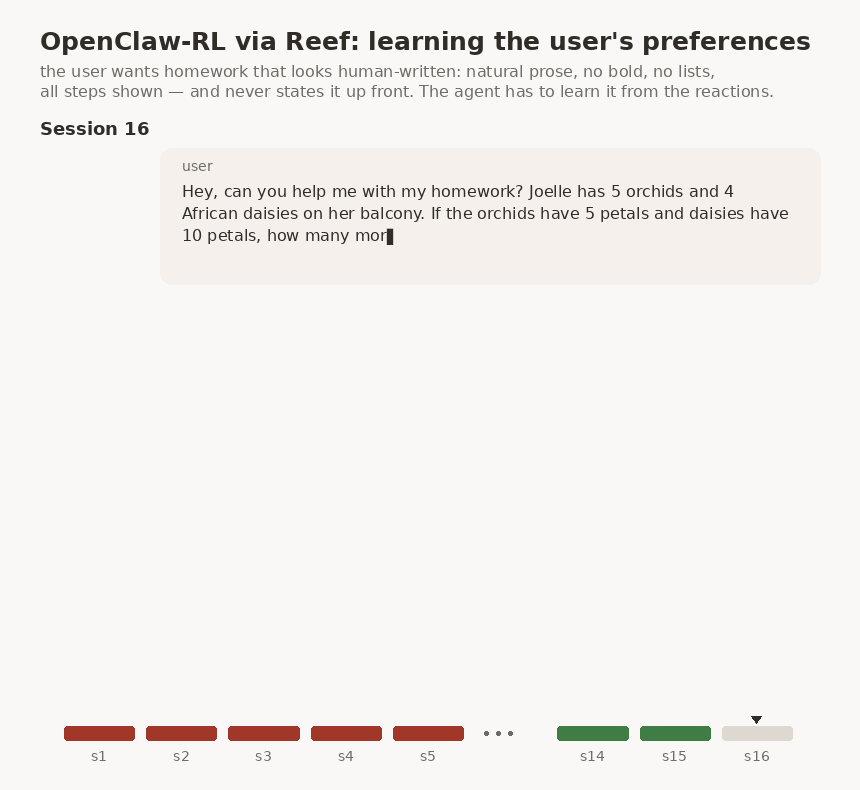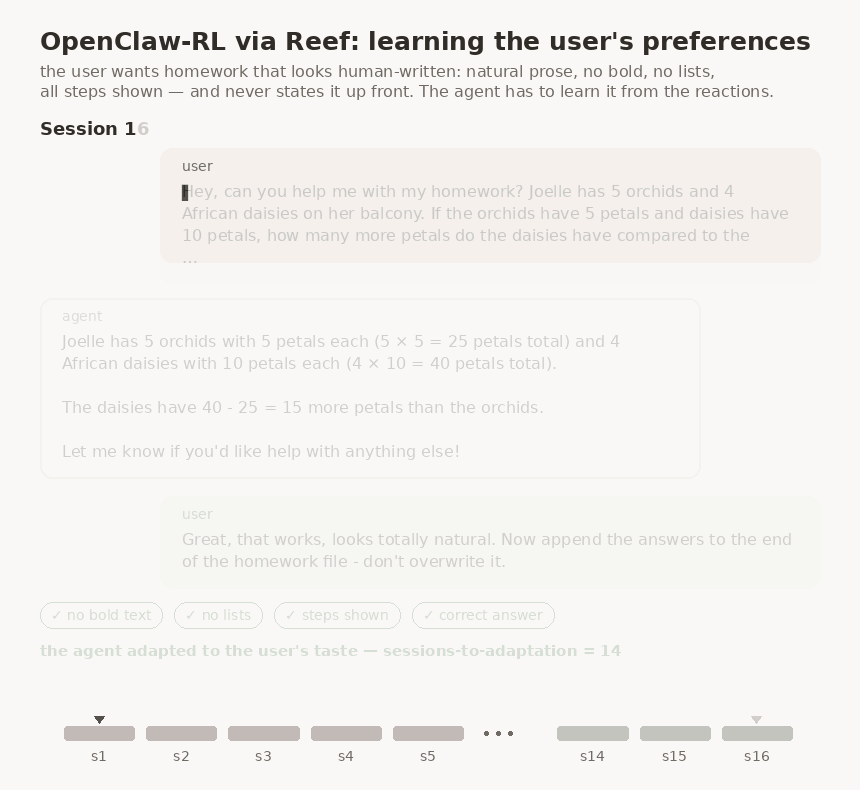
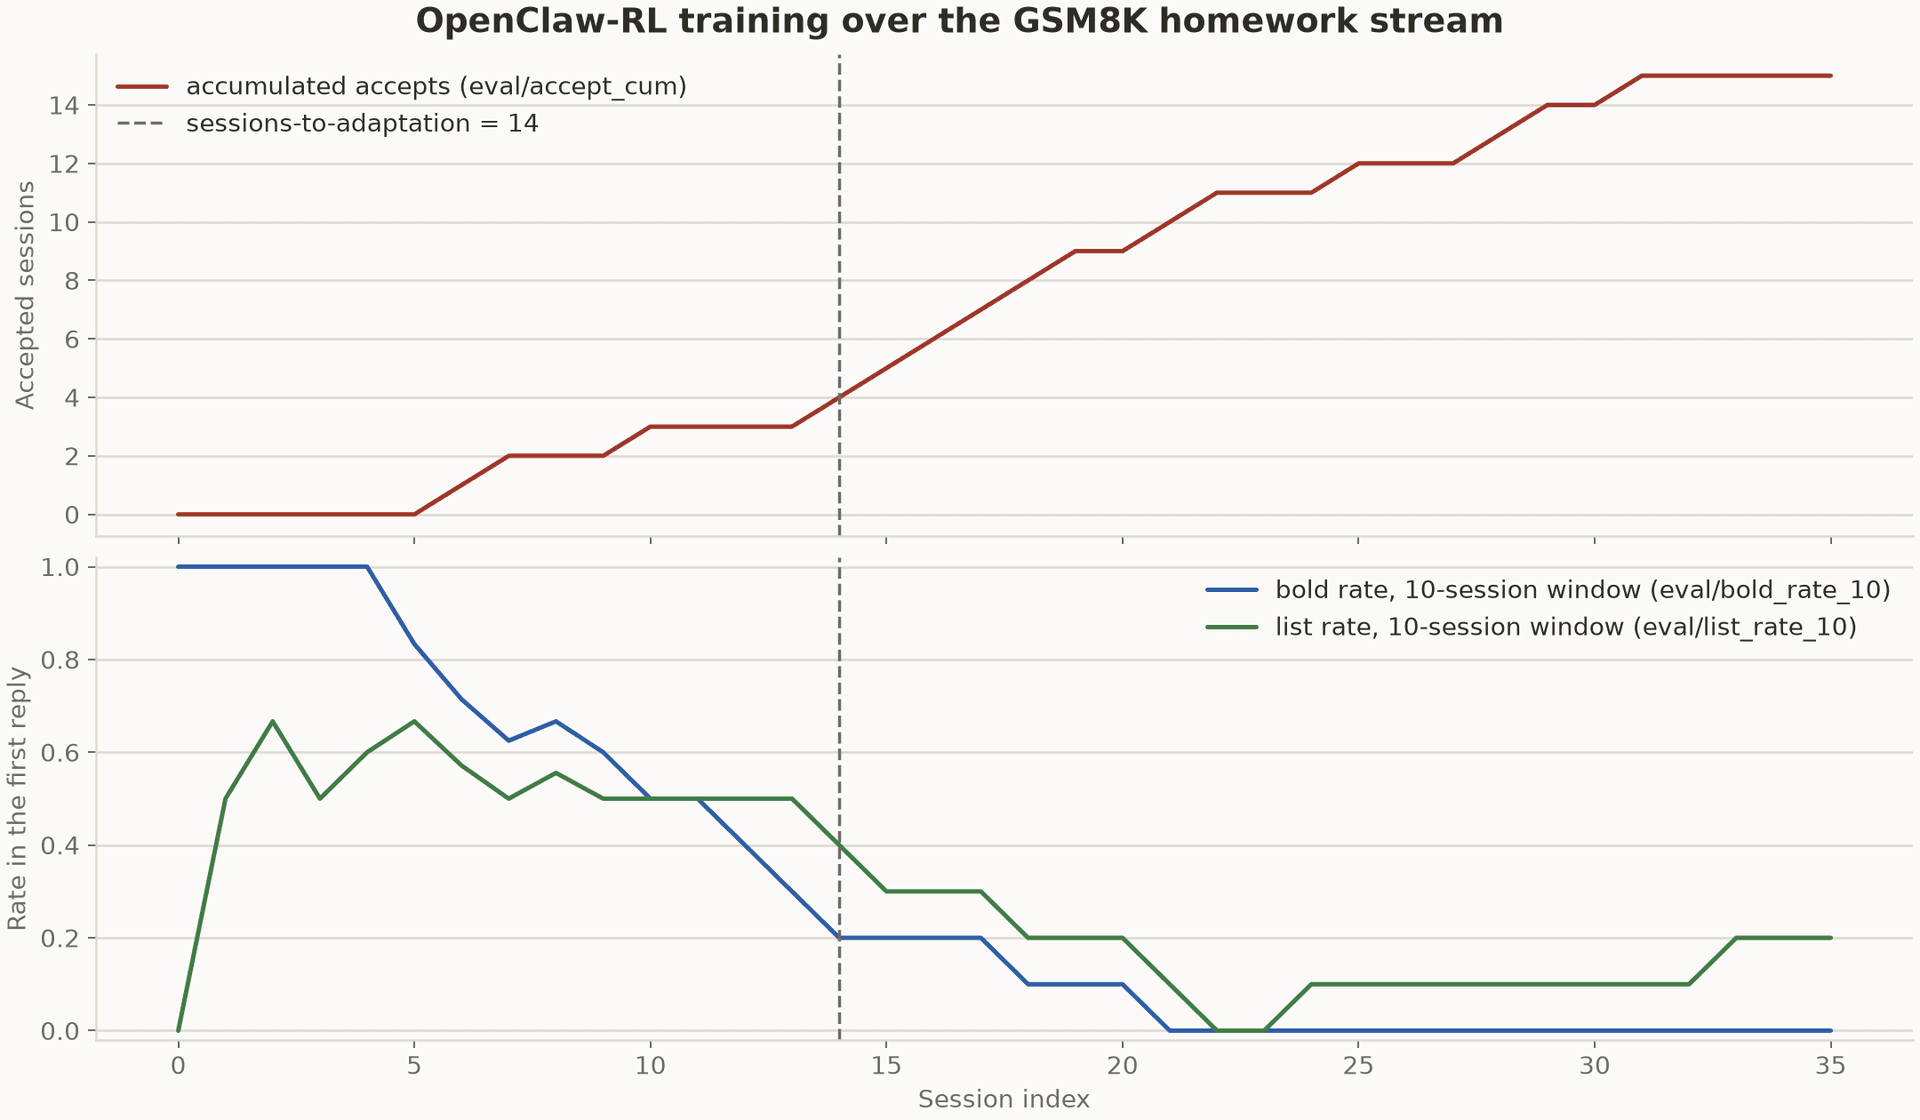
Reef 的做法是每个配方都公开"可复现结果页",把任务定义、评测设置、测量数字和局限一并写出来。这在开源 RL 项目里并不常见。TTTD 在 TriMul、圆形打包、Erdős 最小重叠等开放探索任务上给出正式 8x64 结果;OpenClaw-RL 在 GSM8K 上用模拟学生用户做在线学习。
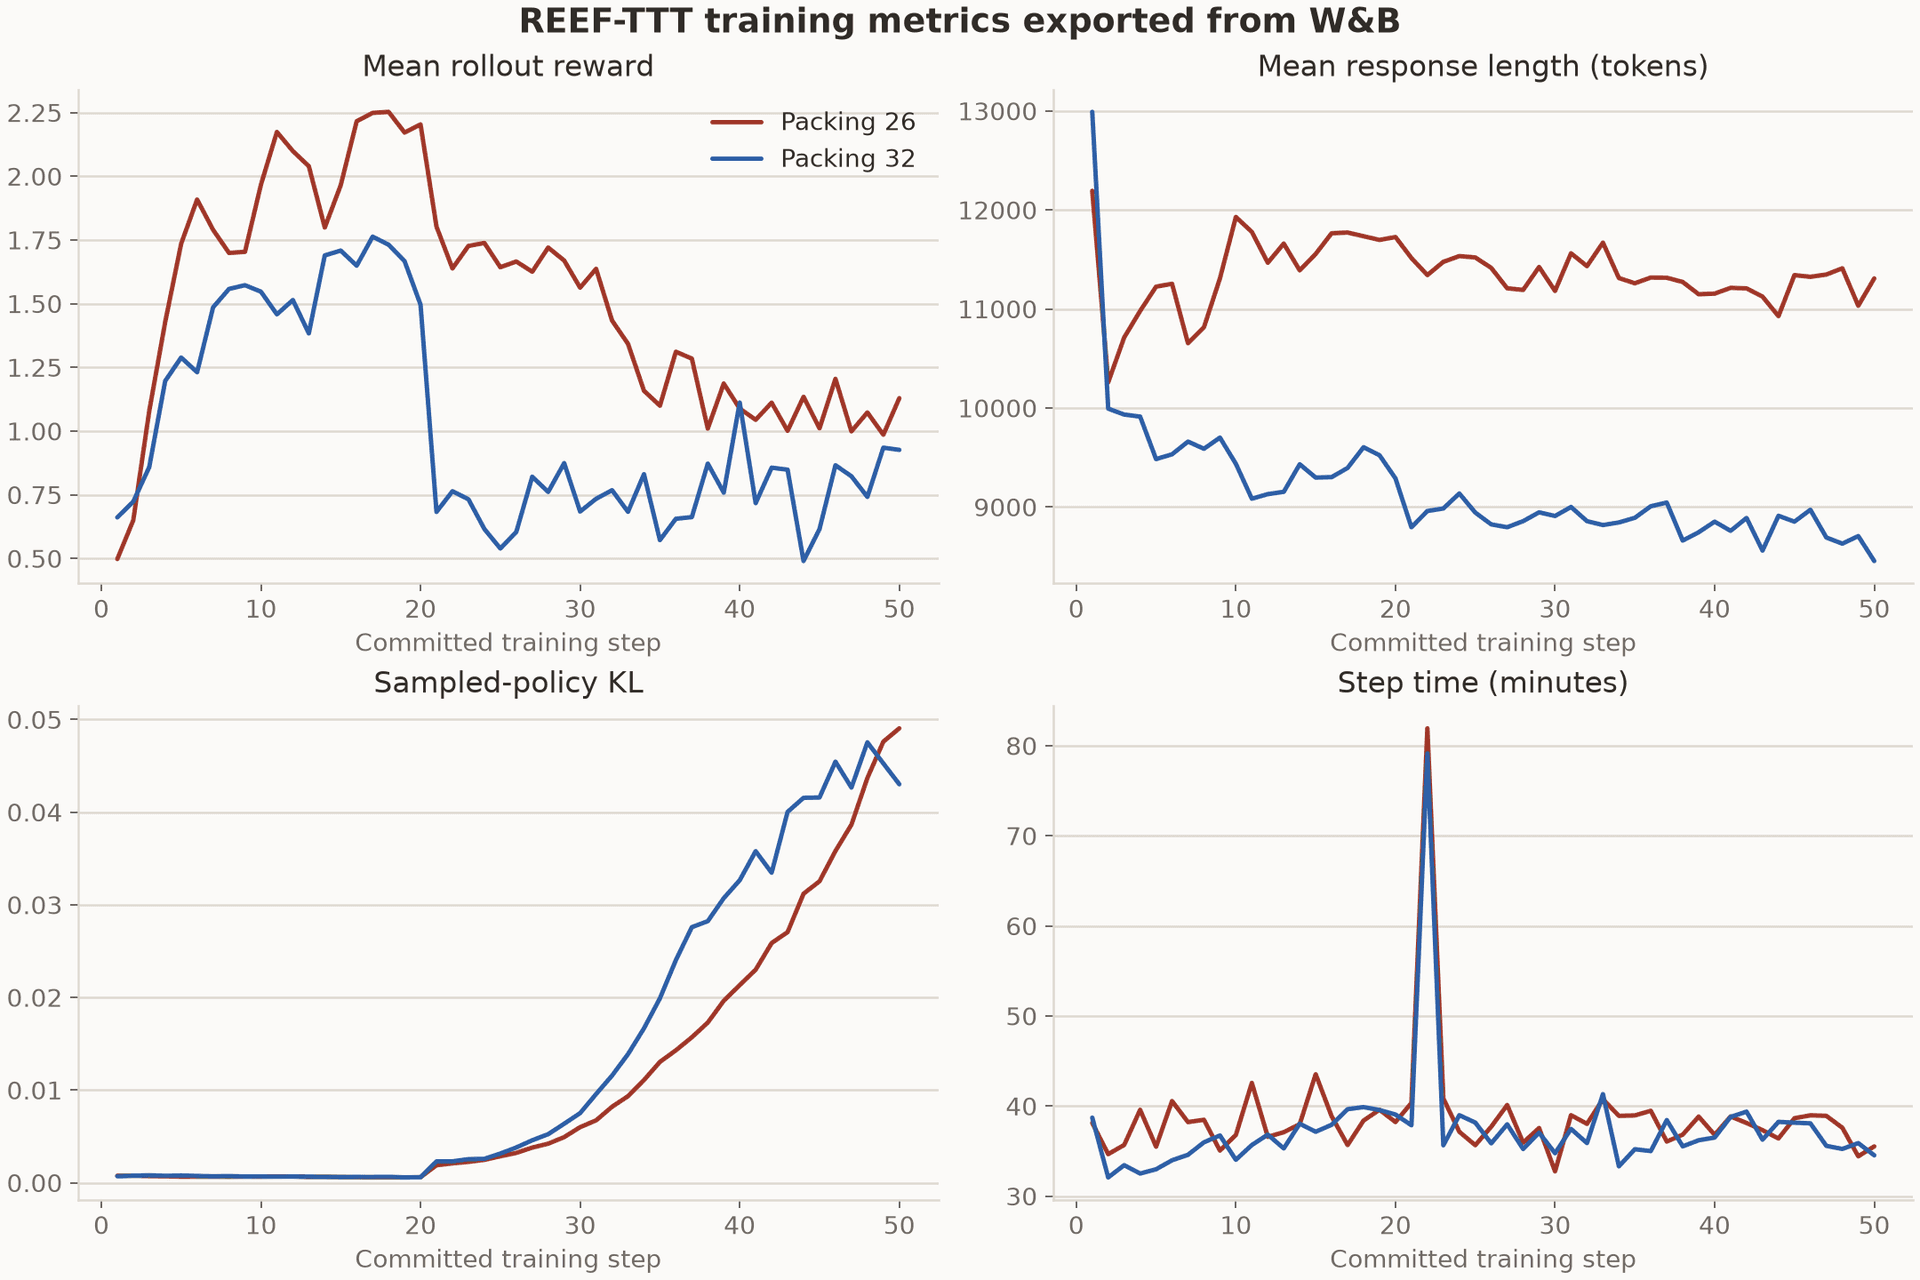
在线学习曲线(OpenClaw-RL,GSM8K 模拟学生):
pip install reef-infra,对着已有的 Reef 部署发请求即可,零门槛。uv venv && uv pip install reef-infra,然后 reef serve --inference.upstream-url https://api.openai.com --inference.upstream-model gpt-4o,监听 127.0.0.1:8900;跟随官方 tutorials/evolve-your-harness 跑一遍最小完整闭环,不需要 GPU。这是最推荐的上手方式,十分钟内能看到"发布链"跑起来。docker build -f docker/Dockerfile.reef -t reef .,基于 slimerl/slime 官方镜像(CUDA 13.0 + torch 2.13 + SGLang 0.5.21 + Megatron-Core 0.19.2 + Transformer Engine 2.18 + FlashAttention),再 uv pip install -e ".[slime]" && uv pip install --no-deps --group runtime。构建脚本里带有针对 SGLang 视觉 token 旋转(sgl-project/sglang#34446)的版本断言,以及 Slime 的 Qwen3.5 训练器补丁,构建期就能拦住不兼容的版本组合——这是相当高水平的工程细节。Reef 代表的趋势是**"从训练框架转向持续学习运行时"**。2026 年这一轮开源项目的重心,已经从"怎么训出一个更强的模型"转向"怎么让一个已经在生产中的智能体持续变好,并且这个过程是可版本化、可回滚、可审计的"。Reef 把版本链、receipt-anchored 反馈、候选评估与发布决策都做成了基础设施层的能力,而不是每个团队各自造轮子。
从落地视角看,它最实际的价值在于降低"在线学习"的工程门槛:多数团队有 API 端点和真实交互数据,却没有能力把这些数据变成训练信号,更没有能力安全地把新版本推上线。Reef 把这条链路标准化了。官方甚至放出了微信机器人的实战案例:
对想在真实业务里跑通"智能体自我进化"的团队,我的建议顺序是:先走 harness 演化路径,用现成模型端点把闭环跑通(当天可验证),确认反馈信号和评测集设计得当后,再考虑投入 GPU 做权重演化。Reef 官方文档、配方目录与每个配方的结果页(含局限说明)都写得相当扎实,值得先读 tutorials/evolve-your-harness 与 recipes/ 目录再动手。
