
DataGen
HowieHwong/DataGen加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
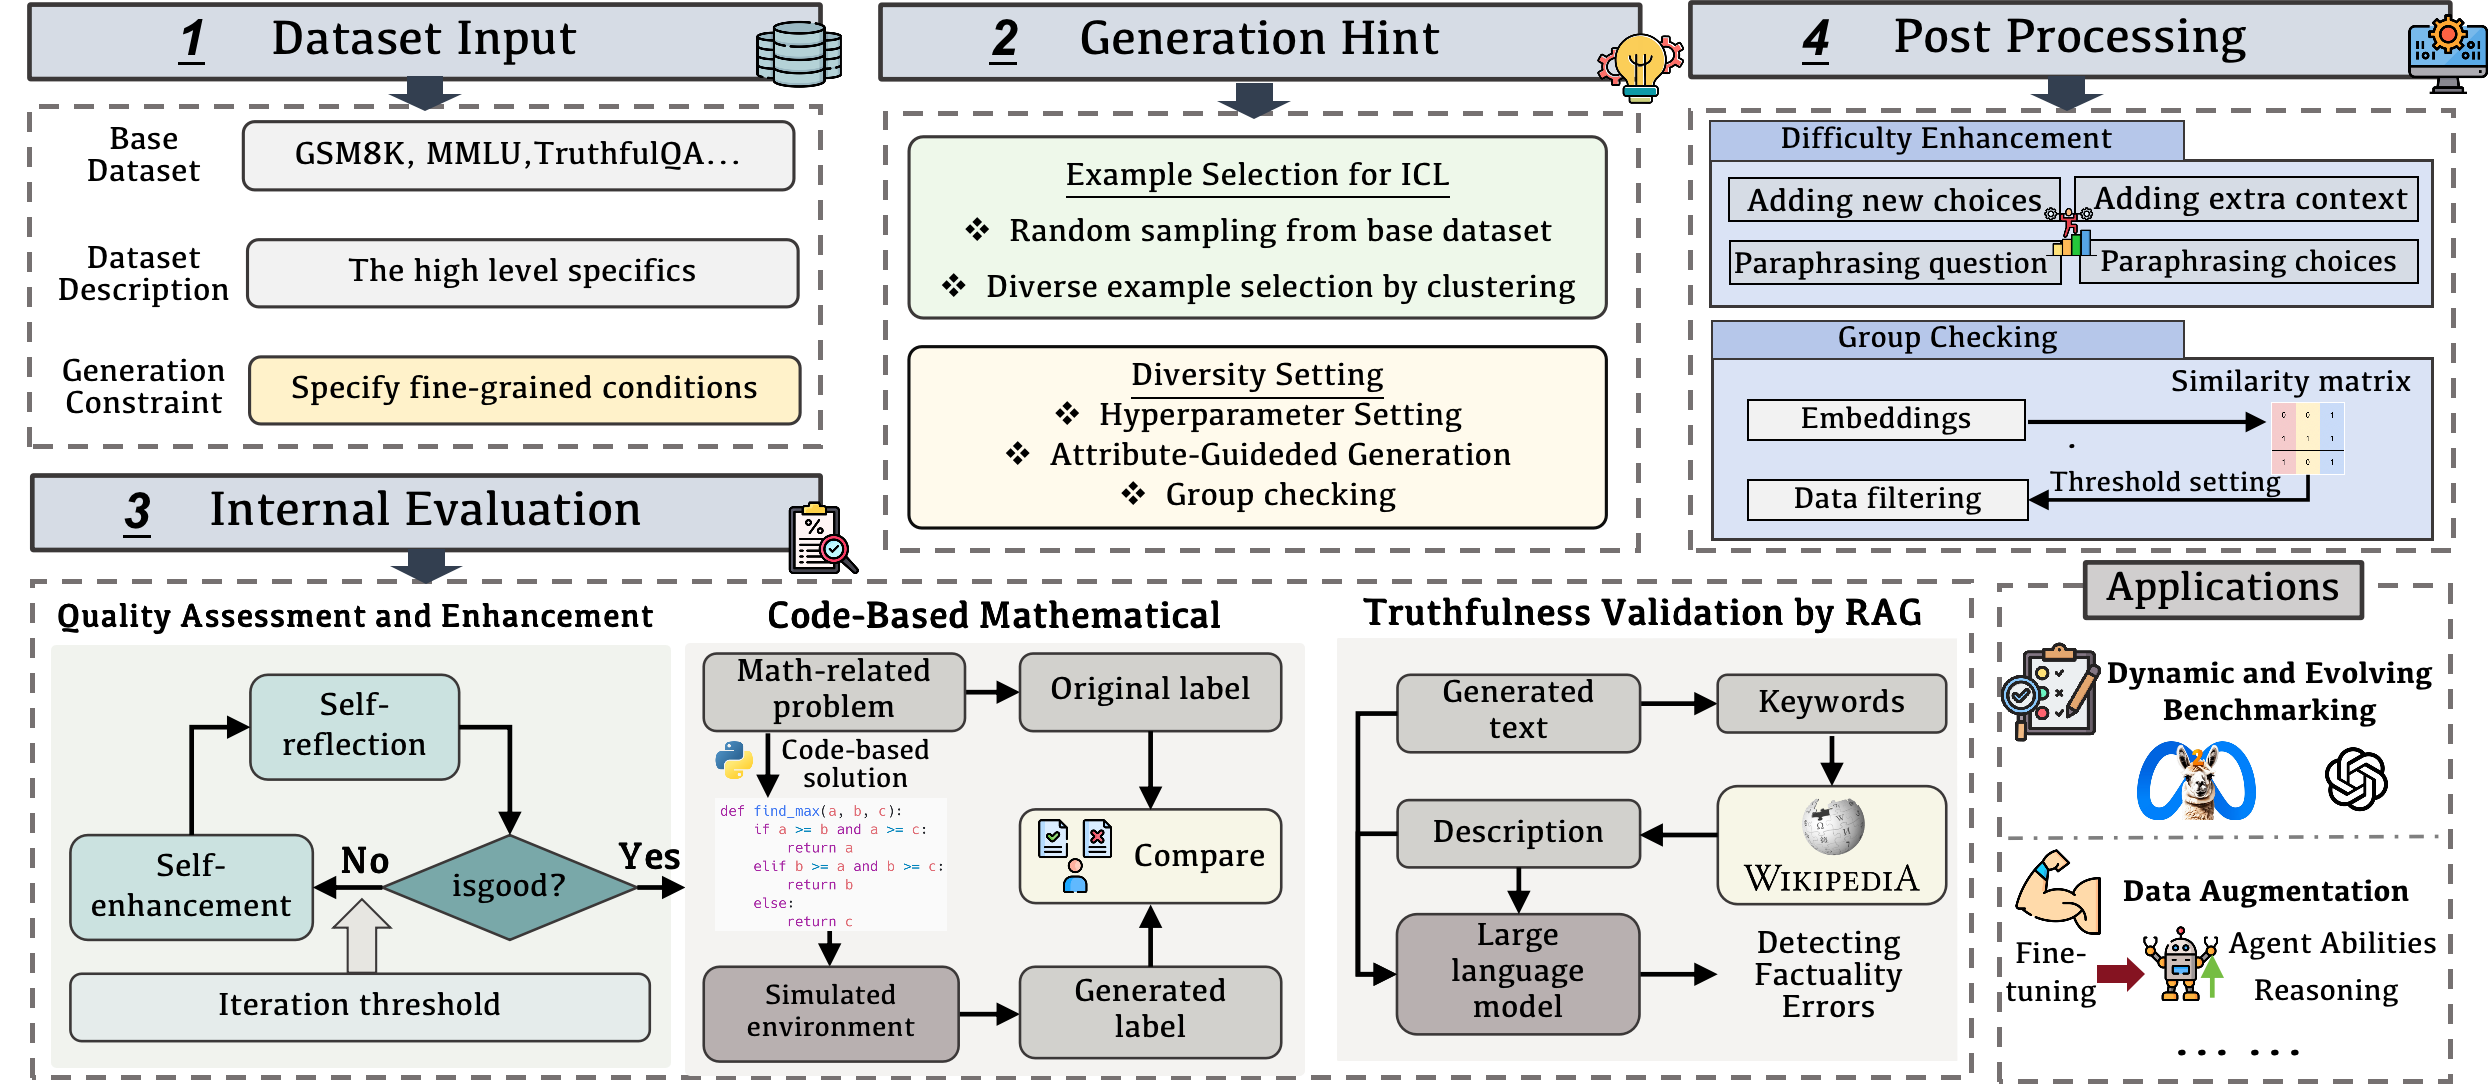
想象这样一个场景:一位AI研究员正在为数学推理任务构建评测数据集,传统方式需要招募标注人员、反复校准质量、成本高昂且周期漫长。而现在,借助UniGen,只需提供一份原始数据集,系统就能自动生成海量高质量、符合特定约束条件的合成数据——整个过程由大语言模型驱动,质量由多重验证机制保障。这正是ICLR 2025录用论文UniGen所做的事情。
大语言模型(GPT-4、Llama3等)的崛起让高质量合成数据生成成为可能,也大幅降低了对昂贵人工标注数据的依赖。然而,现有合成数据框架普遍存在四大痛点:
这四个问题就像四道坎,阻碍着合成数据在真实AI训练场景中的大规模应用。
UniGen是发表于ICLR 2025的学术框架,其核心目标是构建一个统一、通用的文本数据集生成系统。项目由厦门大学等机构的研究人员开发(第一作者Siyuan Wu),旨在通过LLM实现多样化、准确、可控的合成数据生成。
项目从属DataGen仓库,实际上DataGen是UniGen的发布版本——两个名字指向同一套代码体系,后者侧重工具化发布,前者侧重学术引用。
核心技术模块包括:
UniGen通过标准Python包管理安装:
git clone --depth 1 git@github.com:HowieHwong/UniGen.git
cd UniGen
pip install -e .
安装后提供unigen-cli命令行工具,是整个系统的唯一入口。没有Web界面,所有操作通过YAML配置文件驱动。
第一步:配置API。在YAML配置文件中填入OpenAI API Key(或Azure配置),指定使用的模型类型和嵌入模型:
api_settings:
  model_type: "gpt"
  api_key: "YOUR_API_KEY_HERE"
  embedding_model: "text-embedding-3-large"
第二步:准备原始数据集。提供一份已有的小规模数据集作为"种子",UniGen在此基础上进行扩展生成。数据集格式支持常见的JSON/CSV等结构。
第三步:定义生成提示词。用自然语言描述目标数据集的特征——例如"高质量、多语言、小学数学应用题,2到8步解题过程,面向初中生"。这份描述会引导LLM按照特定风格和约束生成。
第四步:效率调优。可选开启自我反思(Self-Reflection)、从错误中学习(Learn from Mistake)等机制,通过多轮迭代提升生成质量。
第五步:执行生成。一行命令启动:
unigen-cli gene examples/eval_generation.yaml
生成完成后,UniGen还提供配套的LLM评测工具,支持对生成数据集进行自动评测,并与LLaMA-Factory无缝衔接——生成的数据可直接用于模型微调训练。这让"数据生成→评测→微调"的完整闭环成为可能。
从代码结构看,UniGen采用标准的Python模块化设计:
| 核心模块 | 职责 |
|---|---|
generation.py | 数据生成主逻辑 |
eval.py | 生成质量评估 |
augmentation.py | 数据增强 |
inference.py | 模型推理封装 |
cli.py | 命令行入口 |
技术栈以Python为核心,依赖OpenAI SDK/LangChain进行LLM交互,PyYAML处理配置,整体代码量适中(约数千行),没有引入过于复杂的依赖。
UniGen代表了一个重要趋势:用更强的大语言模型来合成训练数据,再反过来训练更小的模型——这正是数据飞轮思维在LLM时代的具体落地。随着ICLR 2025的录用,该方向获得了学术界的正式认可,预计将推动更多类似框架的出现。
对于AI从业者而言,UniGen提供了一个可复用的数据生成工具链,尤其适合数学推理、代码生成等有明确验证标准的数据集构建场景。
