ghostmeet
Higangssh/ghostmeet加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有过这种经历?开了两小时的会,结束后脑子一片空白——"刚才说了啥来着?"
传统方案要么贵(Otter.ai 每分钟 0.004 美元)、要么隐私裸奔(所有音频上传云端)、要么还得手动整理笔记。ghostmeet 的思路很简单:本地运行,Chrome 插件注入,隐身录音,AI 提炼。
会议记录这个场景,2023 年之后突然热了起来。Otter.ai、Fireflies.ai、Zoom AI Companion 纷纷入场,但它们有一个共同问题:你的对话内容会上传到别人的服务器。对于涉及商业机密、医疗数据或敏感信息的会议,这是不可接受的。
ghostmeet 的开发者 Higangssh 显然也有同样的顾虑。他想做的是一个完全本地化的方案——音频不离开你的电脑,只有当你主动点"Summarize"时,才会向 Claude API 发一次请求用于生成摘要,而且那次请求发的是文字稿,不是原始音频。
ghostmeet 的工作流程分为三层,架构非常清晰:
第一层:Chrome 插件(抓取音频)
Chrome 扩展在 side panel(侧边栏)中运行,通过 chrome.tabCapture API 抓取任意标签页的音频流——不只是 Zoom/Meet/Teams,任何播放声音的页面都行。抓取后通过 WebSocket 以 1 秒一片的方式,把音频流(webm/opus 格式)实时推送到后端。关键是:其他会议参与者完全看不见这个插件——没有悬浮窗,不影响正常通话,就像一个"幽灵"。
第二层:本地后端(转写引擎)
后端用 FastAPI + Whisper 做实时语音识别。这里有一个精妙的工程细节——增量式转写。音频到达后先解码成 PCM 原始音频写入磁盘,每次转写只读取一个固定时间窗口(比如 10 秒)的新数据,而不是从头读到尾。这意味着 4 小时的会议和 4 分钟的会议,每次转写耗时是一样的,内存占用也基本不变。
第三层:AI 摘要(按需调用)
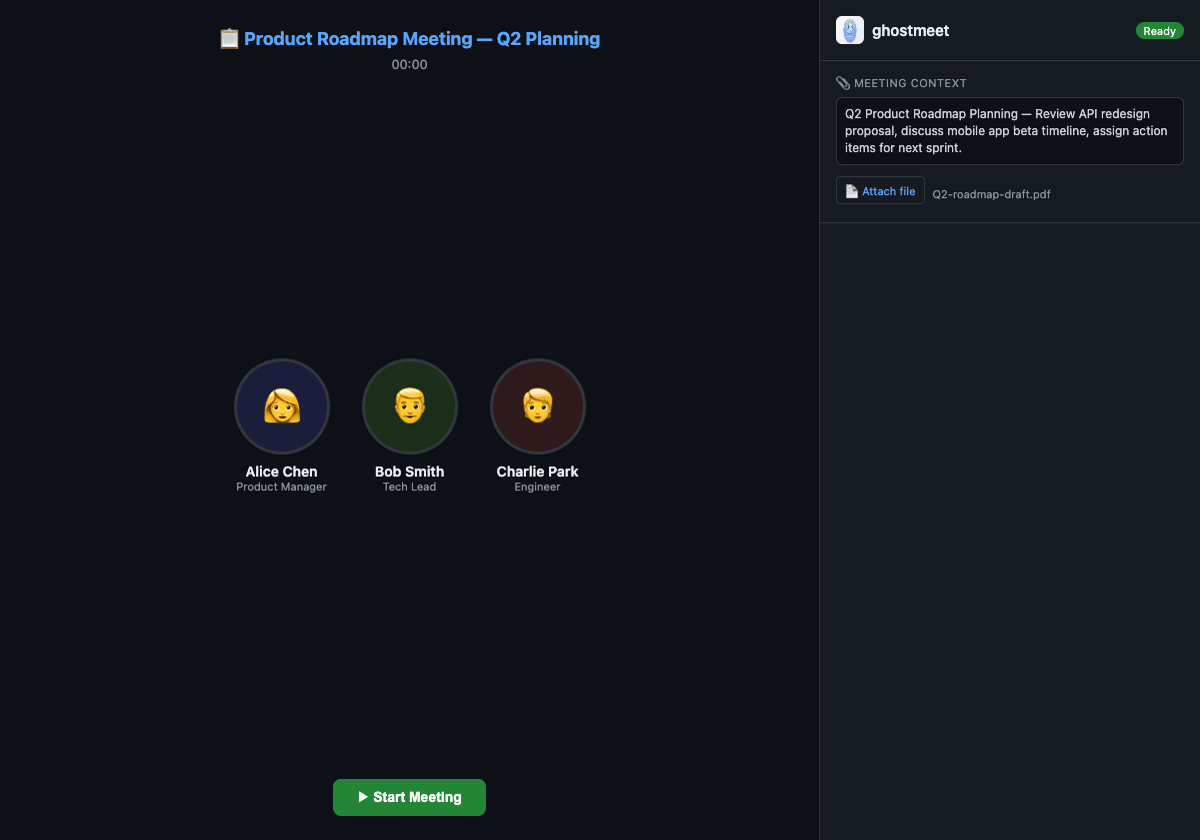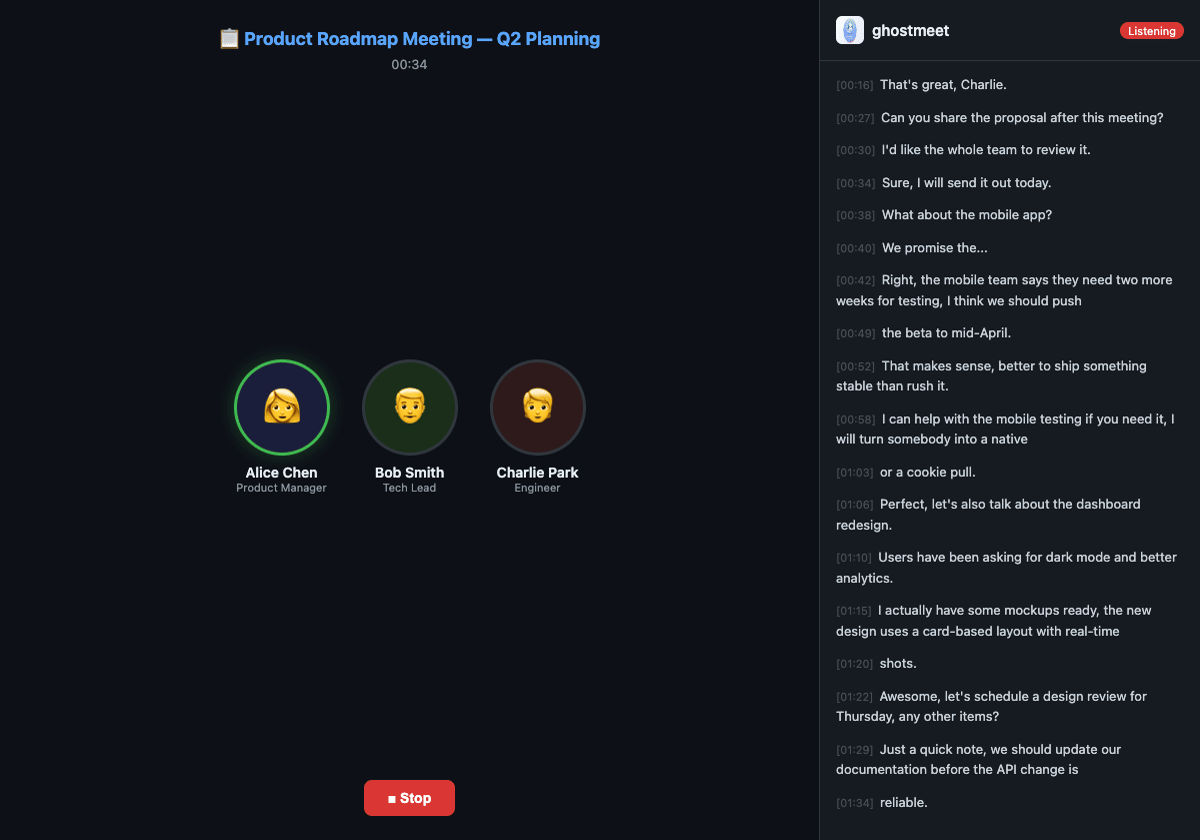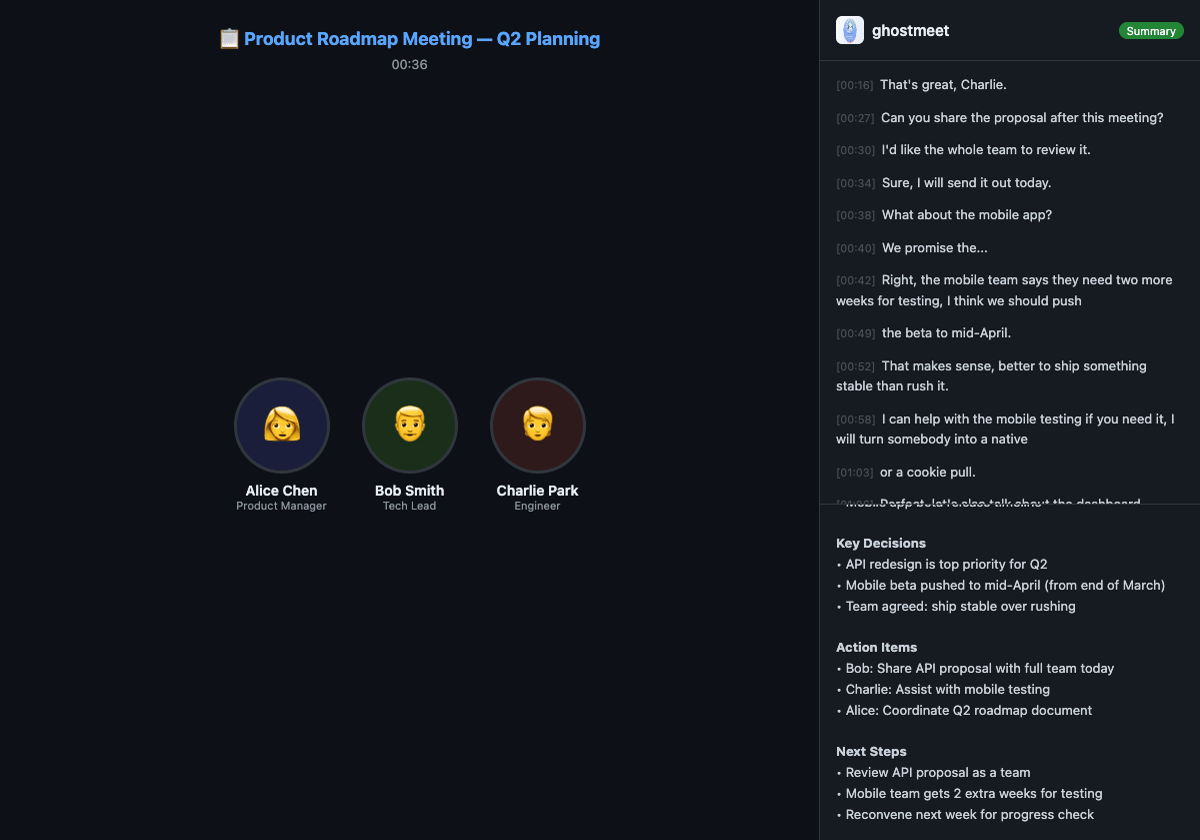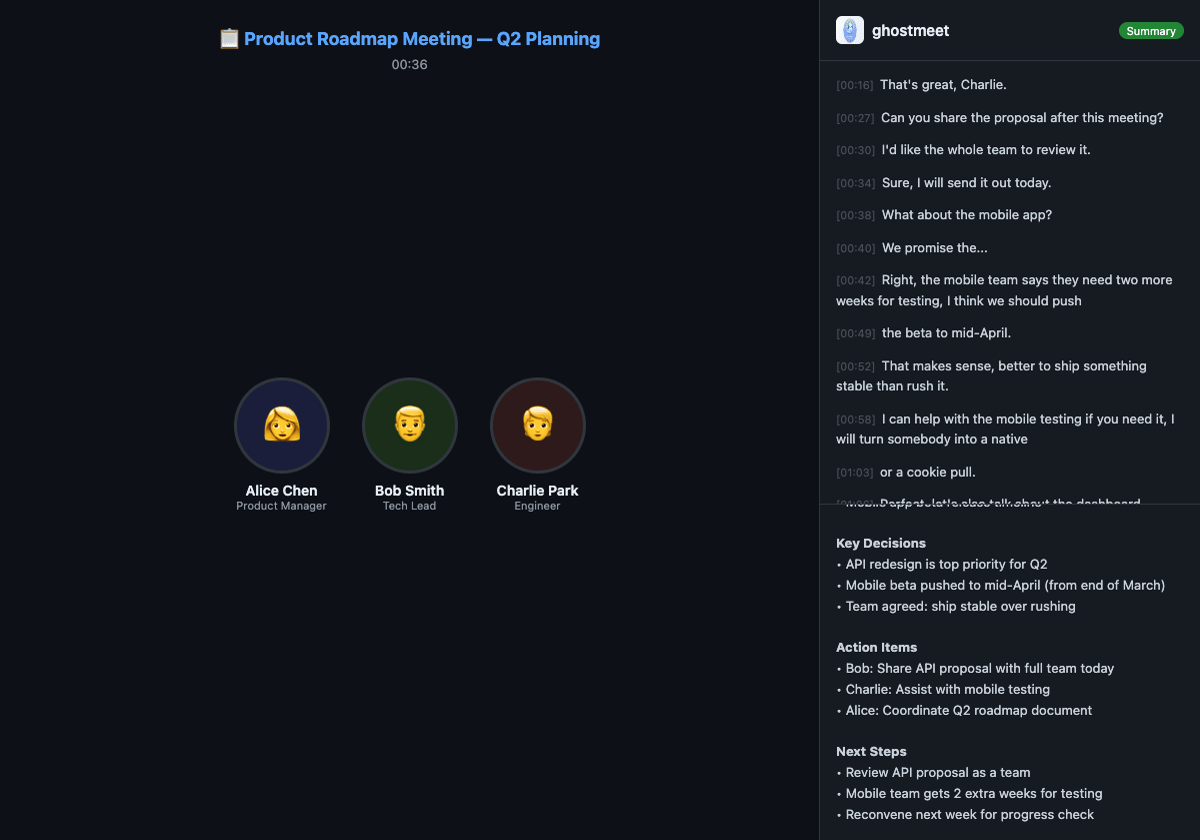
会议结束后,点击"Summarize",后端把已存储的完整文字稿发给 Claude API,生成结构化摘要——包含关键决议、待办事项和后续步骤。这步是可选的,不点的话纯转写功能本身就能用,不需要任何外部 API Key。
从代码结构来看,pcm_store.py 负责追加写入音频文件,incremental.py 实现增量读取(只读最新窗口),pipeline.py 把解码和转写解耦成独立流程,transcriber.py 共享一个 Whisper 模型实例(避免重复加载)。
Whisper 模型支持多种尺寸:tiny(75MB,最快)、base(150MB,推荐)、small(500MB,更准)、medium/large(需 GPU)。CPU 模式下推荐用 int8 量化,计算速度能提升不少。
存储方面,sessions、segments(转写片段)和 summaries 都存在 SQLite 数据库里,重启后数据不丢失。
ghostmeet 提供 Docker 一键部署:
git clone https://github.com/Higangssh/ghostmeet.git
cd ghostmeet
cp .env.example .env
docker compose up -d
然后在 Chrome 里加载 extension/ 目录为开发者扩展即可。后端监听 127.0.0.1:8877,不对外暴露,隐私性很强。
ghostmeet 也有明显的局限性:
ghostmeet 体现了一个明确的趋势:本地优先的 AI 工具正在填补云端方案的隐私空白。2024 年 Whisper 开源后,实时语音转文字的本地化方案门槛大幅降低,ghostmeet 把这个能力包装成了一个对普通用户友好的 Chrome 插件形态。它不是要做功能最全的会议助手,而是做最让用户放心的那个——你的音频永远在你自己的机器上。