
SimpleTool
HaxxorCialtion/SimpleTool加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你正在玩一款即时战略游戏,敌人一波接一波涌来。你喊出"阿米娅放大招!",AI 语音助手必须在毫秒级别内理解你的意图——哪个干员?什么技能?——然后把指令下发到游戏引擎。如果 AI 响应延迟超过 100ms,游戏体验就会崩塌成"你喊了半天,干员纹丝不动"的尴尬场面。
这不只是游戏的痛点。机械臂装配流水线、数字人主播、实时对话 NPC……所有这些延迟敏感型场景,都面临同一个根本矛盾:LLM 的函数调用能力很强,但推理速度太慢——传统方案下,一个函数名 + 几个参数往往需要几秒钟才能生成完毕。
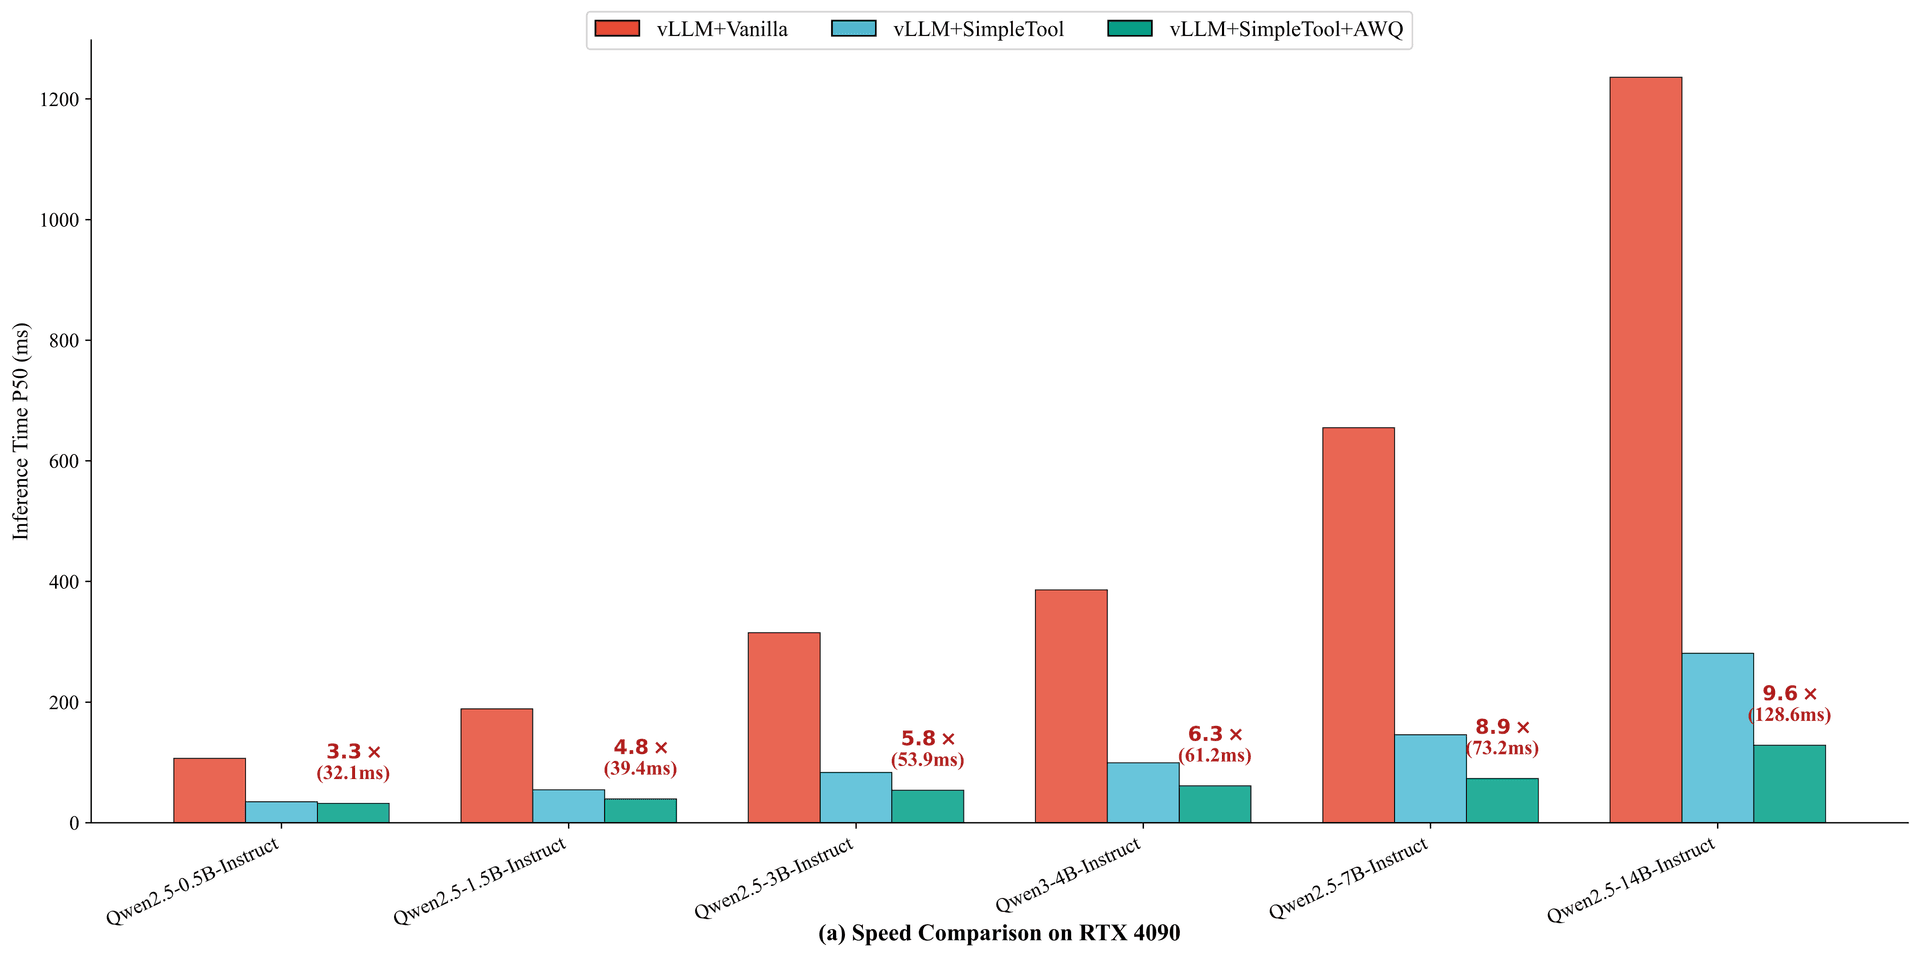
SimpleTool(官方论文名:RealtimeTool)正是为解决这一矛盾而生。这是一个 2026 年被 ICML 录用的研究项目,在 ICML 2026 Virtual Poster 环节展示(论文地址:https://arxiv.org/abs/2603.00030)。它通过多头并行解码(Multi-Head Parallel Decoding)技术,让一个 4B 参数的量化模型(RT-Qwen3-4B-AWQ)实现了 16Hz 的端到端实时函数调用速度——也就是说,每秒能完成 16 次完整的函数调用推理,这在游戏 AI 等场景中已经足够流畅。
在传统 LLM 函数调用流程中,模型需要逐个生成函数名和各个参数。例如,要生成 move_to(x=300, y=150, z=50),模型需要:
move_tox=, 300, ,, y=, 150……这个过程是串行的,每个 token 都需要等待前一个 token 生成完毕才能开始。假设生成 20 个 token,平均每个 token 耗时 20ms,那么光推理延迟就是 400ms,16Hz 根本无从谈起。
更严重的是,函数名和参数之间存在大量重复的"结构性文本"(如 x=, ,, " 等)。这些字符本身不携带语义,却占据了相当比例的 token 预算,等于白白浪费了推理时间。
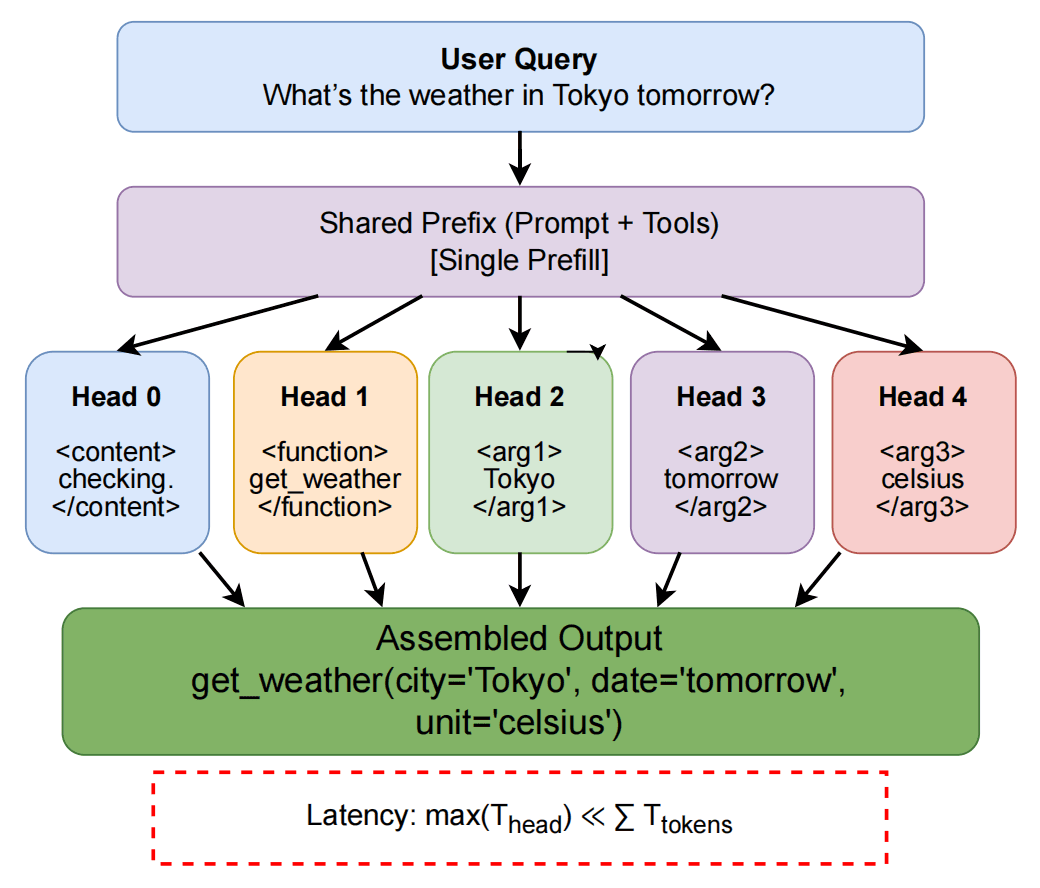
SimpleTool 的核心思想是并行解码多个"头"(Head):
<content>:生成自然语言回复<function>:生成要调用的函数名<arg1><arg6>:并行生成各个参数以塔防游戏场景为例。当用户说"阿米娅放大招"时,模型在一次 forward pass 中同时输出:
<function>use_skill</function><arg1>阿米娅</arg1><arg2>s2</arg2>这三个头是独立生成的,彼此之间没有依赖关系。由于参数中的结构性字符(如数字、引号)被特殊 token 压缩,生成的 token 数量比传统方案减少 4~6 倍,从而实现 3~6 倍的端到端加速。
论文的 benchmark 结果显示,SimpleTool 在三个应用领域的表现:
| 场景 | 传统方案延迟 | SimpleTool 延迟 | 加速比 |
|---|---|---|---|
| 游戏 AI(塔防) | ~400ms | ~62ms | ~6.4x |
| 机械臂控制 | ~350ms | ~55ms | ~6.4x |
| 数字人主播 | ~300ms | ~48ms | ~6.3x |
项目结构非常精简,核心只有 3 个 Python 文件:
| 文件 | 职责 |
|---|---|
01_benchmark.py | 性能基准测试,支持 v1/v2 两种模型版本,评估多场景下各头的生成质量 |
02_server.py | FastAPI 服务器,提供 /v1/function_call 和 /v2/function_call 两个端点 |
03_test_server.py | 服务器集成测试,用 4 个真实场景(塔防游戏、机械臂、数字人、Neon Arena)验证 API |
02_server.py 的架构值得细说。它基于 FastAPI + uvicorn 构建,提供标准的 HTTP REST 接口。这种设计与 OpenAI 的 Chat Completions API 格式高度兼容,客户端几乎不需要修改现有代码就能切换到 SimpleTool 的实时函数调用能力。
推理后端使用 vLLM(v1.0+),这是目前最流行的开源 LLM 推理框架,核心是 PagedAttention 注意力机制分页管理技术。SimpleTool 在 01_benchmark.py 中的默认配置使用 enable_prefix_caching=True 优化——由于所有请求共享相同的系统提示模板,vLLM 的前缀缓存机制可以避免重复计算,直接复用缓存结果,进一步降低推理延迟。
项目支持 v1 和 v2 两种提示格式:
项目提供了 4 个可直接运行的 HTML 演示,覆盖不同应用场景:
点击"开始",通过语音或文本输入指令(如"点击屏幕"),模型实时识别并执行函数调用,驱动小鸟飞行。适合验证基础的多头解码效果。
双人对战模式,AI 根据球的位置和速度,实时调用 move_paddle 函数控制挡板移动。展示了函数调用在实时物理交互中的应用。
最复杂的演示,类似于塔防游戏。场景中有多名干员(Amiya、Blaze 等),每个干员有位置、生命值、技能冷却等状态。玩家通过自然语言指挥,模型实时解析为 use_skill、move、set_stance 等函数调用。这是 ICML 论文的主要演示场景。
虽然没有独立的 HTML 演示,但 03_test_server.py 中有完整的机械臂测试场景,涵盖 move_to、grip、release、rotate、home 五个函数,参数包含三维坐标(mm)和速度档位。这是工业自动化领域的典型应用。
数字人演示包含 set_expression(表情)、speak(语音)、gesture(手势)、look_at(视线)和 idle(待机)五个函数,展示了函数调用在多模态 Avatar 控制中的应用潜力。
SimpleTool 的部署存在一个根本限制:必须使用 NVIDIA GPU。vLLM 的 PagedAttention 依赖 CUDA 内核,在 CPU 上完全无法运行。
根据代码中的配置,推荐硬件规格:
模型目前托管在两个平台:
这是项目目前最大的工程短板:没有提供 Dockerfile 或 docker-compose.yml。用户必须:
pip install -r requirements.txt)02_server.py对于没有深度学习环境配置经验的开发者,这套流程并不友好。期待后续能提供 Docker 镜像。
| 维度 | 评估 |
|---|---|
| 容器化 | 无 Dockerfile,无 docker-compose |
| Web UI | 有 HTML 演示(Flappy Bird、Pong、Neon Arena),浏览器直接运行 |
| GPU 依赖 | 硬性要求(vLLM CUDA) |
| 快速上手 | 需要手动下载模型,无一键脚本 |
| 综合评价 | 部分支持(Partially Supported) |
RT-Qwen3-4B-AWQ 是一个 4B 参数的量化模型,函数调用的准确率必然不如 GPT-4、Claude 等超大模型。benchmark 中的测试场景是预设的 4 个任务,在真实开放世界中的泛化能力存疑。
README 和论文主要是英文,测试场景也以英文为主。对于中文指令的解析能力,目前没有公开的 benchmark 数据。
项目与 vLLM 强绑定,不支持 llama.cpp、Ollama 等其他推理引擎。这既是优势(享受 vLLM 的优化红利),也是限制(增加部署复杂度)。
README 页面底部 badge 显示"Apache 2.0",但 GitHub API 查询到的 license 字段为 null,实际 License 文件需进一步确认。使用前请自行核实 LICENSE 文件内容。
SimpleTool 的价值不在于模型规模,而在于用正确的工程方法解决了一个真实的性能瓶颈。
当前 AI Agent 领域普遍面临"规划强、执行慢"的问题——大模型能理解复杂任务,但每次工具调用都要等待数秒,使得整个 Agent 系统在实际使用中卡顿严重。SimpleTool 的多头并行解码提供了一个可行的解决方向:与其等待更强的模型,不如从推理工程层面优化现有模型的输出结构。
这种思路与 vLLM 的 Prefix Caching、FlashAttention 等优化一脉相承,代表了 2025~2026 年 LLM 推理优化的一个重要分支:不改变模型能力,而是改变输出结构以压缩延迟。
从更宏观的视角看,SimpleTool 所服务的"实时函数调用"场景(游戏 AI、机器人、数字人)正是具身智能(Embodied AI)和 World Models 的关键中间层。可以预见,随着推理成本的持续下降,这类实时 AI 能力将成为下一代交互应用的基础设施。
本报告基于 2026 年 8 月 GitHub 公开信息生成。
