
autograd
HIPS/autograd加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
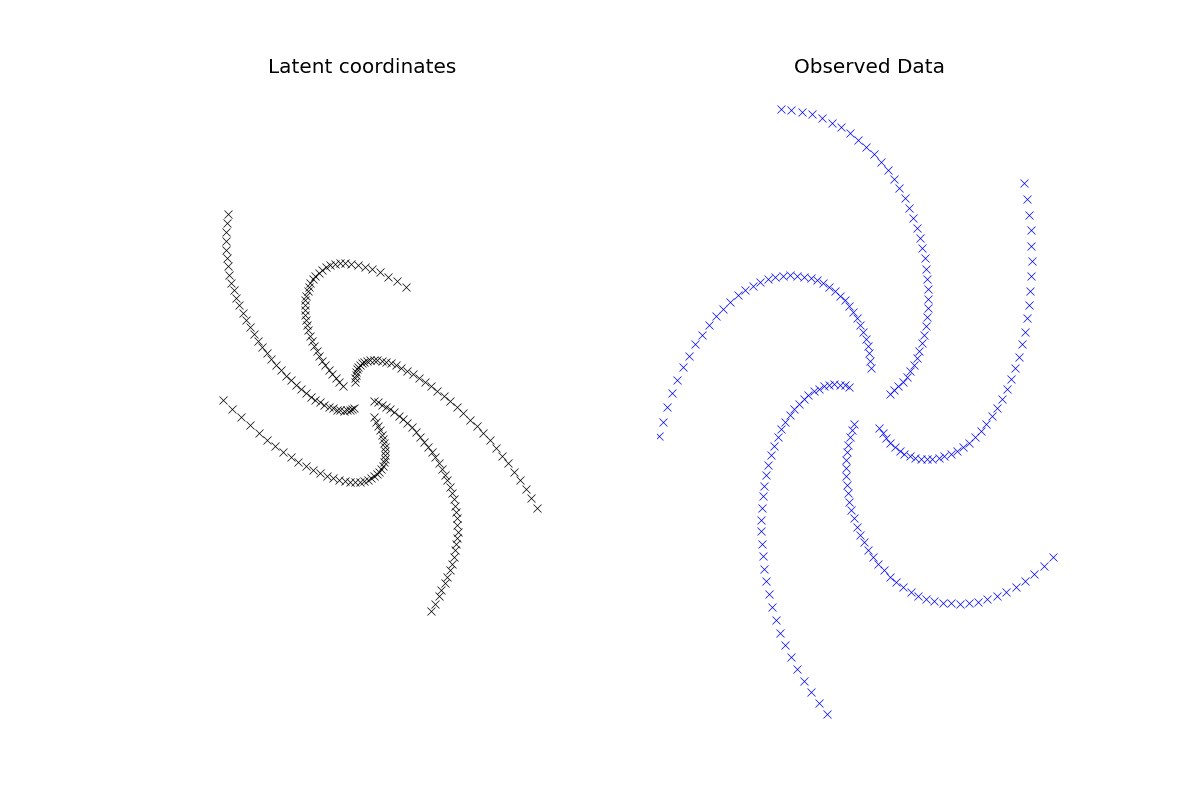 利用 Autograd 可视化 tanh 函数及其各阶导数,展示了高阶导数的平滑衰减特性
想象你正在研究一个新模型——可能是神经网络、变分推断,或者某个自定义的损失函数。你坐下来推导梯度,纸写了一页又一页,结果发现:
这正是 2014 年前后深度学习研究者的普遍困境。手动求导不仅耗时,而且极易出错——尤其当模型复杂度达到百万参数量级时,人工推导几乎成了不可能完成的任务。
Autograd 正是为解决这一痛点而生。它的核心思想非常优雅:你写什么,就微分什么。不需要学习任何新的 DSL(领域特定语言),不需要将代码重写成某种特殊的"可微分格式"。直接用你最熟悉的 NumPy,Autograd 自动帮你算出梯度。
Autograd 由哈佛大学物理系博士生 Dougal Maclaurin 联合 David Duvenaud(哈佛 SEAS)、Matt Johnson(MIT CSAIL)共同开发,Ryan Adams 担任顾问。
2015 年,他们在 ICML(国际机器学习大会)上发表论文《Autograd: Effortless Gradients in Numpy》,正式将这一工具推向学术界。论文标题里的"Effortless"(毫不费力)精准概括了他们的设计哲学:让梯度计算从手工劳动变成一行代码。
2018 年,Google 招募了 Dougal Maclaurin 等核心作者,基于 Autograd 的设计思路开发了 JAX。可以说,没有 Autograd,就没有 JAX——它不仅是一个工具,更是一种"纯函数式 + NumPy 语义"求导范式的开创者。
Autograd 支持两种求导模式:
反向模式(Reverse Mode)——这是 Autograd 的主菜,也是深度学习的核心技术。反向模式通过"计算图"(Computational Graph)记录前向计算路径,然后反向遍历计算梯度,特别适合输出为标量、输入为高维数组的场景(如神经网络损失函数)。
import autograd.numpy as np
from autograd import grad

def loss(w, X, y):
    pred = np.dot(X, w)
    return np.mean((pred - y) ** 2)

grad_loss = grad(loss)  # 返回梯度函数
gradient = grad_loss(w, X, y)  # 计算梯度
前向模式(Forward Mode)——通过一次遍历同时计算函数值和导数,适合多输入、单输出的场景,在 Autograd 中由 elementwise_grad 提供。
高阶导数是 Autograd 的一大特色。你可以无限嵌套 grad(),理论上可以得到任意阶导数:
d_fun = grad(tanh)       # 1阶导数
dd_fun = grad(d_fun)     # 2阶导数
ddd_fun = grad(dd_fun)   # 3阶导数
这在二阶优化(如自然梯度、Adam 之前的 Hessian-Free 优化)和概率编程(变分推断中需要 KL 散度的二阶导数)中极为有用。
Autograd 的核心代码只有约 300 行(core.py + tracer.py),但每一行都经过精心设计。
核心模块架构:
| 模块 | 职责 |
|---|---|
core.py | 定义 VarNode(变量节点)和 primitive(原始操作),构建反向传播的计算图 |
tracer.py | 跟踪 Python 代码执行流,实时构建计算图 |
builtins.py | 为 Python 内置操作注册微分规则(如 np.sum、np.mean) |
numpy/ | 为 NumPy 函数实现微分规则,覆盖线性代数、统计、Fourier 变换等 |
scipy/ | 支持 SciPy 优化器(如 scipy.optimize.minimize)直接使用 Autograd 的梯度 |
differential_operators.py | 对外暴露 grad、multigrad、jacobian、hessian 等核心 API |
微分规则注册机制是 Autograd 的灵魂。开发者通过 @primitive 装饰器注册一个操作的微分规则:
from autograd.core import primitive

@primitive
def elementwise_add(A, B):
    return A + B

# 注册导数规则:d(A+B)/dA = 1
def elementwise_add_grad(ans, A, B):
    return lambda g: g
elementwise_add.defgrad(elementwise_add_grad)
这种延迟求值的设计使得 Autograd 可以优雅地处理任意嵌套深度的函数组合,同时保持计算图的高效性。
安装:
pip install autograd
仅此而已。依赖只有 NumPy(numpy<3),安装包体积极小。
API 设计极度克制:
grad(f) → 返回 f 的梯度函数elementwise_grad(f) → 返回逐元素梯度(用于向量化函数)jacobian(f) → 返回雅可比矩阵hessian(f) → 返回 Hessian 矩阵Autograd 只暴露了 4 个核心 API,就覆盖了从简单梯度到复杂矩阵求导的全部场景。这种"最小接口"哲学是它最成功的设计决策——你不需要花时间学习框架,上手即用。
与 SciPy 无缝集成:
from autograd import grad
from scipy.optimize import minimize

def rosen(x):
    return sum(100*(x[1:]-x[:-1]**2)**2 + (1-x[:-1])**2)

result = minimize(rosen, x0=[0.]*10, jac=grad(rosen), method='L-BFGS-B')
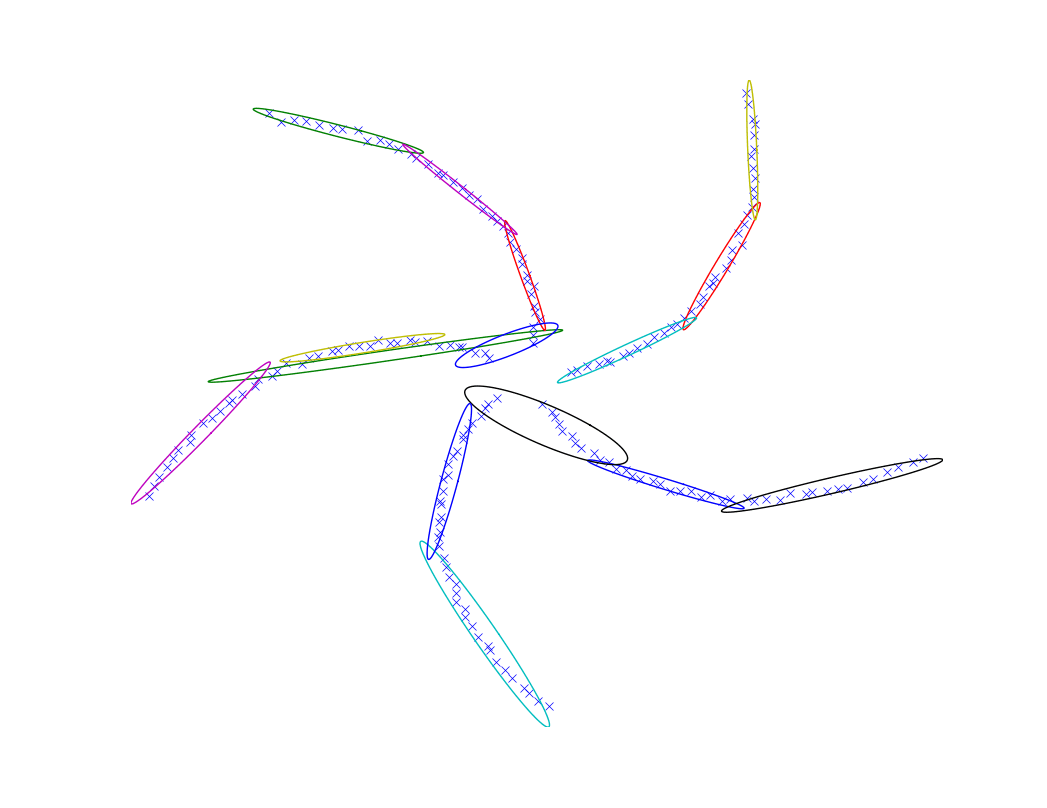 利用 Autograd 实现的高斯混合模型(GMM)聚类可视化
神经网络:examples/neural_net.py 展示了从零实现一个多层感知机,涵盖前向传播、交叉熵损失、反向传播的完整流程。
卷积网络:examples/convnet.py 用纯 NumPy + Autograd 实现了卷积层和池化层,无需任何张量库——这在当年是"教科书级别"的演示。
变分推断:examples/variational_autoencoder.py、examples/black_box_svi.py 展示了如何用 Autograd 对 ELBO(证据下界)求导,实现贝叶斯神经网络的变分推断。
高斯过程:examples/gaussian_process.py 展示了用 Autograd 计算 GP 超参数的梯度,实现自动超参数优化。
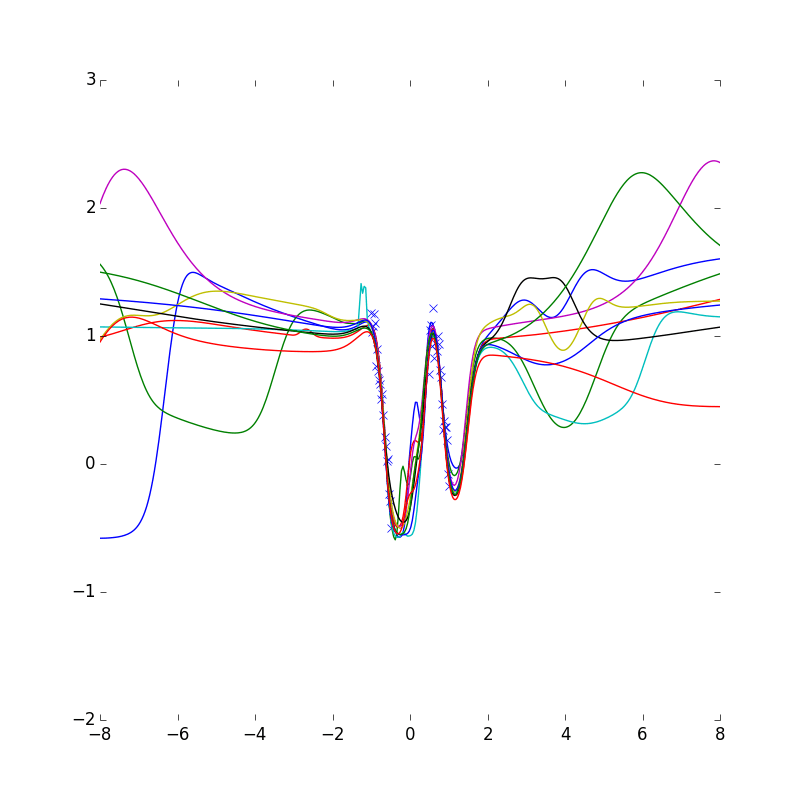 贝叶斯神经网络的预测不确定性可视化,体现了 Autograd 在概率编程中的应用
Autograd 并非银弹,以下场景需要注意:
1. 原位赋值(In-place Assignment)受限
# Autograd 不支持以下操作
A = np.zeros(3)
A[0] = 1.0  # 报错!
因为原位赋值会破坏计算图的可追溯性。这在实际工程中是一个需要适应的限制。
2. 纯 NumPy,不支持 GPU Autograd 只能运行在 CPU 上的 NumPy 数组。对于大规模深度学习任务(需要 GPU 加速矩阵运算),Autograd 并不适用——这正是它的"继任者" JAX 所解决的问题(JAX 底层基于 XLA,支持 GPU/TPU)。
3. 已停止主动开发
项目自 2018 年后不再有重大更新,Dougal Maclaurin 等核心开发者已转向 JAX。维护者仅负责 bug 修复和兼容性更新。但注意:项目并非归档状态(archived: false),仍处于活跃维护(最后更新:2026-09-21)。
Autograd 的历史地位远超其代码量本身:
| 维度 | 评估 |
|---|---|
| 定位 | 纯 Python 自动微分引擎(NumPy → 梯度) |
| 上手难度 | ⭐ 极低——pip install 后一行代码即可求导 |
| 适用场景 | 小规模 ML 原型、科学计算、算法研究 |
| 不适用 | 大规模深度学习、需要 GPU 加速的生产系统 |
| 代码质量 | ⭐⭐⭐⭐⭐ 源码精炼,模块化良好,文档完整 |
| 社区活跃度 | 低(核心开发者已转向 JAX),但问题响应及时 |
如果你在研究新算法、需要快速验证梯度推导,或者只是想理解自动微分的原理——Autograd 仍然是最好的起点。它的"最小化一切"哲学,使得从想法到梯度验证的路径被压缩到了极致。
