
cascade-memory-bank
GreatScottyMac/cascade-memory-bank加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你在用 Windsurf IDE 写代码,和 Cascade AI 聊得热火朝天——它帮你分析了一个复杂的模块架构,你们花了半小时理清了数据流。第二天你打开项目,想继续推进,却发现 AI「失忆」了:「抱歉,我没有之前会话的上下文。」
所有 AI 编程工具的通病:它们天生没有长期记忆。
每次新建会话,都是一次全新的开始。AI 无法知道你之前为什么选了这条路、哪个方案被否决了、哪些技术债务还没清。它只能看到当前打开的文件,而项目的全局上下文——架构决策、产品愿景、待办事项——全部丢失。
这就是 Cascade Memory Bank 试图解决的问题。
Cascade Memory Bank 不是又一个 AI 代码补全插件,也不是什么花哨的 GPT 包装器。它本质上是一个结构化的项目记忆协议——一套 .windsurfrules 配置文件,告诉 Cascade AI:「每次开始新会话,先把这些文件读一遍。」
核心机制非常简洁:项目根目录下放一个 memory-bank/ 文件夹,里面包含四个 Markdown 文件:
| 文件 | 作用 |
|---|---|
activeContext.md | 当前会话状态:目标是什么、卡在哪里、有哪些悬而未决的问题 |
productContext.md | 产品上下文:项目做什么、核心组件有哪些、架构规范是什么 |
progress.md | 进度追踪:完成了什么、正在做什么、下一步做什么 |
decisionLog.md | 决策日志:为什么选了这个方案、放弃了哪些备选、有哪些架构约定 |
AI 每次启动时,会自动读取这四个文件,把整个项目上下文装进「脑子里」。这就像给 AI 配了一本随身工作手册——不是让它自己去猜,而是你主动告诉它项目的来龙去脉。
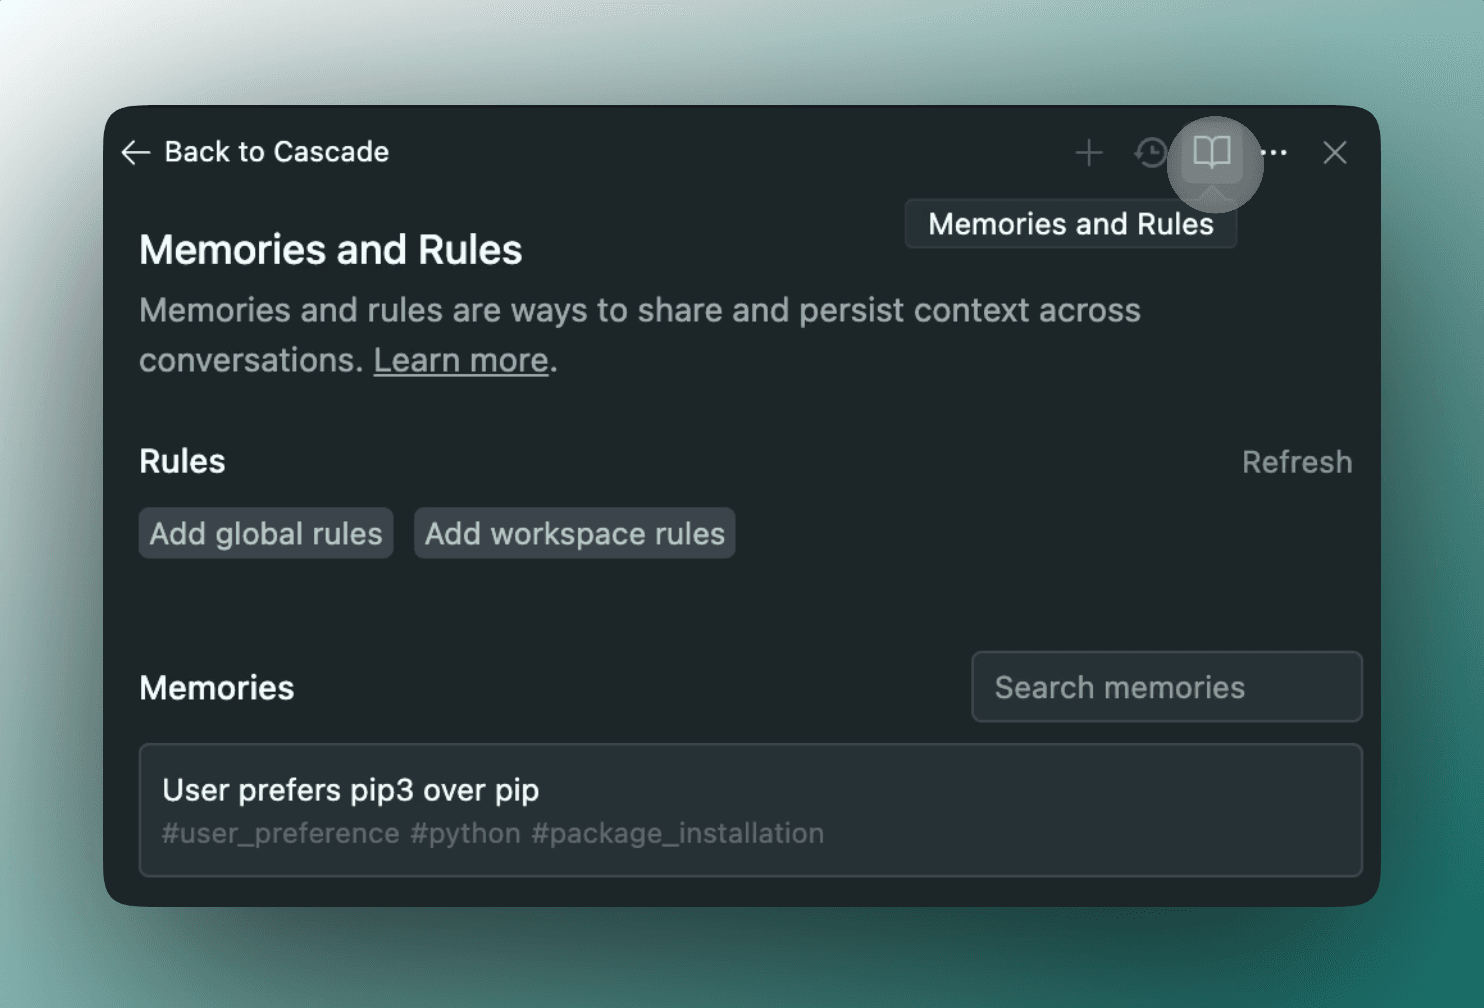
图:Windsurf IDE 中 Memory Bank 的配置界面。设置路径:Ctrl+, → Configuration → 关闭 Auto-Generate Memories
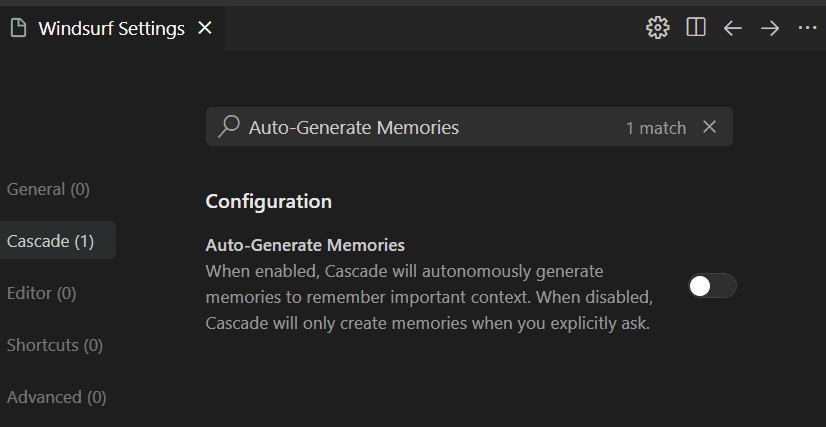
图:将 Auto-Generate Memories 关闭后,AI 将优先使用 Memory Bank 中的结构化记忆,而非自行生成的碎片化摘要
这个工具最直接的受益者有两类:
第一类:长期维护复杂项目的开发者。 比如一个涉及微服务、数据管道、前端后端联动的大型系统。开发者在不同会话里可能相隔几天甚至几周。每次重新进入,都需要花时间回忆:「上次那个接口的参数我改了没有?Redis 缓存策略是怎么定的?」有了 Memory Bank,这些信息早就沉淀在 decisionLog.md 里,AI 直接拿来用,不需要人工复述。
第二类:和 AI 结对编程的团队。 一个人和 AI 完成了架构设计,换一个人接手,或者第二天自己继续,都面临上下文断层。Memory Bank 把会话中的关键决策自动文档化,形成一个持续更新的项目知识库。人的知识转移成本大大降低。
从 GitHub 数据看,这个项目目前 94 Stars,12 Forks,主要在 Windsurf 生态内使用,没有 Docker 支持,没有独立服务,属于「工具类」而非「产品类」开源项目。
这是 Cascade Memory Bank 另一个有趣的地方:它几乎没有代码。
仓库里只有几样东西:
.windsurfrules — 定义 Cascade AI 的行为规则(YAML 格式,5000+ 字符)memory-bank/ 目录结构(需要用户自己创建或由 AI 初始化).windsurfrules 是整个系统的核心。它定义了:
[MEMORY BANK: ACTIVE] / [MEMORY BANK: INACTIVE],每次回复前必须标注当前状态Update Memory Bank,手动触发一次完整的上下文同步这套设计巧妙之处在于:它不需要任何运行时依赖。不需要安装包、不需要配置服务器、不需要懂 Docker。只要把 .windsurfrules 复制到项目根目录,告诉 Windsurf 加载它,一切就工作了。
公平地说,这个项目也有一些值得讨论的局限:
第一,AI 执行规则的可靠性依赖 Cascade 本身。 .windsurfrules 本质上是给 Cascade AI 的指令。指令能否被严格遵守,取决于 Cascade 对 .windsurfrules 文件的支持程度。如果 AI 忽略或曲解了规则,Memory Bank 的效果就会大打折扣。这是一个「元工具」——它的表现受制于底层 AI 的听话程度。
第二,记忆的质量取决于开发者的维护习惯。 Memory Bank 提供了一个框架,但如果开发者不坚持在决策后更新日志,久而久之这些文件就会和项目实际状态脱节,变成「纸面记忆」而非「真实记忆」。工具再好,不用也白搭。
第三,当前版本仅支持 Windsurf IDE + Cascade AI。 对使用其他 AI 编程工具(Cursor、Copilot、Claude Code)的用户来说,这套规则体系无法直接迁移。生态锁定是客观存在的限制。
第四,MIT License 但仓库无 License 文件。 README 中提到 MIT License,但仓库里实际上没有 LICENSE 文件。这在法律上可能造成歧义——虽然作者在 README 中声称了许可证,但严格的开源合规通常要求 LICENSE 文件单独存在。
Cascade Memory Bank 背后反映的趋势值得注意:AI 编程正在从「即时生成」进化到「持续理解」。
早期 AI 编程工具的思路是:给一个 Prompt,AI 立刻生成代码。现在大家越来越意识到,代码生成只是冰山一角——真正决定开发效率的,是 AI 对项目全局的理解深度。上下文管理、项目记忆、架构一致性,这些问题的优先级正在上升。
从这个角度看,Cascade Memory Bank 是一个有代表性的实验:它用最轻量的方式,在 AI 编程工具中引入了结构化的长期记忆机制。虽然目前还比较初级,但它指向的方向——让 AI 从「单次 Prompt 响应者」变成「项目知识的持续建设者」——可能是未来几年 AI 编程工具进化的重要方向。
后续可以关注的方向:自动生成 decisionLog.md 的 LLM prompt 优化、与 Git hooks 集成实现记忆自动同步、支持更多 IDE 和 AI 模型的通用化适配。
