
goodai-ltm-benchmark
GoodAI/goodai-ltm-benchmark加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有过这种体验:和 AI 聊了半小时,回头问它"我们刚才说的那个项目叫什么来着",它一脸茫然?这不是你的错觉——大模型的长期记忆能力,远没有它们的推理能力那么光鲜。一个刚通过律师资格考试的模型,可能转头就忘了你上周告诉它的咖啡偏好。
这就是 GoodAI LTM Benchmark 诞生的背景:给大模型的"记忆能力"打分的标准化工具。
 GoodAI 标志:半机械半有机的猫头鹰,象征着有机智能与机器学习的融合
故事要从捷克首都布拉格说起。GoodAI Research 是一家创立于 2014 年的人工智能研究公司,十年来专注一件事——让 AI 真正记住你说的话。2024 年 1 月,他们在持续学习(Continual Learning)领域的多年积累终于开花结果,开源了这个 LTM Benchmark 项目,并同步发布了一篇详细的博客文章介绍研究动机。
项目发起人 Andrej Bažány 在博客中写道:当前的 LLM 基准测试几乎全部聚焦于"即时推理"——给一道题,模型在单次上下文窗口内作答。但真实世界的对话完全不同,用户和 AI 的交流可能是跨越数周、数月的漫长对话,其中夹杂着闲聊、任务切换、信息更新。模型需要在"上下文记忆"之外,额外掌握"外部化长期记忆"的能力。
这个项目的独特之处在于:GoodAI 不仅仅开源了评测工具本身,还把自研的 LTM Agent 方案和部分实验数据也一并公开,形成了目前 GitHub 上最完整的 LLM 长期记忆能力评测生态。
传统的 AI 评测就像一场开卷考试——所有信息都塞在 prompt 里,模型只需要"翻书"。但 GoodAI LTM Benchmark 的设计思路完全不同:它模拟的是真实的人类对话场景,关键信息被埋在大量"填充噪音"之中,模型必须依靠外部记忆系统来检索和使用这些信息。
项目内置了 12 个测试数据集,覆盖了不同的记忆挑战场景:
| 数据集 | 考察的记忆能力 |
|---|---|
| chapterbreak | 在超长上下文中定位关键章节信息 |
| prospective_memory | 记得在未来某个时机执行某动作 |
| shopping | 多轮购物偏好信息的保持与检索 |
| restaurant | 预约偏好和饮食限制的长期记忆 |
| sallyanne | 跨多轮的人物关系与事实追踪 |
| name_list | 长列表中精确匹配人名 |
| spy_meeting | 加密情报的长期存储与提取 |
| colours / jokes / locations_directions / trigger_response | 各类动态记忆更新与场景推理 |
每个数据集都能生成大量随机化的测试实例,这意味着同一个模型可以被反复测试而不产生数据泄露。通过配置文件(.yml),用户可以自定义对话长度、填充噪音量、记忆跨度等参数。
对于开发者来说,这个项目上手门槛非常低。只需几步配置,就能对任何支持的模型发起评测:
第一步:安装依赖(Python 3.10+)
git clone git@github.com:GoodAI/goodai-ltm-benchmark.git
cd goodai-ltm-benchmark
pip install -r requirements.txt
第二步:配置 API Key
export OPENAI_API_KEY=your_key_here
# 可选:支持 Anthropic、Google Gemini 等多后端
第三步:运行评测
python run_benchmark.py \
    -c ./configurations/published_benchmarks/benchmark-v3-500k.yml \
    -a gpt-4-turbo -m 4096
-c 指定评测配置,-a 指定评测模型(支持 GPT、Claude、Gemini、MemGPT、GoodAI LTMAgent 等),-m 设置上下文 token 限制。
评测完成后,项目会在 data/reports/ 目录下生成一份完整的 HTML 可视化报告,包含各数据集的得分雷达图、详细响应日志、以及不同模型之间的横向对比。
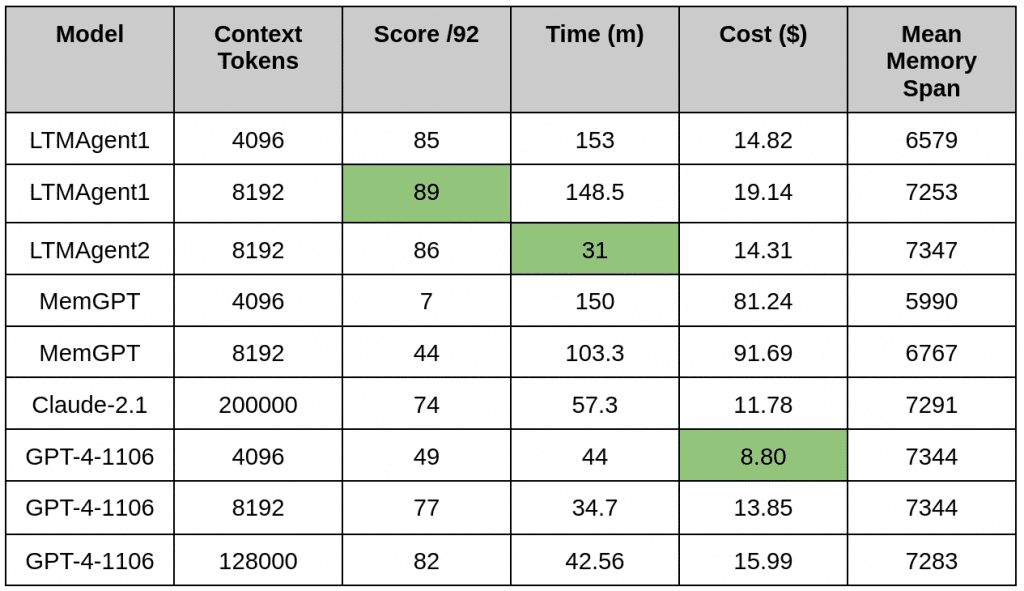 各模型在 1K 上下文基准测试中的得分对比,GPT-4 Turbo 和 Claude 3 Opus 表现突出
项目论文和博客中披露的实验数据很有意思:即使是最强大的商业模型,在缺乏外部记忆系统加持的情况下,面对超过 2 万 token 的长对话时,准确率也会显著下滑。
特别值得关注的是 GoodAI 自研的 LTMAgent:它在 8K 上下文限制下,得分比 GPT-4 Turbo 更高。这背后的原因是它采用了"语义检索 + 查询生成 + JSON scratchpad"的混合架构——模型不必把所有信息都塞进上下文,而是通过向量检索从外部记忆模块中按需提取。
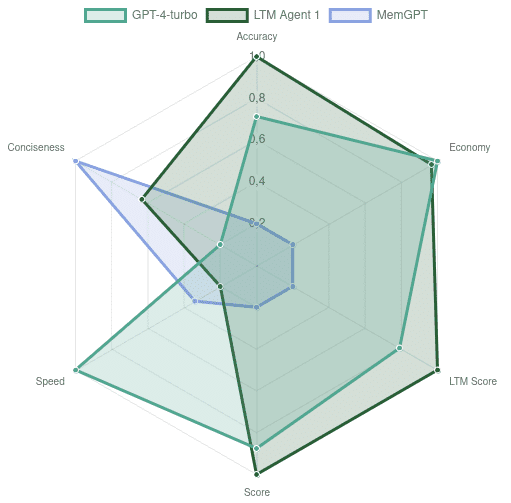 GoodAI 博客中展示的模型能力雷达图,不同颜色代表不同模型在各项指标上的表现
不过,评测结果也揭示了 MemGPT(一个基于 LangChain 的外部记忆方案)在某些任务上的局限:它依赖向量检索来获取历史信息,但在"prospective memory"(前瞻记忆)这类需要精确时间戳推理的场景中表现欠佳。
从代码结构来看,GoodAI LTM Benchmark 的架构设计相当规范:
datasets/):测试数据生成器,每个数据集对应一个 Python 类,支持随机化实例生成和条件过滤model_interfaces/):统一的模型接口层,定义了 Agent 基类,兼容 OpenAI、Anthropic、litellm 等多种后端runner/):评测执行引擎,负责测试实例生成、并发控制、结果收集reporting/):Jinja2 模板驱动的 HTML 报告生成器,支持详细报告和横向对比报告两种模式项目大量使用了行业标准库:LangChain 作为 Agent 编排框架,litellm 作为统一的多后端调用接口,tiktoken 做 token 计数,Flask 提供轻量级报告预览服务。
评测范围偏学术:项目目前主要面向 LLM 研究社区,缺少图形界面,命令行门槛较高。
部分依赖闭源模型:评测结果的"天花板"取决于 GPT-4、Claude 等闭源模型的性能,学术复现存在一定门槛。
许可协议不明确:项目采用 "NOASSERTION" 许可(非标准许可证),实际使用前建议仔细阅读 LICENSE 文件确认适用性。
生态较薄:相比 OpenCompass、EleutherAI Hard 等主流评测框架,这个项目目前的 star 数量和社区贡献规模都较小。
大模型的"记忆能力"正在成为下一代 AI 系统的核心战场。从 RAG 到 MemGPT、GoodAI LTMAgent,再到各家的 Agent 产品,让模型"记住过去"已经和"推理当下"同等重要。
GoodAI LTM Benchmark 的价值在于:它提供了一套相对客观的衡量标准,让研究者可以横向比较不同记忆方案的效果。随着长上下文模型(如 Gemini 1.5 的 2M token 上下文)逐渐成为标配,这场"记忆力竞赛"才刚刚开始。
如果你在构建需要长期记忆的 AI 应用,这个项目值得加入你的工具箱。
