
paper-qa
Future-House/paper-qa加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
设想一个场景:你是生物医药公司的研究员,手上有一篇关键的临床前论文,想知道"这项机制在体内是否真的成立"。你把 PDF 丢给通用大模型,它给出一段流畅自信的答案——但你无法判断哪句话是论文里的,哪句话是模型编的。
这正是 Future House 团队在 2023 年遇到的问题。他们是一家由 OpenAI 校友 Sam Rodriques 等人创办的 AI for Science 公司,核心信念是:科学文献的信息密度远超通用网页,AI 若要真正进入科研工作流,就必须先解决"可信、可溯源"这件事。
他们的答案叫 PaperQA——最初只是一段脚本。后来演化成 PaperQA2,并因在 2024 年 9 月的论文《Language agents achieve superhuman synthesis of scientific knowledge》中宣布"在文献检索任务上超越博士级生物研究者"而一夜成名。
PaperQA2 本质是一个 Agentic RAG(智能体式检索增强生成) 框架。与常见的"把文档切块 → 向量检索 → 塞进提示词"不同,它把 RAG 拆成了两个关键机制,这也是它成绩领先的真正原因。
机制一:带查询扩展的智能体工作流。 候选文档不是靠一次向量检索得到的,而是由 LLM 通过工具调用去触达全文本搜索引擎(内建 Tantivy 全文索引)、Semantic Scholar、Crossref、OpenAlex 等外部搜索 API。拿到候选答案后,Agent 会评估这个答案,如果不满意,它可以重新发起不同角度的搜索、重构问题、补充证据——是一个会"反悔"的多轮循环,而不是一次性问答。
机制二:重排序与上下文摘要(RCS, Re-ranking and Contextual Summarization)。 检索回来的只是碎片。PaperQA2 先用 LLM 对碎片做重排序,挑出真正相关的;然后对每一份入选文档做上下文摘要,把整篇论文压缩成与问题强相关的高密度摘要段落,再送入最终的答案生成环节。这个设计直接对应了它的一个反直觉特性:文档越多、越"厚",答案不一定越好——因为无关长文本会稀释注意力。
上图是 PaperQA2 的衍生应用 WikiCrow 生成的条目:给人类基因的每个基因自动撰写维基百科风格的科学条目,准确度经盲评被认为高于人工撰写的维基百科现有条目。
PaperQA2 最有想象力的衍生项目之一是 ContraCrow。它的逻辑很直接:如果 AI 能读懂论文,那么让它逐条评估论文里的每个论断,再去整个文献库里找与之矛盾的研究,就能自动发现"新假设的线索"。
团队在随机抽取的生物学论文中,平均每篇找到 2.34 条被其他文献反驳的陈述。
这类"自动科学发现"的应用价值,在 AI for Science 语境下远大于一个检索工具本身。
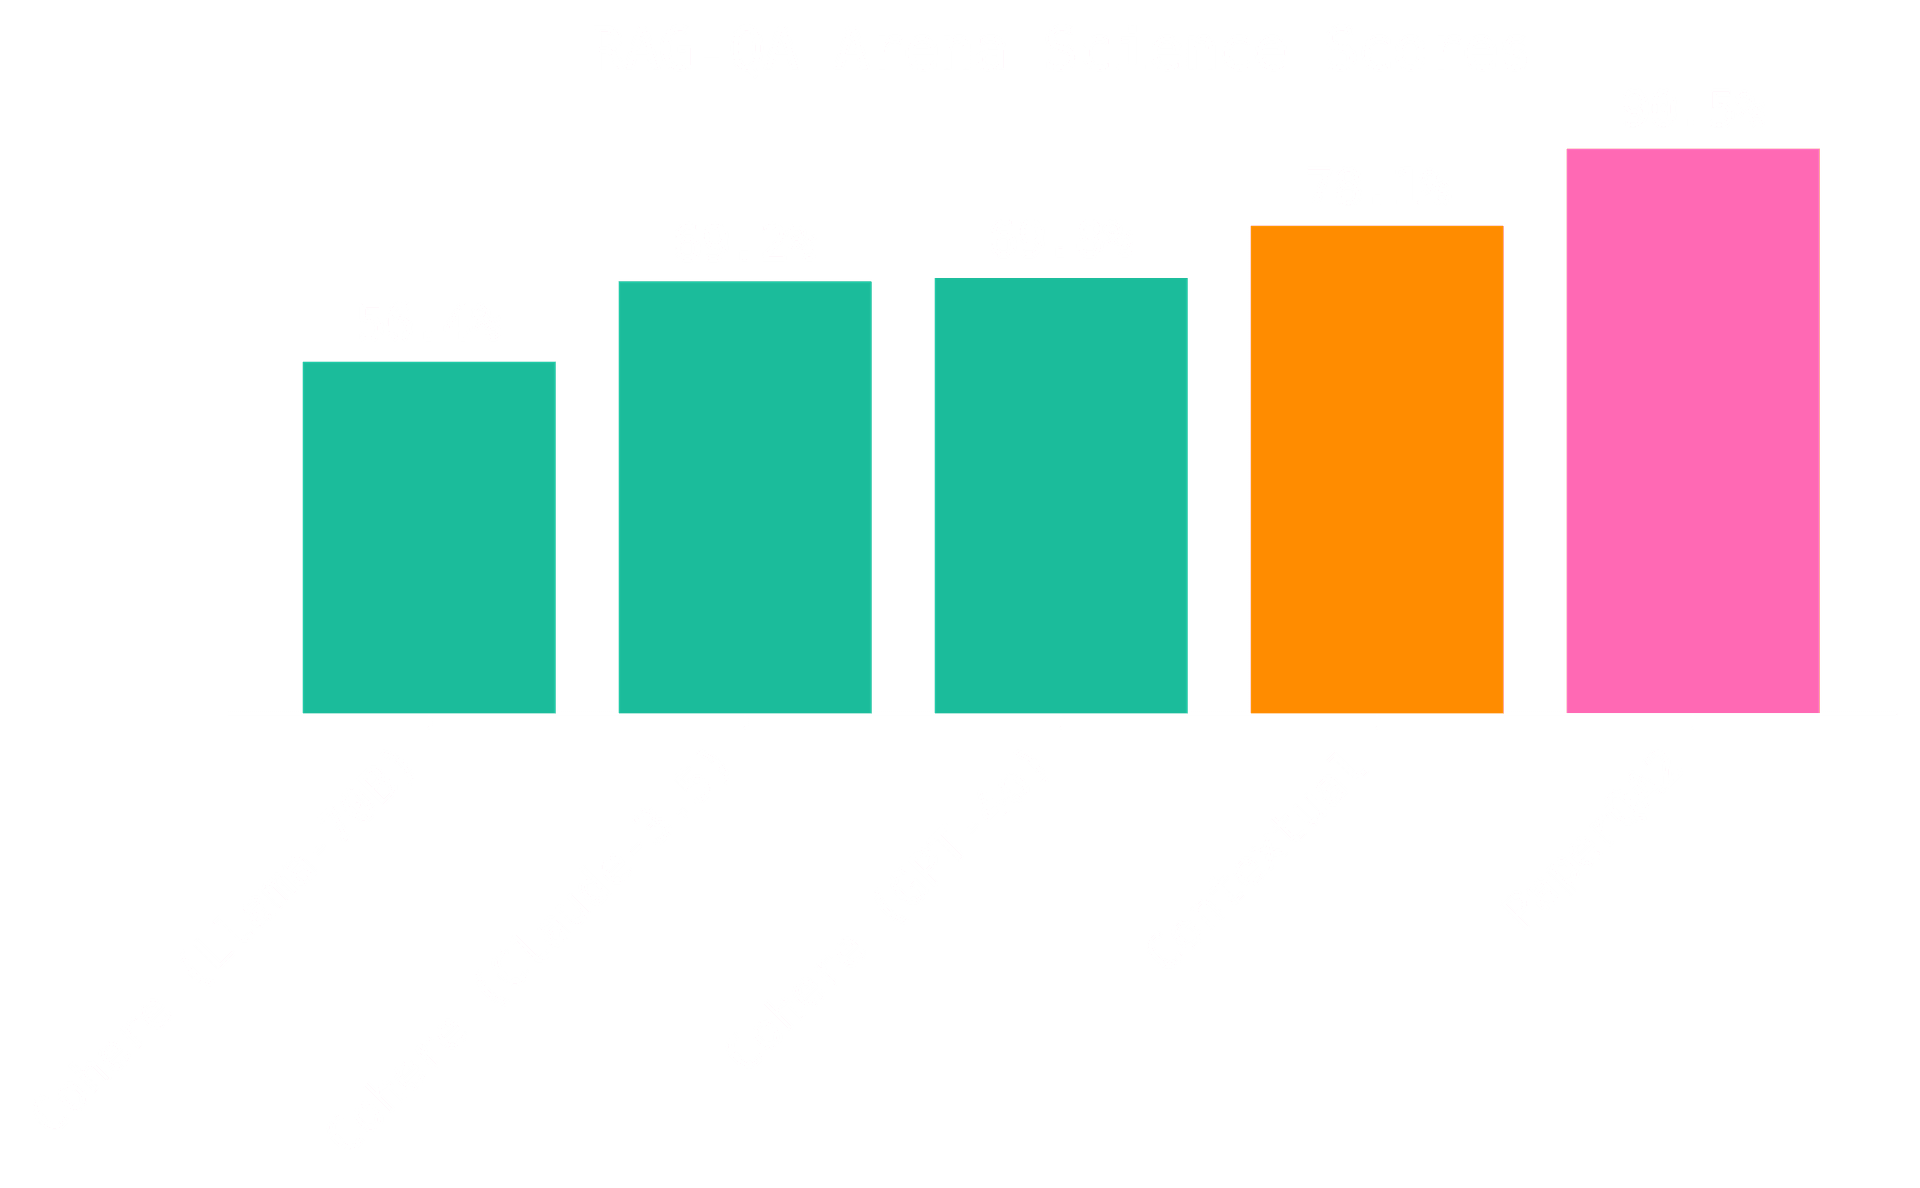
2025 年 3 月,Future House 把 PaperQA2 送上了 RAG-QA Arena 基准的科学子集——1404 道问题、170 万份文档。结果是 12.4% 的领先幅度,比第二名高出超过 10 分。
值得注意的是其定位:PaperQA2 明确不是为了做"廉价高并发"的 RAG,而是为"高成本、高精度"查询设计的。因此它的默认路径会调用多个外部元数据服务(Crossref 做引用计数与撤稿检查、OpenAlex 补元数据)、会跑多轮 LLM 调用——单次问答的 token 成本显著高于轻量方案。论文中自称的"高分"也因此建立在一个明显更贵的基础设施假设上。
这是选型时必须注意的一点:PaperQA2 本身不提供 Web 界面。仓库里没有 Dockerfile、没有 docker-compose、也没有 Streamlit/Gradio/Flask 层,它是一个 Python 库 + 命令行工具。
最简上手路径:
pip install paper-qa>=5
export OPENAI_API_KEY=sk-...        # 或配置任意 LiteLLM 兼容的本地模型
mkdir my_papers && cd my_papers
curl -o PaperQA2.pdf https://arxiv.org/pdf/2409.13740
pqa ask 'What is PaperQA2?'
几个实操要点:
requires-python = ">=3.11,<3.15"。pymupdf/pypdf/docling(PDF 解析)、zotero(对接 Zotero 文献库)、qdrant(外部向量库)、office(Word/Excel/PPT 解析)、nemotron(NVIDIA 文档解析)。usathyan/paper-qa-ui),但质量与安全性参差,需自行评估。成本与延迟不可忽视。 多轮 Agent + 重排序 + 逐文档摘要意味着单次问答可能触发数十次 LLM 调用。对预算敏感或需要低延迟的场景(比如给分析师做实时推荐),这是真实的架构障碍。
对闭源模型生态有依赖。 项目以 Apache-2.0 开源,但核心能力(Agent 的判断力、RCS 的摘要质量)高度依赖底层模型能力。用小开源模型跑 PaperQA2,效果大概率无法复现论文中的分数。
Web 能力缺失影响企业落地。 科研人员不写代码是常态。PaperQA2 把 UI 的活儿留给了社区和企业自己,导致生态碎片化——大量功能雷同、质量参差的第三方 UI 项目。
基准选择的争议。 RAG-QA Arena 采用"LLM 判定偏好"的方式打分,属于模型评判(LLM-as-judge),方法学上一直存在争议,且 Future House 自己承认"从 Contextual 的前期工作看,确切方法论并不明确"(例如 retrieval@k 等超参数设置未完全透明)。
科学结论仍需人工把关。 "能检测矛盾"意味着"会误报矛盾"。工具输出的是候选线索,不是结论。
从 2023 年 2 月创建到 2026 年 10 月仍有活跃提交(最新推送 2026-10-26),PaperQA2 已经走过了三年多的迭代,并从"一个 RAG 库"演化成"一套分层配置体系"——仓库内提供了 fast、high_quality、wikicrow、clinical_trials、tier1~tier5_limits 等多套预设配置,用"等级"来对应不同的成本/精度档位。2025 年 12 月起项目采用 CalVer(日历版本号)发布策略。
更值得关注的是它的技术路线选择:PaperQA2 没有去卷"更大的模型"或"更花哨的向量库",而是把力气花在了工作流设计(Agentic + RCS)上,并用严格的证据链把每一句结论锚定到原文页码。这条路线与整个 AI for Science 赛道的需求高度吻合——在这个领域,可验证性比流畅度重要一个数量级。
它也标志着开源 RAG 从"通用文档问答"走向"垂直领域深度应用"的一个样本:真正能跑赢 SOTA 的,往往不是更好的 embedding,而是更聪明的证据筛选与引用生成流程。
如果你手上有批量文献、需要带出处的答案,并且愿意为精度付出 LLM 成本,PaperQA2 值得认真评估。它不是最轻的方案,恰恰相反——它把成本换成了准确率。但当"答案必须可核查"成为硬约束时,这种交换是值得的。
部署提示: 本项目无官方 Web UI 且无容器化配置,通过 pip install + 命令行使用最顺畅,建议按"库/CLI 集成"而非"独立服务部署"来规划落地路径。
