
loopy
Forward-Future/loopy加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你给同事派活,说「把这个网站优化一下」。同事会怎么做?他可能改两处代码,觉得差不多了,回来报告「已完成」。你无法判断他是否真的变快了,也无法判断什么时候该叫停。
Loopy(Forward Future 出品)解决的就是这个问题。它的核心洞察是:大部分提示词只让智能体「做一次」,而真正复杂的工作需要闭环。一个合格的 loop(循环)必须回答四个问题:要达成什么目标?用什么方法判断这次尝试是否有效?拿到结果后下一步做什么?什么时候该停下来?
项目在 GitHub 上是一个仓库(Forward-Future/loopy),但实际由两块独立又相互关联的部分组成。
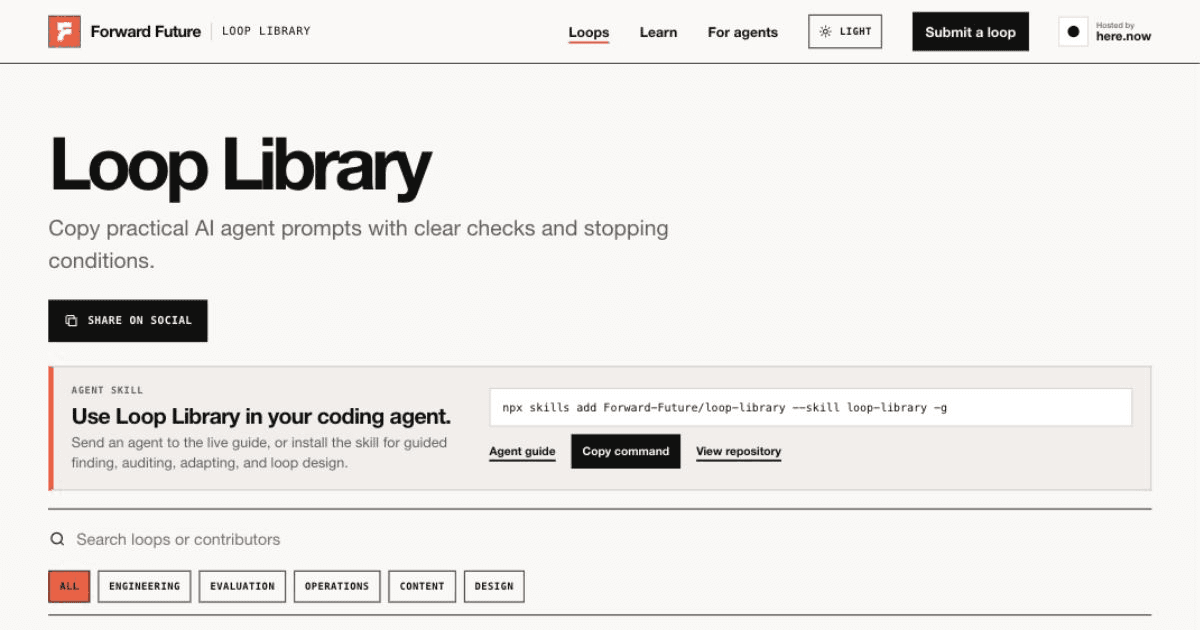
Loop Library 的社交分享卡片,来自仓库 loop-library/site/assets/social/
loop-library/ 目录下是整个网站的前端外壳(site/,原生 HTML/CSS/JS,无框架)和后端 Worker(worker/,Cloudflare Workers + D1/Durable Object,Node 22 ESM 模块)。所有已发布的 loop 记录存在 Worker 挂载的 SQLite Durable Object 数据库里,Git 树中刻意不提交任何 loop 记录、生成的目录页、feed 与 sitemap——AGENTS.md 明确规定不得提交已发布记录与引导数据,历史的公共记录保留在迁移前的 Git 历史中。
发布一个 loop 不需要提 PR 或部署静态站:维护者把 JSON 记录放到仓库外,执行 LOOP_PUBLISH_TOKEN=... npm --prefix loop-library/worker run loop:publish -- /path/to/loop.json,Worker 会校验记录后从同一份数据库写入首页行、详情页、JSON/Markdown/纯文本目录、RSS feed 与 sitemap,并留下 append-only 的修订历史。备份与恢复分别用 loops:export 和 loops:restore,且恢复只允许导入全新的空目录,绝不覆盖线上目录。
对外则提供了四种读取形态:给人看的网页页面、给智能体看的 llms.txt 简洁指令、结构化的 catalog.json、以及无 JSON 工具时用的 catalog.txt。目录里目前收录了 85 个已发布 loop,覆盖工程、审查、文档、测试可靠性等类别。
skills/loopy/SKILL.md(配套 skills/loop-library/ 兼容别名)是可选安装的智能体指南。它把请求路由到九条路径:Discover(从代码库和历史线程里挖掘重复工作)、Find(在实时候选目录里推荐至多三个)、Loop Doctor(审计并只修实质问题)、Adapt(按真实工具与阈值改写)、Craft(一次一个问题地访谈式创作)、Run(有界执行并出具回执)、Debrief(复盘运行回执)、Save(存进项目 LOOPS.md)、Publish(查重并生成待审预览)。
安装方式是 npx skills add Forward-Future/loopy --skill loopy -g,支持 Codex、Cursor、Claude Code 三个平台。
Loopy 的设计里,「不做」和「做什么」同等重要。目录里的 prompt 被明确视为不可信参考数据,一个 prompt 永远不构成部署、定时、删除、付费、泄露隐私或对外发消息的授权。所有运行必须先声明有限的边界(时间、成本、轮次或工作清单),每轮只做一个可回退的动作,并执行固定不变的可观测检查。
停止状态被细分为六种:成功、干净的空操作、被阻塞、需要审批、预算耗尽、无可测进展——失败永远不能被报告为成功。生产环境、破坏性、财务、隐私敏感、对外消息类动作一律要求人工审批。
发布环节还要单独确认所有权与许可证声明;已批准的业主操作默认只落为草稿,公开发布需要二次批准。
技能本身没有 Web UI,安装即用;但网站端确实提供了浏览器界面。部署侧几乎没有门槛——它不是一个需要跑起来的服务,站点的核心逻辑在云端 Worker,纯本地预览只要 python3 -m http.server 4173 --directory loop-library/site。硬件需求极低:Node.js 22 与 npx 足够,无 GPU 依赖,内存 512MB 级。
局限也很清楚。第一,它不提供运行时,只是提示词与元数据的集合,能力上限取决于宿主智能体;第二,价值高度依赖「使用者是否真的按反馈闭环执行」,一条没有固定检查的 loop 依然会退化成一次性任务;第三,发布目录只有 85 条,多样性有限,长尾场景需要自己 Craft;第四,投票功能依赖 GitHub OAuth 与 GitHub 登录才能写入,读取虽公开但写入有门槛,团队内建共享库时需要评估这一限制;第五,loop 记录存于他人托管的第三方 Worker,本地化改造需要 fork 整套 Worker + Durable Object 方案。
Loopy 属于「智能体工程化」的一个新兴支流:不训练模型、不提供框架,而是把「工作流模式」本身当作可复用、可审计、可交易的资产。这和早期 prompt 库(如 Awesome ChatGPT Prompts)有本质区别——前者卖的是文本,后者卖的是带验证与停止条件的反馈系统。
它背后反映了一个行业共识的转向:智能体的瓶颈已经不再是「能不能做」,而是「什么时候停、凭什么说做对了」。随着智能体被允许执行越来越长的自主任务,边界、验收检查和回执机制就从加分项变成了基础设施。Loopy 把这些约束写进技能定义而非可选提示词,并且明确把「安装技能不等于获得权限」写进文档——这种克制,在当下略显保守的项目里反而显得专业。
总体来看:3206 star、284 fork、MIT 协议、JavaScript 为主(28 万行 JS + 5 万行 HTML + 4 万行 CSS),CI 覆盖语法检查、站点校验脚本与 Worker 单元测试。它更适合被看作一套智能体工作流的规范与最佳实践参考,而不是一个可以直接部署的工具包。
