
FreeToken
FlashML-org/FreeToken加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你想在自家游戏电脑上跑一个真正"聪明"的大模型——不是 7B、不是 14B,而是 DeepSeek-V4、GLM-5.2 这种 700B 级别的 MoE 巨兽。你打开任务管理器,看着那张 24GB 显存的 RTX 4090,心里默默算了一遍:光是 290B 参数就算 4bit 量化也要 145GB,差了六倍。于是你打开 Ollama、LM Studio、vLLM 官方发行版,翻遍所有选项,每一份文档都在重复同一句话:需要多卡互联、或者显存够大。
这不是你的错,是过去十年的推理系统都建立在一个前提上:服务端的形态是"一台大机器"。vLLM、SGLang、TensorRT-LLM 都假设你可以拿到 8 张 H100、NVLink 交换机、以及一个能塞进机架的机箱。于是"本地跑大模型"在实践中被压缩成"本地跑小模型"。
FreeToken(GitHub: FlashML-org/FreeToken)的赌注正是在这里:它不假设你有一台大机器,而是把你的个人电脑当成一个统一的、弹性的推理平台。
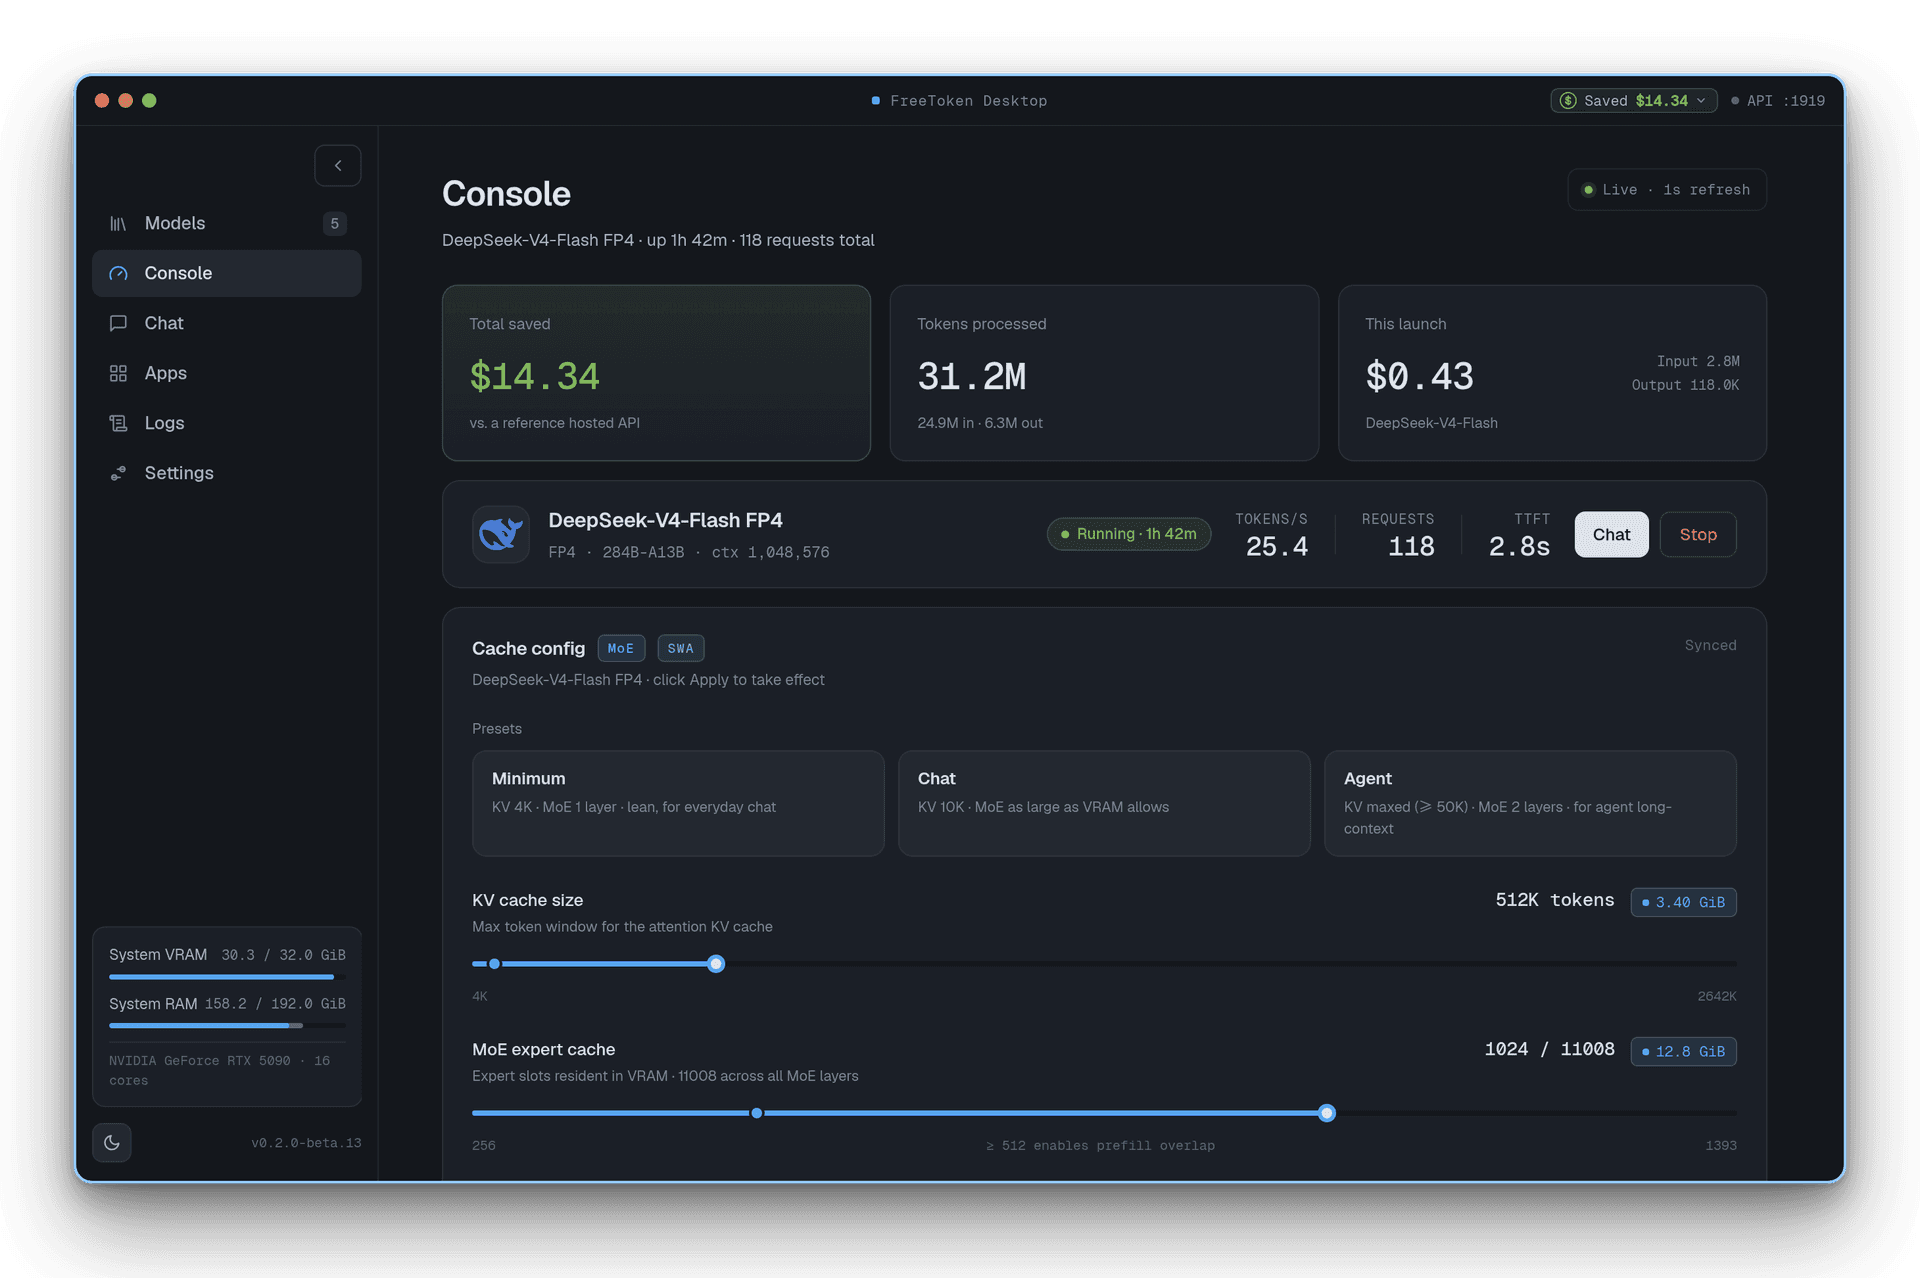
图:FreeToken 桌面版控制台,提供模型运行、对话与引擎调参的一体化图形界面
FreeToken 并非某个人的周末项目。它背后是 arXiv 论文 2608.16157,作者包括 Shuo Yang、Melissa Pan(UC Berkeley)、Kurt Keutzer、Matei Zaharia(UC Berkeley,Spark 之父)、Song Han(清华/UT Austin)、Ion Stoica 等——这份作者名单几乎覆盖了系统与机器学习硬件两个圈子的头部人物。
论文标题是《FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution》。核心论点一句话说完:当稀疏激活让"大模型能跑"变成可能之后,本地推理的瓶颈就从"模型能不能装进显存"转移到了"系统能不能调度好这台机器"。
论文于 2026 年 8 月 17 日提交 arXiv,同月项目开源,迅速积累 14,700+ Star、1,478 个 Fork、17 位贡献者。目前版本为 v0.2.0(2026-10-21 发布),并保持着每日滚动构建的 nightly 版本。
理解 FreeToken 的关键,是理解它的两级专家内存层级。
想象你要开一家面馆,菜单上有 300 道菜(300 个专家),但你只有一张小餐桌(8GB 显存)。传统做法只有两种:要么把 300 道菜都塞进冰箱再全端出来(显存爆掉),要么只做 5 道菜(放弃模型能力)。
FreeToken 的做法像中央厨房 + 店面:
但这还只是"静态"的。FreeToken 更进一步的是弹性:显存里专家缓存和 KV Cache 的比例可以在运行时动态调整,不需要重启引擎、不需要重新加载权重。这就像面馆高峰期把"包厢"临时改成"大堂"——桌子还是那些桌子,摆放方式变了。
论文里还提出一个关键的执行策略 $q^\star$(带宽自适应 CPU–GPU 协同执行):系统实时测量 PCIe 带宽和计算瓶颈,决定这一批 token 是留在 GPU 上算,还是分一部分到 CPU 上算。所谓"bandwidth-adaptive",就是这个自适应旋钮。
这是我认为 FreeToken 最被低估的功能。
传统 KV Cache 只能对"完全相同的前缀"复用。但 Agent 场景下,前缀经常变:工具调用结果插进来、思考块(thinking block)被裁剪、上下文被编辑。这时候前缀缓存全部失效,前缀要重新算一遍——在 290B 模型上,这是几十秒级的浪费。
FreeToken 引入语义锚点检查点(semantic anchor checkpoints):不只按 token 前缀对齐,而是按语义内容锚定。于是"我要撤回刚才那个工具调用"这种上下文编辑,不必重算整段历史。
预填充阶段(处理输入 prompt)时,每个 MoE 层都要把专家权重从主机内存搬到 GPU。串行做就是"搬完再算",总时间 = 搬运 + 计算。FreeToken 默认开启 overlap:第 N+1 层的搬运与第 N 层的计算同时进行,总时间 ≈ max(搬运, 计算)。
项目文档里还给出了很有诚实的调优指南(docs/performance/prefill.md):当专家缓存装不下两层时,服务器启动日志会明确打印 WARNING Disabling MoE prefill overlap: the slot cache cannot hold two whole layers of experts,用户需要调大 --moe-cache-size。这种"把失败原因明明白白写进日志"的工程态度,在开源推理引擎里并不常见。
FTW(Fast Weight)是 FreeToken 自己的 checkpoint 格式,配合 AOT(ahead-of-time)预编译内核,把"权重怎么存、怎么搬"这件事彻底重做。仓库里 scripts/ftw_hotfix.py 有 5 万行代码级别,专门处理老版本 FTW 检查点的修复——能看出这个格式迭代得有多快。
ft serve 起来后同时暴露:
/v1/chat/completions、/v1/responses、/v1/models/v1/messages、/v1/messages/count_tokens这意味着 Claude Code、Codex、OpenCode、OpenClaw、DeepSeek Harness 这类编码 Agent 几乎零改造就能指向本地服务。ft launch claude 一条命令会自动写入该 Agent 的 provider 配置、缺 CLI 就自动安装,然后拉起来直连你的本地引擎。
对个人用户来说,这是 FreeToken 最实际的杀手锏:把云端订阅费换成本地 GPU 电费。
官方标注为"已验证良好"的检查点覆盖:DeepSeek-V4 / V4.1-Flash、GLM-5.2 / 5.3-Flash / 4.7、Qwen3.6 / 3.8 系列(含 dense 与 MoE)、Qwen3-VL(视觉)、gpt-oss-120b/20b、Gemma-4、MiniMax-M2.5 / M3、Muse-Glimmer。量化格式覆盖 MXFP4、NVFP4、FP8、BF16。
论文原文声称"支持 20+ MoE 模型",并在 8GB 笔记本 GPU 到单张工作站 GPU 的硬件跨度上完成了真实编码与工具调用 Agent 的端到端验证。
从 flashml.ai 下载 Windows / Linux 桌面版,图形界面点选完成引擎配置、模型加载与对话。适合不想碰终端的用户,但桌面应用是闭源发行物,核心引擎仍是上面这个 Apache-2.0 开源仓库。
uv venv && source .venv/bin/activate
uv pip install "freetoken[accel]"
[accel] extra 会额外装上 FlashInfer 与 sglang-kernel 的原生融合内核;不装则回退到纯 Triton 内核,性能会明显打折。源码安装则是 uv pip install -e ".[accel]"。
⚠️ 硬性前提:Linux x86_64 + NVIDIA GPU + 驱动 r580 及以上(CUDA 13)+ Python 3.10+(推荐 3.12)。Windows 与 macOS 用户只能走桌面应用或 WSL(且 WSL 有 pinned memory 限制,会让 overlap 关闭)。
ft serve --model ~/models/Qwen3.6-35B-A3B
# 就绪标志:API server is ready to serve on 127.0.0.1:1919
其余参数(dtype、attention 后端、MoE 后端、缓存大小、工具调用与推理解析器)全部从 checkpoint 和 GPU 规格自动推导。终端聊天用 ft shell,接远端服务器用 ft shell --server URL(该模式不需要 GPU)。
ft daemon 是一个 torch-free 的控制面:只依赖标准库 + FastAPI + Uvicorn,绝不 import torch / CUDA / flashinfer。这不是洁癖,而是架构上的必需——CUDA fault 或原生扩展 segfault 会杀死加载了它们的进程,daemon 不加载任何这类东西,所以它能保证"引擎崩了控制面还活着",配合 systemd Restart=always 实现自愈。仓库里 tests/daemon/test_daemon_import_safety.py 用 import sentinel 把这条约束固化成测试。
开源项目最缺的就是"作者自己承认的坑",而 FreeToken 在这方面表现得出奇地坦诚。
硬件门槛是硬约束,不是软性建议。 "8GB 笔记本 GPU 跑 35B" 这类标题党数字背后,代价是 PCIe 上的持续权重搬运——这不是推理"变快了",而是把瓶颈从显存容量转移到了总线带宽和主机内存容量。真正的甜点区是 24GB+ 显存的机器。8GB 用户需要接受明显的速度妥协。
平台锁定在 NVIDIA。 Linux x86_64 + CUDA 13 是硬性要求。AMD ROCm 支持有独立安装文档,但文档自己标注为 "WIP"。macOS 用户基本无缘(Apple Silicon 的 Metal 后端不在支持列表内)。这与 llama.cpp 的跨平台普适性形成鲜明对比。
没有 Dockerfile / docker-compose。 我用 GitHub Code Search 在全仓库确认过,Dockerfile 命中数为 0,整棵 git tree 949 个文件、133 个 csrc 文件中也没有容器化配置。虽有 install.sh 和 systemd 单元文件,但那不是容器。对需要 K8s 编排的团队,这是一道额外的工程活。
生态仍然年轻。 v0.2.0、创建于 2026-07-20、469 个 open issues。issue 列表里大量是性能与正确性的精细问题——比如 fix(sampling): bound top-k before int32 conversion(大 top-k 值在采样准备阶段 int32 溢出)、perf(attention): drop redundant activation copies in glm5 dsa prefill(GLM-5 的 DSA 预填充存在冗余激活拷贝)。这些是系统项目正常的成长阵痛,但对生产环境意味着你得自己盯 issue。
成熟度标注。 pyproject 里 Development Status :: 4 - Beta,而且 Marlin W4A16 NVFP4 专家 GEMM 路径因为依赖 vLLM 的 AOT wheel(会 pin transformers<5,与核心要求的 transformers>=5.5 冲突)被排除在默认安装之外,需要单独环境安装。
许可证的隐藏成本。 代码本身 Apache-2.0(干净),但 vLLM、FlashInfer、SGLang 等上游组件各有自己的许可证。Flask 项目甚至在 pyproject 里专门写了注释解释为什么不能混用 License:: classifier 和 SPDX 字符串——这种细节级别的严谨,说明团队确实在认真对待发布合规。
把 FreeToken 放到更大的图景里看,它不是孤例。
"边缘 AI"这个词正在从营销词变成技术路线。 从 Llama 到 Qwen,模型参数规模在两年内翻了几十倍,而消费级显卡的显存只涨了 4-8 倍。供需缺口只会越来越大,FreeToken 代表的"在有限硬件上榨干每一份算力"是必然方向。论文里那句"上亿台消费级设备已经装着独立 GPU"就是这个逻辑的通俗版。
系统研究正在回流到消费级硬件。 这份作者名单(Zaharia、Han、Keutzer、Pan)本身就是信号:过去十年,顶级系统研究都在追求万卡集群的极致效率;现在有人在做"单工作站跑 753B"这种听起来不切实际的题目,而且严肃地发在 arXiv 系统方向并开源。
"本地推理 = 隐私"这条线越走越实。 编码 Agent 需要把整个代码库喂给模型,云端方案意味着代码出境。FreeToken 提供的 OpenAI/Anthropic 双兼容 API,让"本地引擎 + 现成 Agent 生态"这个组合第一次在消费级硬件上成立。
开源推理栈的成熟度分层。 粗看之下 llama.cpp(通用、跨平台、GGUF 生态)、vLLM/SGLang(数据中心、极致吞吐)、FreeToken(边缘 MoE、弹性调度)形成了清晰的三层分工。FreeToken 填补的正是"个人想跑前沿级 MoE,但只有一张消费级显卡"这个此前无人认真做的位置。
论文实验覆盖 8GB 笔记本 GPU 到单张工作站 GPU 的硬件跨度,声称在 35B 模型上达到交互级速度、284B 在游戏主机上、753B GLM-5.2 在单张工作站卡上。这些数字需要在自己的硬件上验证,但把整个问题域重新定义这件事本身,已经足够有价值。
FreeToken 的真正贡献,可能不是"753B 跑在单卡上"这个数字,而是它把"本地大模型推理"从显存容量的硬约束,变成了系统调度问题的软约束。当 GPU、CPU、主机内存和互连带宽被当作一个统一资源池来编排时,硬件的局限就不再是终止符,而只是参数。
代价同样真实:CUDA 13 + Linux + NVIDIA 是不可绕过的入场券,模型权重的下载与存储是实打实的几十到几百 GB,469 个 open issue 提醒着你还处在 Beta 阶段。但对于愿意折腾、又确实需要把前沿模型跑在自己机器上的人——尤其是希望用 Claude Code / Codex 却不想为云端 API 付费的编码者——这个项目值得认真试一试。
uv pip install "freetoken[accel]"
ft serve --model ~/models/Qwen3.6-35B-A3B
然后访问 http://127.0.0.1:1919/v1/models 确认服务已就绪。
项目主页:https://github.com/FlashML-org/FreeToken | 论文:https://arxiv.org/abs/2608.16157 | 官网:https://www.flashml.ai/
