
Douyin_TikTok_Download_API
Evil0ctal/Douyin_TikTok_Download_API加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
设想一个很具体的场景:你要做短视频内容分析,需要每天抓取若干条抖音、TikTok、B 站作品的数据——点赞数、评论、作者信息、话题标签;还要把选中的视频下载下来做无水印存档,供后续转写和内容审核使用。
最省事的做法是去买一个第三方数据 API。但很快你会发现三个麻烦:第一,按量计费的成本随抓取量线性上涨;第二,你的数据要经过别人的服务器;第三,最关键的——当某个平台改了签名算法,第三方接口还能用,而你完全不知道它是怎么修好的。
Douyin_TikTok_Download_API 提供的是另一条路:把整条链路收回自己的机器上。它是作者 Evil0ctal 从 2021 年 11 月就开始维护的项目,到今天已经积累 21159 个 Star、2946 个 Fork,是中文开源社区里自托管短视频数据服务里最成熟的一个。
如果只看仓库,你可能以为这只是把旧代码清理了一遍。实际上 v5 是从空分支起步的重写,与 v4 没有一行共同的代码。v4 的做法很直接:把 cookie 粘进 crawlers/*/config.yaml,同步调用抓取接口,cookie 过期了自己去改。v4 还移植了一份 GPL-3.0 的 A-Bogus 签名代码。
v5 换掉了整套思路。v4 的问题从来不是功能少,而是接口会悄悄死掉而没人知道——cookie 过期了、签名算法变了、端点被限流了,等你发现的时候,通常是用户发来一条 issue。
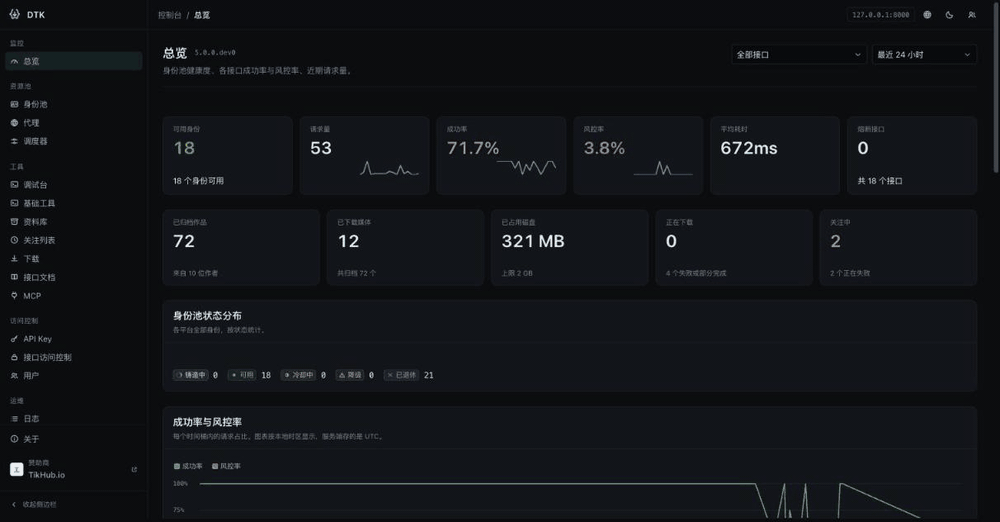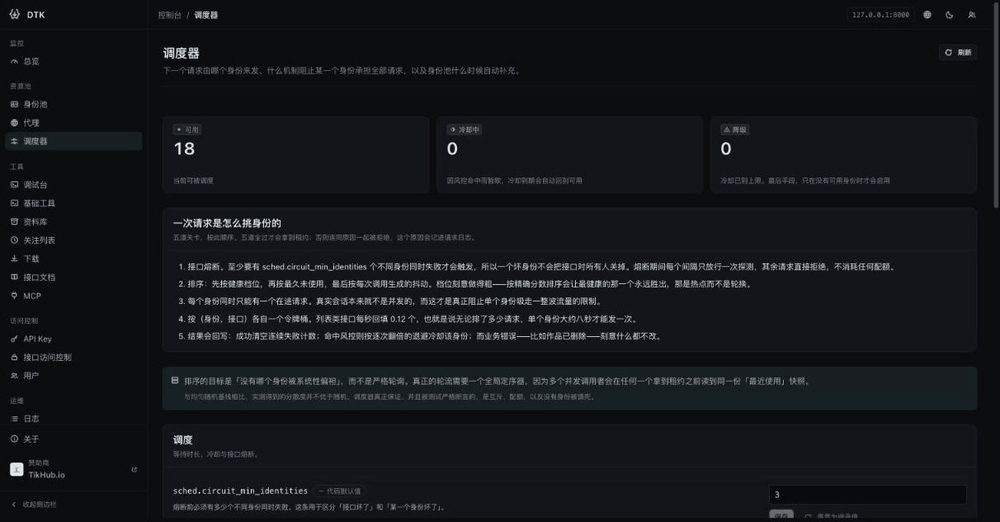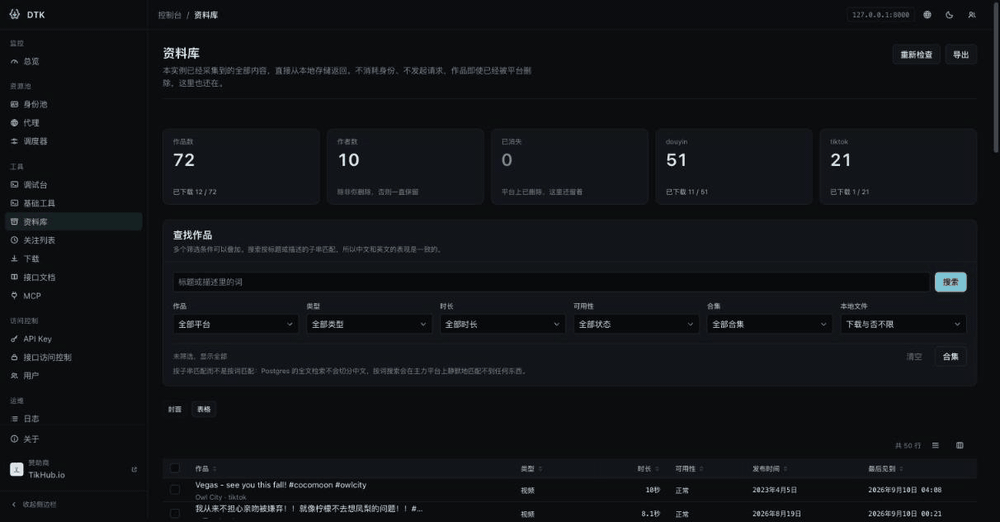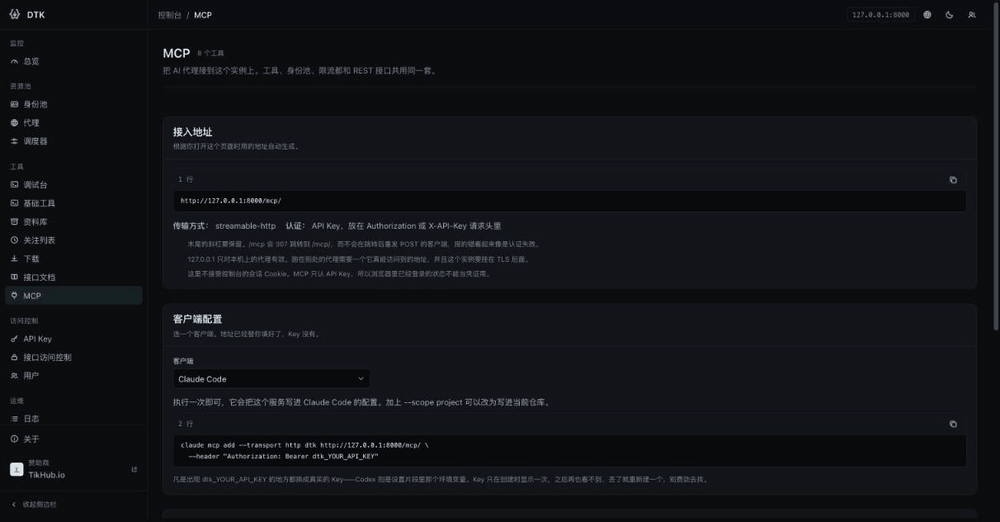
v5 把"可观测"和"自愈"放在了功能前面:
min_size(默认 3)补到 target_size(默认 8),失败指数退避。补池慢是刻意的——一秒内冒出五个"新访客"本身就像异常。作者自己写下了 v5 的"明确不做"清单:不提供 AI 功能、不做计费与多租户、不引入 Kafka / Elasticsearch / MinIO / k8s、不做视频字节中转。这些不做,和做的一样,是设计的一部分。
项目对外暴露三种调用方式,它们共用同一个 service 层,而不是互相转发:
| 入口 | 位置 | 适合谁 |
|---|---|---|
| REST API | /api/v1/... | 脚本、后台任务、自动化服务 |
| MCP Server | /mcp | Claude Code、Claude Desktop、Codex CLI、Cherry Studio 等 AI 客户端 |
| CLI | dtk --help | 终端运维与排障 |
Web Console 则是 React 写的管理后台(v4 用的是 PyWebIO),负责身份池、调度器、资料库、下载、日志、API Key 和诊断。
MCP 那一层设计得相当克制:只暴露 10 个工具,作者的理由是"每多一个工具,智能体选对工具的概率就实测下降一分"。其中 download_media 和 transcribe_video 会写本实例磁盘,因此各自拥有独立的写权限。更关键的一条是——没有任何工具会碰到凭据:没有身份工具、没有 cookie 工具、没有代理工具,pool_status 只报数量和熔断状态。这不是靠权限检查实现的,而是这些工具根本不存在。
git clone https://github.com/Evil0ctal/Douyin_TikTok_Download_API.git
cd Douyin_TikTok_Download_API
bash install/install.zh.sh          # 引导式脚本,只写你指定的目录
docker compose -p dtk -f docker/compose.yml up -d
需求看起来简单:Docker Engine + Compose v2.24 以上(compose 文件用了 env_file 的长语法)、git、openssl 生成 DTK_SECRET_KEY。第一次 up 会在本地构建镜像(项目没有发布镜像仓库)。
但真实成本在内存。官方文档给的数据很具体:
browser-rpc 浏览器容器(无头 Chromium 自动铸造抖音/TikTok 游客身份),该容器预热后吃 2.57 GiB 内存、629% CPU,此时建议 8 GB;有一个容易被忽略的岔路口:不跑 browser-rpc 容器时,抖音和 TikTok 的身份池一直是空的,所有内容请求返回 503 IDENTITY_POOL_EXHAUSTED——因为这两个平台的游客身份必须靠真实无头浏览器铸出来。B 站是例外,普通 HTTP 请求即可。两条路线二选一:自动铸造(约 1.7 GB 镜像、2.57 GiB 内存),或手动导入 cookie(cookie 等同于账号密码,续期责任在你)。
必须挑明的是几件事:
DTK_SECRET_KEY 做 AES-256-GCM 静态加密,退役时立即擦除;控制台密码用 argon2id,服务端会话放 Redis。但文档自己写清了防不住什么:拿到宿主机 shell 的人(DTK_SECRET_KEY 就在进程环境里,CLI 直连数据库且不做角色检查)能拿到一切;同时拿到数据库和主密钥的人也能;心怀恶意的管理员同样能——审计日志会记录,但不会阻止。src/dtk/platforms/bilibili/ 适配层与 16 个 Alembic 迁移中的 0013_bilibili_platform,但英文 FAQ 仍称 v5 只支持两个平台。版本差异需要在实际部署前自行核对。这个项目的 21k Star 说明了一件事:AI 智能体正在把"数据获取"变成基础设施需求。当 Claude Code 之类的客户端需要"解析一条抖音链接并把视频转成文字"时,它需要的是一个能被 MCP 调用的稳定接口,而不是一个需要人肉点开的网页。MCP 恰好成了这类工具的通用插座。
作者把逆向工程的过程本身也开放出来——reer.dev 是一个专门放签名、协议、加壳拆解的论坛。
有意思的是赞助结构:README 顶部是 TikHub.io(一个商业社交数据 API 市场)的赞助位。作者的立场写得很直白——本项目没有托管版、没有免费额度、也没有可以在这里购买的 API key;如果你宁愿买数据不想自己跑爬虫,那是你和赞助商之间的事。由此也提醒:自托管开源项目与商业数据服务往往是互补而非替代关系,项目的可持续性正建立在这个张力之上。
Douyin_TikTok_Download_API 已经不只是一个"下载器"了。它把短视频数据采集做成了一套有身份管理、有熔断、有审计、有归档、有权限边界的完整服务,并选择用 MCP 和 REST 两套接口把它交给 AI 客户端。
如果你需要的是"偶尔下载一条视频",它显然太重了;但如果你需要的是"持续、稳定、可观测地获取短视频数据,并让智能体直接调用",那 21159 个 Star 和 430 次提交背后,是目前中文开源社区里最完整的一份答案。
部署建议:4 GB 内存起步 + 15 GB 磁盘;先跑核心服务验证 REST,确需自动铸造身份时再开 browser-rpc;凭据加密依赖 DTK_SECRET_KEY,务必用 openssl rand -base64 48 独立生成并妥善保管;对外暴露端口前先读 documents/zh/15-security.md。
