aivectormemory
Edlineas/aivectormemory加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你正在开发一个电商后端系统。上午和 AI 确认了数据库连接池配置、API 鉴权方案,下午换了个会话继续开发——AI 完全不记得上午讨论过什么,又把同样的问题问了一遍。你不得不翻聊天记录、把配置代码复制粘贴给 AI,重新解释项目背景。
这就是所有 AI 编程助手的根本痛点:上下文窗口是有限的,记忆是会话级的。Claude Code、Cursor、Windsurf……无论哪款工具,换一个会话就等于重新开始。开发者们为了解决这个问题,发明了各种"土办法":维护一个 CLAUDE.md、在项目根目录放 MEMORY.md、甚至用 Notion 手动记录项目上下文。但这些方案都有明显的瓶颈——文件越来越长、关键词匹配不够智能、多项目之间互相污染。
AIVectorMemory 正是为了解决这个"AI 健忘症"而生的。
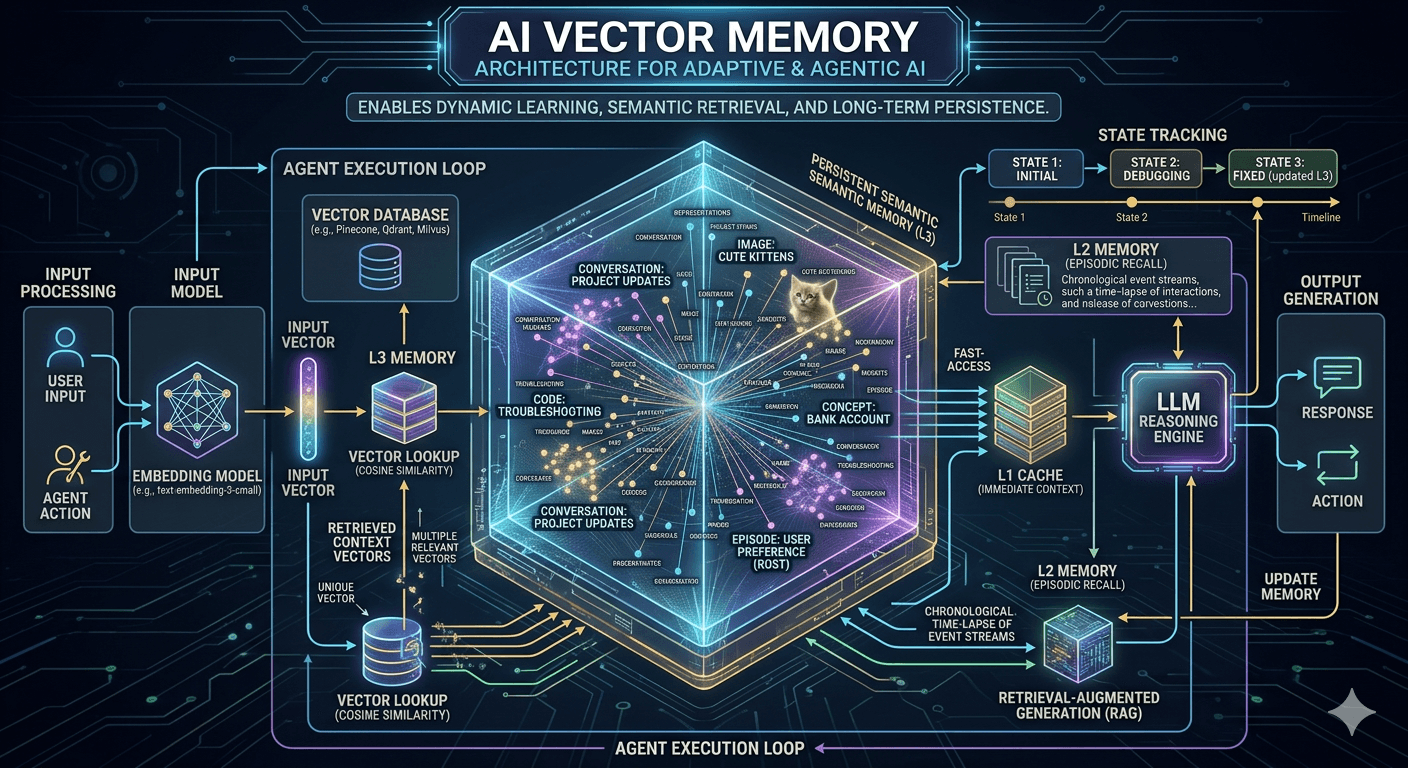
AIVectorMemory 由独立开发者 Edlineas 创建,于 2026 年 2 月正式开源。项目基于 Model Context Protocol(MCP) 协议开发,本质是一个轻量级的本地 MCP Server。它的工作方式很清晰:作为 AI IDE 和本地向量数据库之间的桥梁,将每次对话中的关键信息(决策、配置、bug 修复、任务进度)自动存入 SQLite 向量库,下一次对话时通过语义搜索精准召回。
作者在项目 README 中直言不讳地指出了传统 MEMORY.md 方案的七宗罪:文件越写越大、全量注入 Token 消耗爆炸、关键词匹配不够智能、多项目互相污染、没有任务追踪、无法自动去重合并、越用越乱。这些问题每一个都是真实开发中的高频痛点。
从架构上看,AIVectorMemory 的技术选型非常务实。Embedding 引擎使用 intfloat/multilingual-e5-small 模型(来自 Hugging Face),通过 ONNX Runtime 做 CPU 推理,完全不依赖 GPU 和云端 API。所有数据存储在 ~/.aivectormemory/memory.db,一个 SQLite 数据库,借助 sqlite-vec 插件实现向量索引。
检索策略采用混合搜索:FTS5 全文检索 + 向量语义搜索并行运行,再用 RRF(Reciprocal Rank Fusion) 算法融合排序,综合考虑时效性、调用频率和重要度。这比纯向量搜索更精准——搜"数据库超时"能找到"SQL 连接池配置问题",用词不同也能命中。
记忆管理是基础功能。remember 工具自动保存对话中的关键信息,recall 工具按需召回相关记忆,forget 工具删除过时记忆。值得注意的是,系统内置矛盾检测——当新记忆与旧知识冲突时,自动用新知识替代旧知识,而不是简单堆积。
问题追踪(Issue Tracker) 是 AIVectorMemory 的亮点。它不是简单记录 bug,而是建立了完整的生命周期:发现 → 排查 → 修复 → 归档。AI 在开发过程中遇到问题时,可以自动创建 issue,记录排查步骤和最终解决方案,整个过程不需要人工介入。
任务管理则将任务拆分为多级嵌套结构:Spec → 主任务 → 子任务,支持状态同步和联动归档。这意味着 AI 不只帮你写代码,还能帮你跟踪"这个功能做到了哪一步"。
除了记忆本身,AIVectorMemory 还提供了行为约束机制。bash_guard 和 stop_guard 等 Hook 可以在危险操作前触发确认,防止 AI 执行破坏性命令。Steering 规则文件则定义了 AI 的行为边界——比如"所有数据库操作必须先备份"、"API 变更必须记录在 issue 中"。这套机制让 AI 在不同会话中的行为保持一致,不必每次都重新交代项目规范。
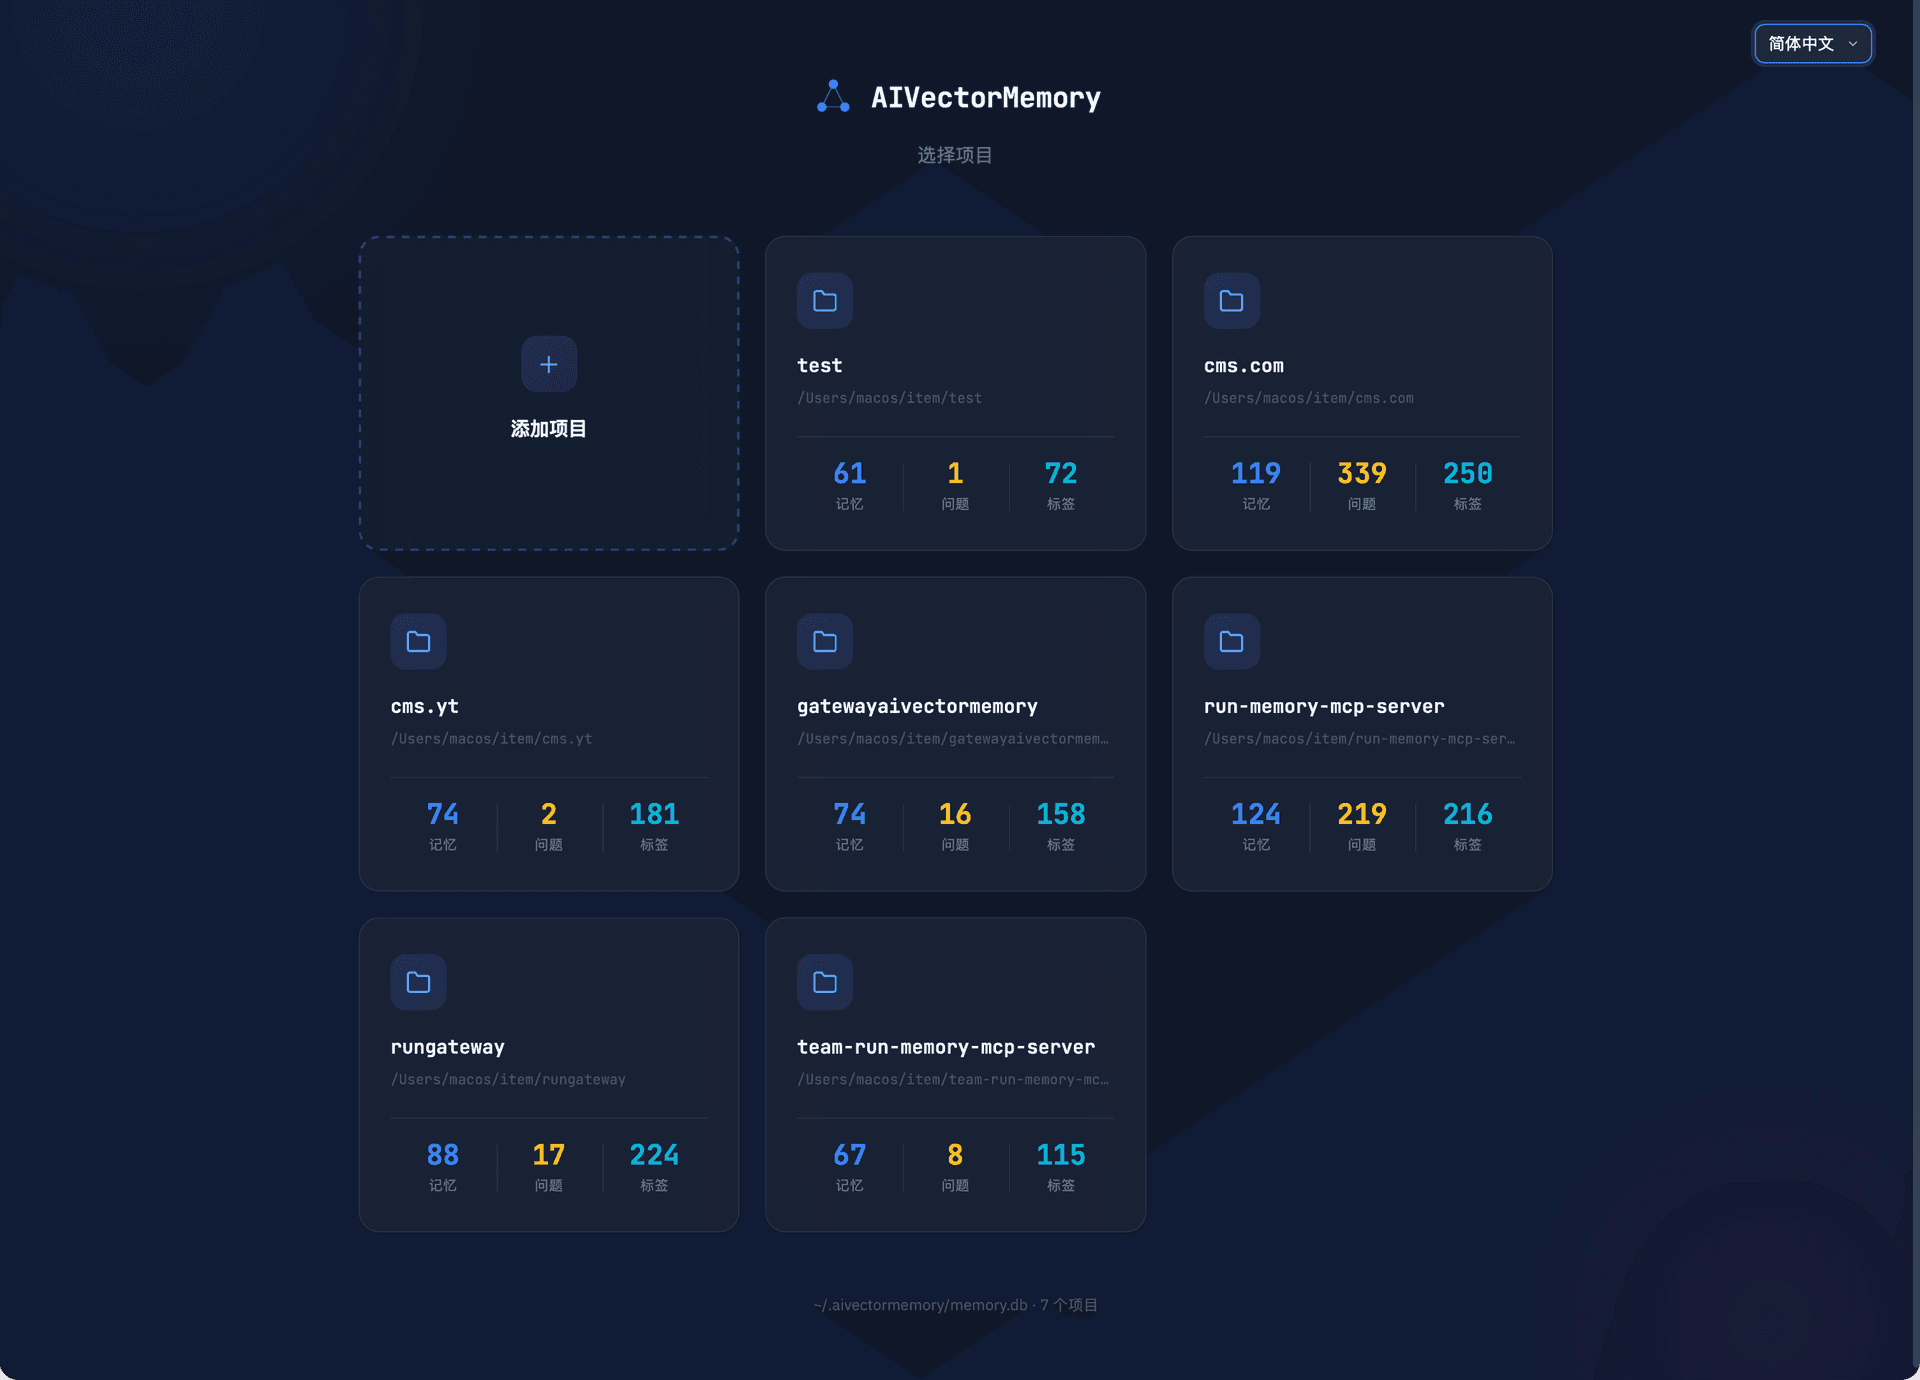
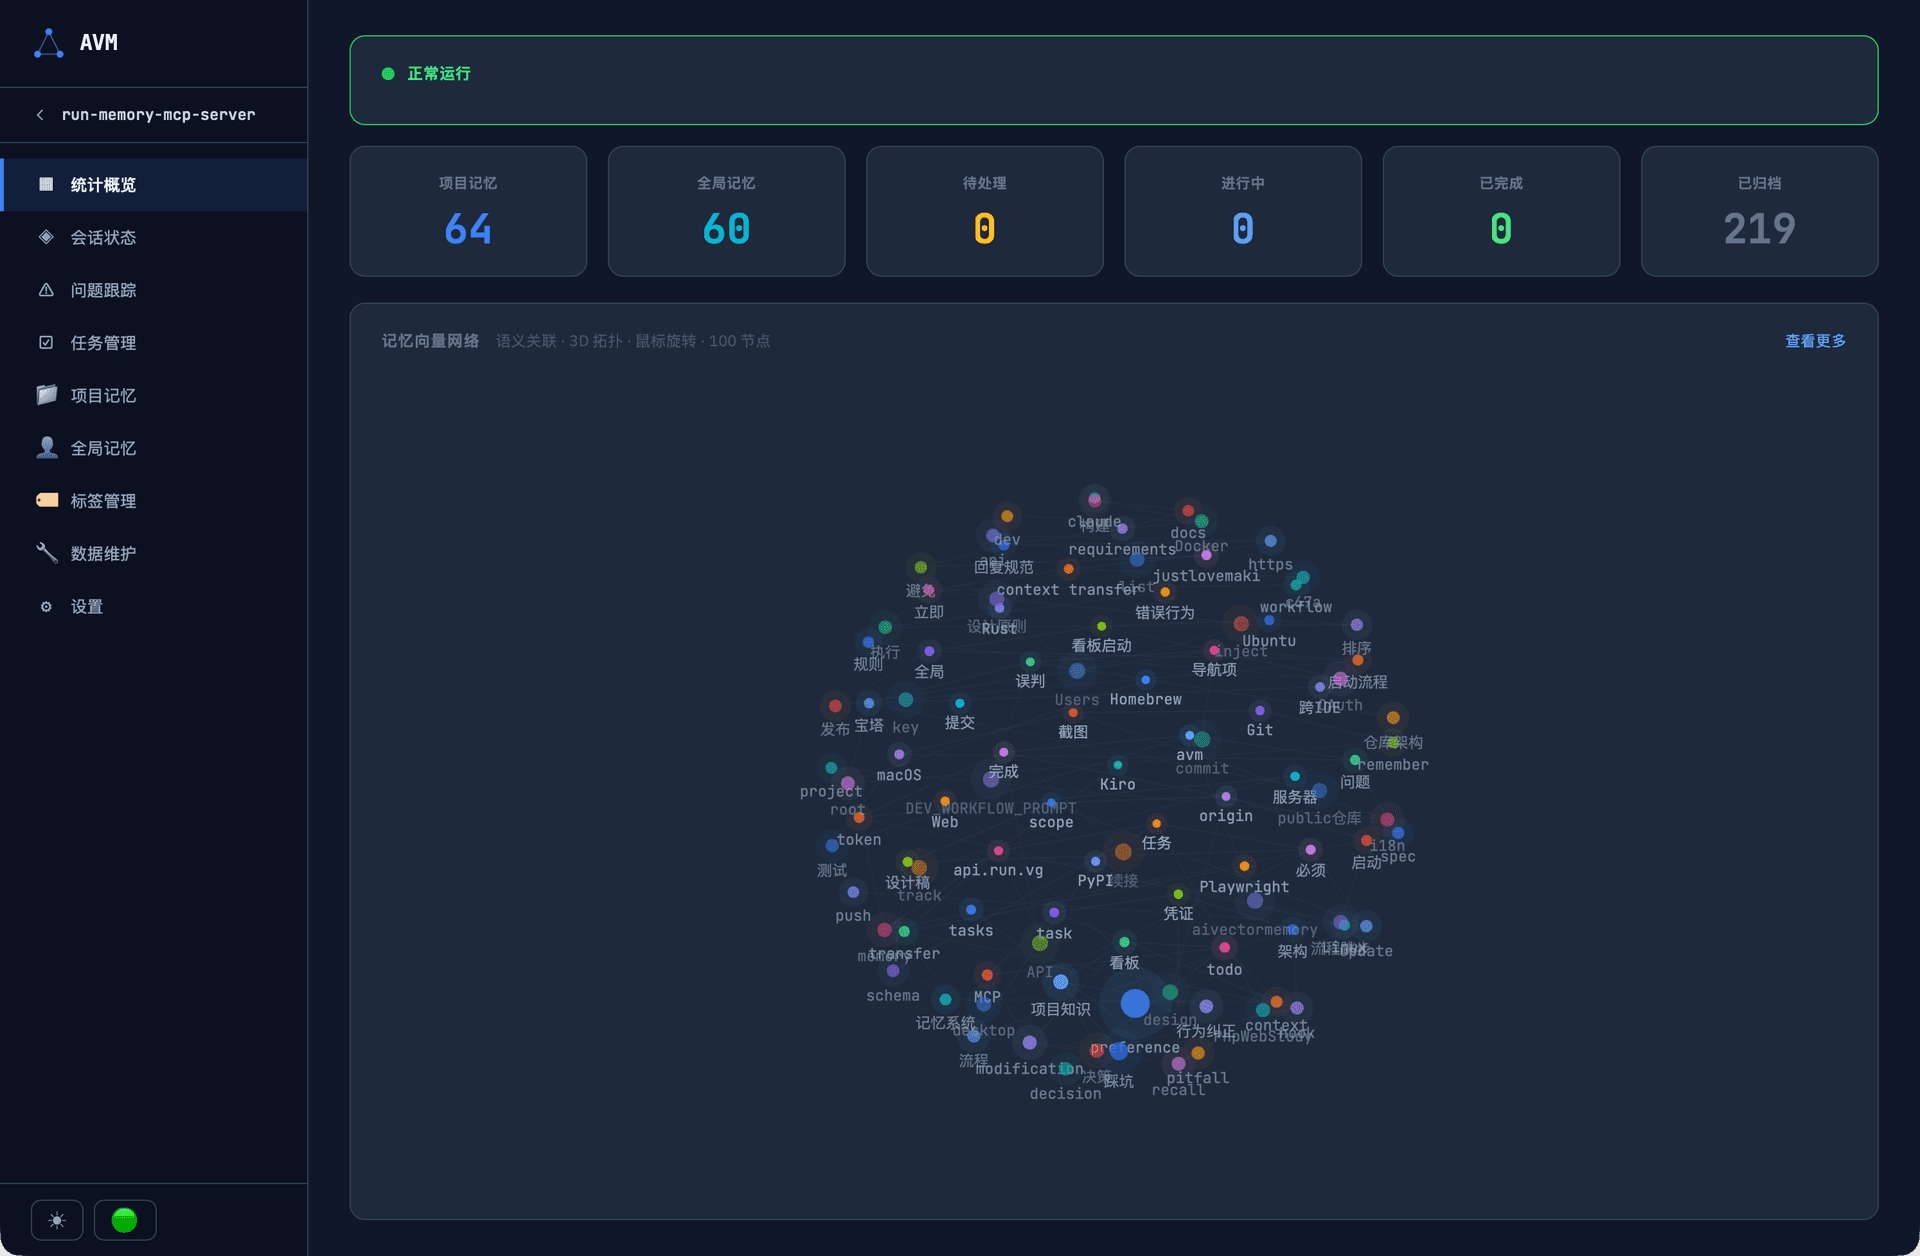
AIVectorMemory 提供了原生桌面应用(支持 macOS / Windows / Linux)和 Web 看板。Web 看板中最有意思的功能是3D 向量网络可视化——将记忆以节点-边图的形式展示,节点大小反映重要度,边的粗细反映关联强度,让你一眼看清知识之间的关联网络。
安装非常简单:
# 方式一:pip 安装
pip install aivectormemory
cd /path/to/your/project
run install

# 方式二:零安装 uvx
uvx aivectormemory install
run install 会交互式引导你选择 IDE(支持 Cursor、Claude Code、Windsurf 等 11 款工具),自动生成 MCP 配置、Steering 规则和 Hooks,无需手动编写 JSON。
有一点需要注意:macOS 自带 Python 和 python.org 官方安装包不支持 SQLite 扩展加载(enable_load_extension 错误),作者建议使用 Homebrew Python 来解决。这是目前唯一需要额外配置的地方。
必须承认 AIVectorMemory 不是银弹。首先,依赖本地 Python 环境,在没有配置好开发环境的场景下(比如临时使用别人的机器),无法即开即用。其次,语义搜索质量高度依赖 Embedding 模型,multilingual-e5-small 在某些垂直领域的表现可能不如专门微调的模型。第三,当前版本(v2.4.5)仍处于 Alpha 阶段,API 尚未完全稳定,大规模团队协作场景下的效果还有待验证。
此外,项目目前没有 Docker 支持,对于习惯容器化部署的团队来说,需要额外的适配工作。
AIVectorMemory 代表了一个重要的技术方向:为 AI 编程工具添加持久化记忆层。当前主流 AI IDE(Cursor、Claude Code、Windsurf)的记忆机制都是基于会话的,无法跨会话保持状态。AIVectorMemory 通过 MCP 协议与这些工具解耦,理论上可以支持任何实现了 MCP 的 AI 助手——这是一种聪明的架构选择,不绑定特定 IDE,而是做底层服务。
项目在 GitHub 上获得了 91 Stars,虽然规模不大,但覆盖了 11 款主流 AI IDE、支持 7 种语言(中日英德法西日),国际化做得相当完善。项目更新活跃(最后提交 2026-04-19),且维护了详细的 CHANGELOG 和多语言文档。
从长期趋势看,随着 AI 编程助手在开发者中的渗透率不断提升,"AI 记忆管理"这个细分领域的价值会愈发凸显。AIVectorMemory 作为这个方向的早期探索者,值得持续关注。