
evox
EMI-Group/evox加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下,你要为一个推荐系统调参——有上百个超参数彼此耦合,没有梯度信息,暴力网格搜索需要跑几百年。这个时候,你会希望有一种"智能试错"机制:模拟生物进化,让候选解不断变异、交叉、淘汰,逐步收敛到最优解。这就是**进化计算(Evolutionary Computation, EC)**的核心思想,而 EvoX 就是这个领域里一颗正在冉冉升起的新星。
2023年,来自上海交大 EMI-Group 的团队在 arXiv 上发表了一篇论文,正式推出 EvoX——一个基于 PyTorch 的分布式 GPU 加速进化计算框架。与传统的纯 CPU 实现相比,EvoX 在 GPU 上实现了 100 倍以上的性能提升,让原本需要数日才能完成的算法搜索任务,在几小时内搞定。
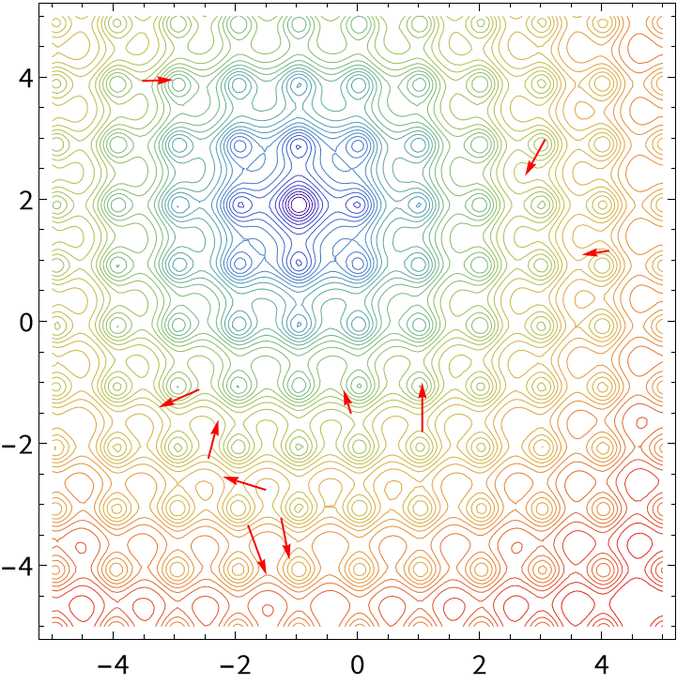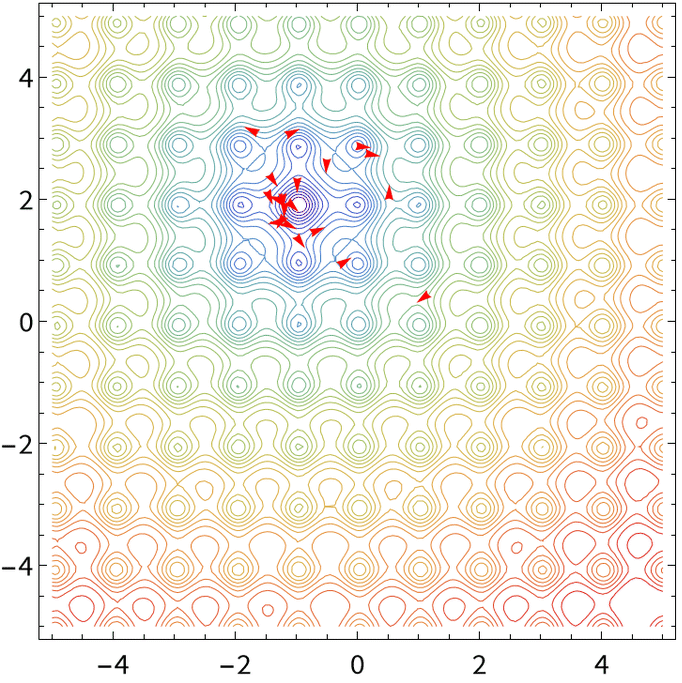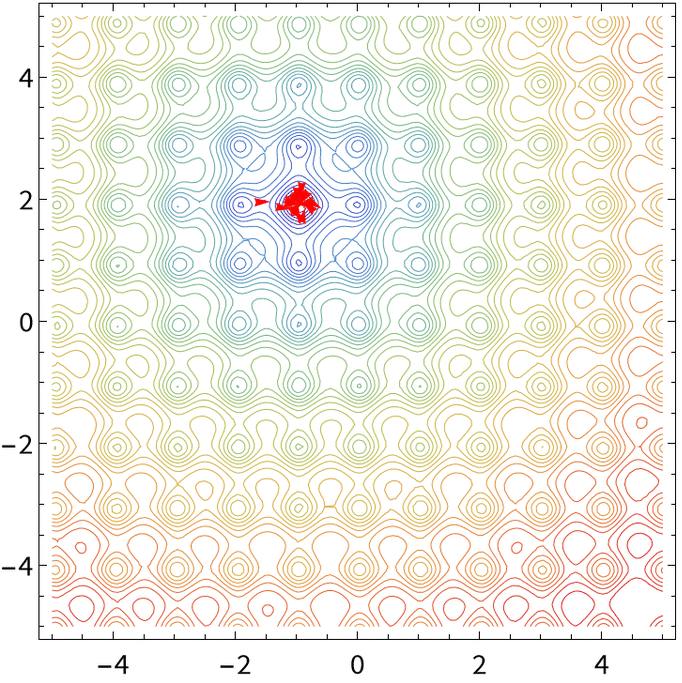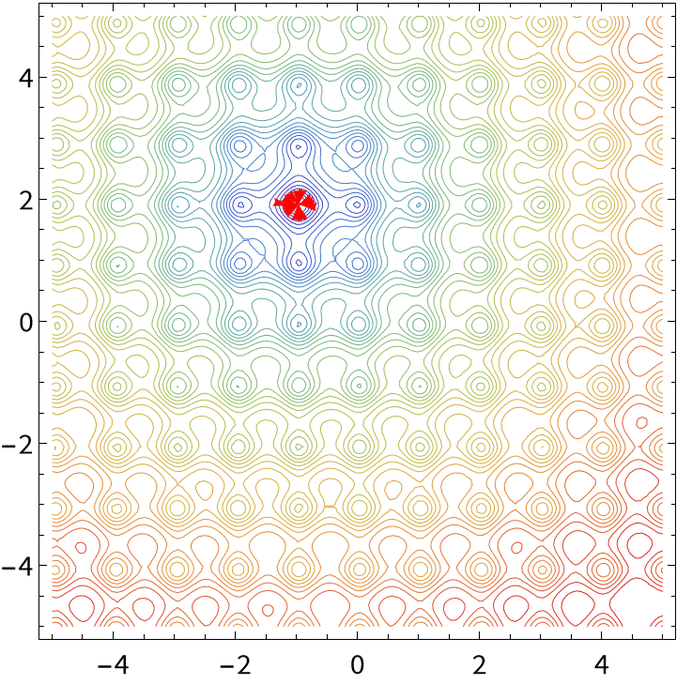
PSO 粒子群优化算法在 Ackley 函数上的收敛轨迹,粒子群从随机分布逐步聚集到全局最优解附近。
传统的进化算法实现(如 DEAP、Inspyred)有几个致命问题:
第一,速度慢。 单线程 Python 实现无法利用 GPU 的并行计算能力。当种群规模达到数千、问题维度超过几十维时,评估一个迭代就要消耗大量时间。
第二,碎片化严重。 进化算法领域积累了数百种变体——差分进化(DE)有 CoDE/JaDE/SHADE 等十几种,粒子群优化(PSO)有 CLPSO/SL-PSO 等七八种,但在不同框架里切换这些算法需要重写大量代码。
第三,与深度学习割裂。 进化算法在 AutoML、神经架构搜索(NAS)、强化学习策略优化等领域有巨大潜力,但主流 ML 框架(PyTorch/TensorFlow)与进化优化工具之间缺乏桥梁。
EvoX 的诞生,就是为了同时解决这三个问题。
EvoX 的设计哲学非常清晰:用 PyTorch 的方式做进化计算。整个框架围绕三个核心抽象构建:
Algorithm(算法) → Problem(问题) → Workflow(工作流)
Algorithm 层封装了进化算法的核心逻辑——变异、交叉、选择。EvoX 内置了 30+ 种单目标优化算法和 20+ 种多目标优化算法,涵盖:
| 类型 | 代表算法 |
|---|---|
| 差分进化 | CoDE、JaDE、SaDE、SHADE、IMODE |
| 进化策略 | CMA-ES、PGPE、OpenES、xNES、CR-FM-NES |
| 粒子群优化 | FIPS、CSO、CPSO、CLPSO、SL-PSO |
| 多目标 | NSGA-II、NSGA-III、MOEA/D、RVEA、SPEA2 |
Problem 层定义了待优化的目标函数和环境。EvoX 内置了 30+ 基准测试问题,包括经典的单目标函数(Rastrigin、Ackley、Rosenbrock)和多目标基准套件(DTLZ、ZDT、CEC'22)。更亮眼的是,EvoX 还支持将 Brax 物理引擎、Mujoco 环境和自定义 RL 任务作为问题定义,直接用于神经进化(Neuroevolution)——也就是说,你可以在 GPU 上同时进化数千个神经网络策略,大规模搜索最优神经网络结构和超参数。
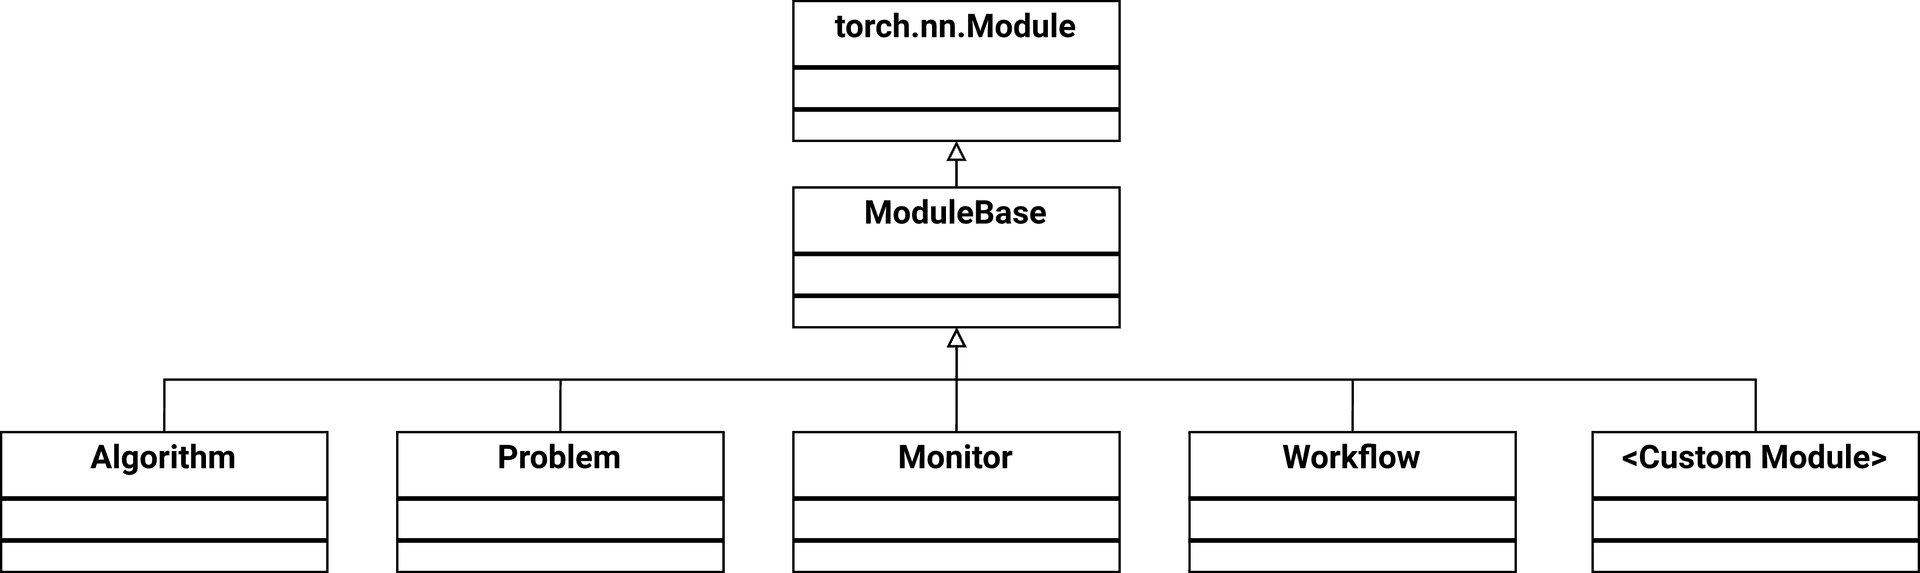
EvoX 的模块化架构,Algorithm 与 Problem 通过 Workflow 解耦,支持任意组合。
Workflow 层负责将算法和问题串联起来执行。最常用的 StdWorkflow 提供了初始化、迭代执行、监控三步走的编程模型。配合 EvalMonitor,可以实时记录每代的最优解变化,并通过 Plotly 可视化收敛曲线。
EvoX 的 100 倍加速不是凭空而来的,核心是三项 PyTorch 原语:
torch.compile (JIT 编译): 将整个进化循环编译为优化的 CUDA 内核,消除 Python 开销。
torch.vmap(向量化): 对种群中的每个个体并行执行前向传播。vmap 将"for 循环遍历种群"转换为一次张量运算,在 GPU 上利用数千个并行核心同时评估整个种群。
torch.set_default_device: 一行代码切换 CPU/GPU 执行上下文,无需修改任何算法代码。
import torch
from evox.algorithms import PSO
from evox.problems.numerical import Ackley
from evox.workflows import StdWorkflow, EvalMonitor

torch.set_default_device("cuda")  # 一键切换到 GPU

algorithm = PSO(pop_size=100, lb=-32*torch.ones(10), ub=32*torch.ones(10))
problem = Ackley()
monitor = EvalMonitor()
workflow = StdWorkflow(algorithm, problem, monitor)

workflow.init_step()
for i in range(100):
    workflow.step()

monitor.plot()  # 查看收敛曲线
这套编程模型最优雅的地方在于:用户无需关心 GPU 并行化的细节,只需要设置 torch.set_default_device("cuda"),剩下的由 PyTorch 自动完成。对于有分布式训练经验的工程师来说,学习曲线几乎为零。
EvoX 最令人兴奋的能力之一是神经进化(Neuroevolution)——用进化算法来优化神经网络的权重、架构甚至超参数。这在强化学习场景中尤为强大:传统的 Policy Gradient 方法需要梯度信号,而很多真实环境(如机器人控制)梯度不可得或不稳定,进化算法完全不依赖梯度。
import torch
import torch.nn as nn
from evox.algorithms import PSO
from evox.problems.neuroevolution.brax import BraxProblem
from evox.utils import ParamsAndVector
from evox.workflows import StdWorkflow, EvalMonitor

class SimpleMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(nn.Linear(17, 8), nn.Tanh(), nn.Linear(8, 6))
    def forward(self, x):
        return torch.tanh(self.features(x))

model = SimpleMLP()
adapter = ParamsAndVector(dummy_model=model)
POP_SIZE = 1024
model_params = dict(model.named_parameters())
pop_center = adapter.to_vector(model_params)
lb = torch.full_like(pop_center, -5)
ub = torch.full_like(pop_center, 5)

algorithm = PSO(pop_size=POP_SIZE, lb=lb, ub=ub)
problem = BraxProblem(policy=model, env_name="halfcheetah", max_episode_length=1000, num_episodes=3, pop_size=POP_SIZE)
monitor = EvalMonitor(topk=3)
workflow = StdWorkflow(algorithm, problem, monitor, opt_direction="max", solution_transform=adapter)

workflow.init_step()
for i in range(50):
    workflow.step()
这段代码用 PSO 算法同时进化 1024 个 MLP 策略,控制 HalfCheetah 双足机器人。ParamsAndVector 适配器负责将 PyTorch 模型参数与进化算法中的向量表示互相转换,实现了进化优化与神经网络的无缝对接。
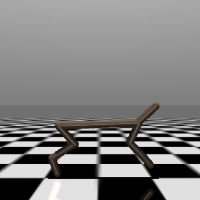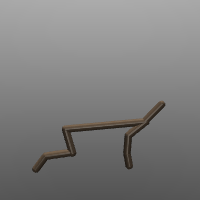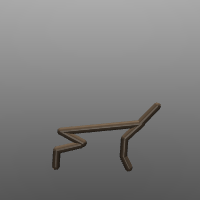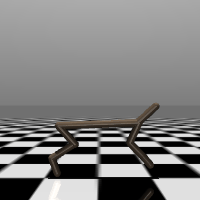
在 GPU 上进化 200 代后获得的 HalfCheetah 奔跑策略,PSO 算法从随机策略逐步优化出稳定奔跑步态。
EMI-Group 的野心不止于此。他们围绕 EvoX 构建了一个完整的进化计算生态系统:
这套组合拳覆盖了从单目标优化、多目标优化、到与深度学习/强化学习结合的完整进化算法应用场景。
安装只需一行:
pip install "evox[default]"
文档有完整的中英文双语支持(ReadTheDocs),QQ 群(297969717)和 Discord 社区活跃。v1.4.0 于 2026 年 9 月刚刚发布,是一个以修复和改进为主的维护版本。
需要注意的是,EvoX 没有提供 Docker 部署方案,也没有 docker-compose 文件**。生产环境部署需要手动安装 PyTorch + CUDA 环境,这对没有 Linux 运维经验的团队有一定门槛。好在 ReadTheDocs 上的安装文档非常详尽,Windows 用户还有一键安装脚本。
GPU 依赖是双刃剑。 EvoX 的极致性能建立在 NVIDIA GPU 之上。AMD ROCm 和苹果 Metal 加速尚未官方支持,在没有 GPU 的机器上运行性能与普通 Python 实现无异。
超大规模问题存在瓶颈。 当单个个体维度达到百万级(如大规模神经网络的完整权重向量)时,内存和通信开销急剧上升。EvoX 目前更多面向中小规模(参数维度 < 10万)的优化场景。
文档深度参差不齐。 基础功能的文档非常完善,但高级特性(如自定义算子、分布式工作流)的说明相对匮乏,需要阅读源码才能完全理解。
进化算法在 AutoML、机器人控制、药物分子设计、卫星轨道规划等无梯度优化场景中有不可替代的价值。EvoX 的出现,首次让这些场景在大规模问题上具备了工业级可用性——100 倍的加速意味着原本不可能的实验变得可行,原本需要数天的超参搜索可以在数小时内完成。
截至 2026 年 9 月,EvoX 在 GitHub 上获得了 2600+ stars、348 forks、持续活跃的社区更新。它代表了一个明确的趋势:在深度学习主导的 AI 生态中,进化计算正在以 GPU 加速为支点,撬动更多工业应用场景。
