LLM-quickstart
DjangoPeng/LLM-quickstart加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
第一次尝试微调大模型的人,几乎都会在同一个地方停下来:环境。
CUDA 版本和驱动对不上、PyTorch 装成了 CPU 版、显存不够直接 OOM、量化工具和分布式参数配置冲突……这些问题的技术含量并不高,但每一个都足以消耗掉一整个周末,而你对模型本身的理解还停留在 README 层面。
LLM-quickstart 是一份中文教程,专门把这些前置工作先趟平。
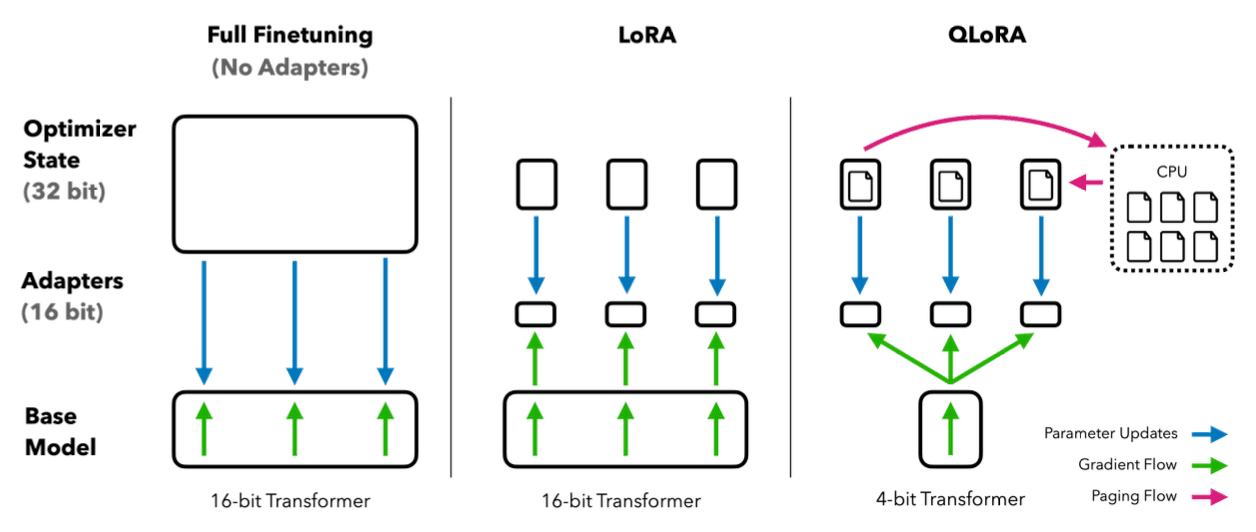
ChatGLM QLoRA 微调流程图
项目由 DjangoPeng 维护,2023 年 12 月建仓,目前约 1070 star、590 fork——fork 数接近 star 数,这个比例在教程类仓库里是典型信号:大量学习者 fork 下来做自己的实验。
它不是框架,而是大模型微调实战的分主题教材,每个目录是一个独立的实验环境:
chatglm/ — ChatGLM 推理、带记忆的对话、QLoRA 微调(配套周易问答数据集)deepspeed/ — ZeRO-2 / ZeRO-3 配置、单机多卡与多机训练脚本langchain/ — 链式编排、路由链、顺序链、记忆模块peft/ — LoRA / QLoRA 实操quantization/ — AWQ、GPTQ 等量化方案transformers/ — 模型结构解析与数据处理细节主体形式是 Jupyter Notebook,辅以脚本与配置文件;数据集以 CSV/JSON 随仓库附带(如 chatglm/data/zhouyi_dataset_handmade.csv)。
README 里的安装流程写得非常具体,是这个项目最有价值的部分。
硬件底线写得很明确:显存不小于 16GB,最低显卡型号是 NVIDIA Tesla T4,建议用 GPU 云服务器。
CUDA 安装特别强调用 runfile 方式:
wget https://developer.download.nvidia.com/cuda/12.4.0/local_installup/cuda_12.4.0_550.54.14_linux.run
sudo sh cuda_12.4.0_550.54.14_linux.run
因为这样能把版本匹配的 GPU 驱动一并装好——这正是新手最容易踩空的一环。
验证环节给出真实输出:nvidia-smi 的完整输出被贴进 README,包含驱动版本 535.129.03、CUDA 12.4、显存 15360MiB。你可以直接对照自己的环境判断装对了没有。
环境依赖明确:Python 3.10、Miniconda、JupyterLab、Ubuntu 22.04 为参考环境。
requirements.txt 固定了一整套版本:torch==2.3.1、transformers==4.37.2、peft==0.7.1、accelerate==0.26.1、autoawq==0.2.2、auto-gptq==0.6.0、bitsandbytes==0.41.3.post2、deepspeed 相关脚本、gradio==4.13.0、trl==0.8.1、langchain==0.2.0、以及 librosa / jiwer 等语音相关包。
版本固定对教程是好事——照着抄能跑通。但这些版本停留在 2023 年末到 2024 年初,今天直接 pip install 装上之后大概率会遇到与新版 Transformers 的兼容问题。
门槛中等偏上。有 Web 界面(chatglm/chatbot_webui.py 等 Gradio 脚本),但没有 Dockerfile,需要按目录逐个安装依赖、准备数据与权重。仓库对不同子项目的依赖要求不同——deepspeed/ 目录配自己的 requirements.txt,quantization/ 配 AWQ 的环境。
对有 16GB 显存的 T4 用户来说,这套内容基本覆盖了能做的全部微调实验。
它是一份会过时的教材。 这是最需要认清的一点。所有依赖固定在 2023—2024 年的版本,Transformers 从 4.37 到今天的 5.x 期间 API 变动多次,其中部分 Notebook 代码大概率已经跑不通。作为学习材料仍有价值,作为可直接使用的代码库需要逐个验证。
没有测试与 CI。 目录里出现的 tests/ 目录多数是框架自带的示例文件(LangChain 的文本样本、PEFT 的音频样本),不是本仓库的单元测试。质量保证完全依赖人工逐个执行 Notebook。
权限建议偏宽松。 README 指引用 sudo 安装 CUDA 驱动,这是常见做法但权限过大,生产环境应改成官方包管理器方式。
Notebook 里常见明文写 API Key 的写法,使用者需要自行注意不要把密钥提交进版本库。
中文优先的双语结构(README + README-en.md)对国内学习者友好,但技术内容基于英文社区生态,模型与数据集以国际主流为主。
LLM-quickstart 代表了 2023 年末至 2024 年初中国大模型学习生态的一个切面:中文系统性教程 + 开源基座模型 + 消费级到入门级服务器硬件的组合,让大量第一次接触大模型微调的开发者有了一条可走通的路径。
它的 590 个 fork 说明这套材料被真实地用作个人实验起点。
今天同类资源已经相当丰富——但有一条经验仍然有效:学微调的第一步不是读 LoRA 论文,而是把 nvidia-smi 的输出和你的期望对一遍。这个仓库在这一点上做得比大多数项目都好。
