
RagVL
DataArcTech/RagVL加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:用户上传一张美食照片,问"这道菜的卡路里是多少"。传统多模态检索系统可能先通过图片找到一批相关文本段落,再通过文字匹配找到答案——但问题来了:图片检索的结果和文字检索的结果往往是割裂的,模型分不清到底该信谁的。
这就是 RagVL(Reranker-enhanced Multimodal VL)要解决的核心问题。它来自 IDEA-FinAI 团队(IDEA研究院),被收录于 arXiv:2407.21439,核心洞察是:多模态大语言模型(MLLM)本身就是强大的重排器(reranker),配合知识增强和噪声注入训练,可以让检索-生成(RAG)系统对图文混合查询的理解精度大幅提升。
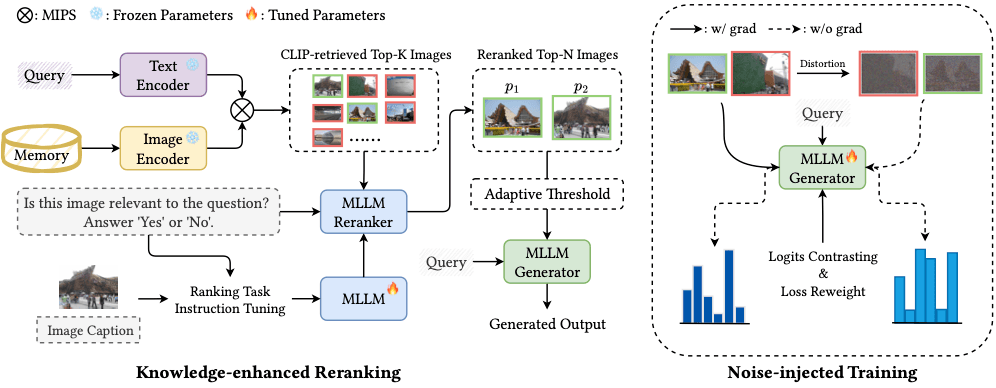
RagVL 的整体架构分为三个阶段:
先用 CLIP 或 BGE 等多模态向量模型从大规模图文数据库中召回 Top-20 相关候选项。这一步追求广度,不要求精准,只要把可能相关的候选都拉进来。
这是 RagVL 的灵魂。它没有用传统双塔模型做重排,而是直接用微调后的多模态大语言模型作为重排器。输入是"图片 + 问题 + 候选文本段落",让 MLLM 判断这三者的语义相关性并打分。
论文提出了两个关键技术:
经过重排后,将排序最高的候选文本和原图一起喂入 LLM,生成最终答案。这里 RagVL 同样引入了 噪声注入 LoRA 来优化生成质量。
RagVL 对四种主流多模态大模型做了适配,工程师可以根据硬件条件灵活选择:
| 模型 | 参数量 | 适用场景 |
|---|---|---|
| LLaVA-v1.5-13B | 13B | 精度最高,显存需求大(建议4×24GB) |
| Qwen-VL-Chat | ~9B | 阿里系模型,中文支持好 |
| mPLUG-Owl2 | ~8B | 模块化设计,扩展性强 |
| InternVL2-1B/2B | 1B/2B | 轻量级,适合快速实验 |
克隆仓库后,核心目录结构如下:
RagVL/
├── webqa_pipeline.py      # WebQA 评估入口
├── mmqa_pipeline.py       # MultimodalQA 评估入口
├── llava/                 # LLaVA 后端实现
├── qwenvl/                # Qwen-VL 后端实现
├── mplug_owl2/             # mPLUG-Owl2 后端实现
├── internvl_chat/         # InternVL2 后端实现
└── finetune/              # 重排器和生成器的微调脚本
上手门槛:由于涉及 4×24GB 级别的多卡训练环境,硬件要求不低。但 README 写得很清晰,环境配置(requirements.txt + LLaVA 环境指南)和数据准备步骤都有详细说明。推理评估相对友好,单卡即可运行。
RagVL 证明了一个反直觉但有说服力的观点:通用多模态大模型不需要额外的专用重排模型,它的语言理解和推理能力本身就适合做这件事。这篇工作将 MLLM 的应用从"生成"拓展到了"理解+排序",为 RAG 系统在真实复杂场景下的落地提供了新思路。
| 维度 | 评估 |
|---|---|
| 容器化 | ❌ 无 Dockerfile,需手动配置环境 |
| Web UI | ⚠️ 有 Gradio 和 Flask 依赖,但非开箱即用的服务 |
| 硬件要求 | 🔴 高(训练推荐 4×24GB,推理推荐单卡 16GB+) |
| 快速部署 | ⚠️ 部分支持(需自行配置 Python 环境 + 下载 checkpoint) |
| 适合人群 | AI 研究者、多模态 RAG 方向开发者 |
