
VectorETL
ContextData/VectorETL加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
VectorETL 官方 Logo
想象一下这个场景:你是一家电商公司的数据工程师,刚刚搭建好了 Pinecone 向量数据库,准备上线"以图搜商品"功能。产品经理催得急:"数据要今天上线!"
你打开数据目录一看——好家伙,数据分散在 PostgreSQL 数据库里、图片存储在 AWS S3 里、客户反馈在 Zendesk 里、商品信息在 MySQL 里。你需要把这些五花八门的数据源全部提取出来,做分块(chunking)、向量化(embedding),然后写入 Pinecone。
每个数据源有各自的 SDK,每个向量模型有各自的调用方式,每个向量数据库又有各自的写入 API。你写了一个月代码,终于跑通了——然后产品经理说:"换个向量数据库试试,从 Weaviate 换成 Qdrant。"
你沉默了。
VectorETL 解决的就是这个问题:让你在几分钟内,把任意数据源的数据,转换成向量,送到任意向量数据库里。
VectorETL 由 Context Data 团队开发维护,作者是 Jide Ogunjobi(jide@contextdata.ai)。Context Data 是一家专注于 AI 数据基础设施的公司,VectorETL 是他们开源出来的核心产品,帮助 Data Engineer 和 AI 工程师快速构建向量数据管道。
项目于 2023 年在 GitHub 开源,采用 MIT 许可证,目前稳定版本为 0.1.7.1,支持 Python 3.7 及以上版本。
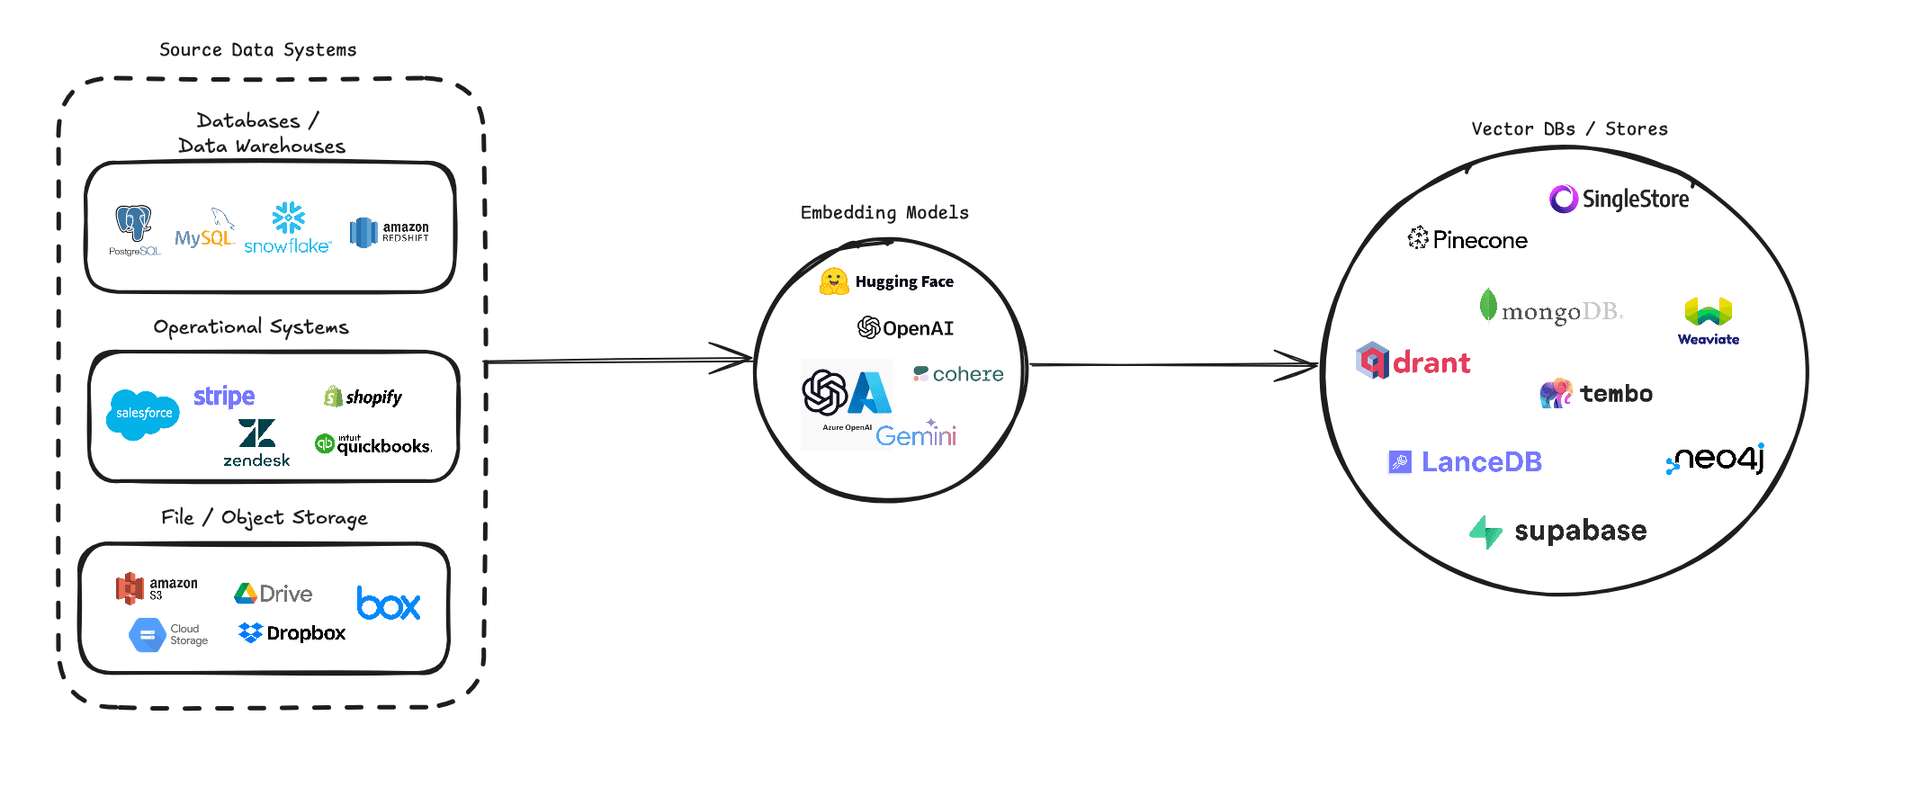
VectorETL 端到端数据流:Source → Embedding → Target
VectorETL 的设计哲学是工厂模式 + 策略模式。整个 ETL 流程被拆成三个完全独立的模块:
支持:PostgreSQL、MySQL、MongoDB、Neo4j、SingleStore 等主流数据库;AWS S3、GCP Storage、Dropbox、Box、Google Drive 等云存储;本地文件、Stripe、Zendesk 等业务系统。
支持 OpenAI text-embedding-3 系列、Cohere Embeddings、Google Gemini Embeddings、Azure OpenAI Embeddings,以及本地 HuggingFace 模型。
支持:Pinecone、Qdrant、Weaviate、LanceDB、Milvus、Neo4j(带向量支持)、MongoDB、SingleStore、Supabase、Tembo 等主流向量和关系型数据库。
VectorETL 支持纯 YAML/JSON 配置文件,完全不需要写代码。以下是一个典型的配置示例:
source:
  source_data_type: "database"
  db_type: "postgres"
  host: "localhost"
  port: 5432
  user: "user"
  password: "password"
  database: "mydb"
  query: "SELECT id, text FROM articles"

embedding:
  provider: "openai"
  model: "text-embedding-3-small"
  api_key: "sk-..."

target:
  target_type: "pinecone"
  api_key: "pc-..."
  index: "my-index"
  environment: "us-east-1"

embed_columns:
  - column: "text"
    metadata_columns: ["id", "created_at"]
写好配置文件,一条命令就跑起来了:
pip install vector-etl
vector-etl -c config.yaml
或者用 Python API 调用:
from vector_etl import Flow, create_flow

flow = create_flow()
flow.load_yaml("config.yaml")
flow.execute()
适合的场景:
不太适合的场景:
orchestrator.py 中的 ETLOrchestrator 类是整个框架的心脏。它在初始化时通过工厂模式加载对应的数据源、向量模型和目标数据库:
class ETLOrchestrator:
    def __init__(self, source_config, embedding_config, target_config, embed_columns):
        self.source = get_source_class(source_config)
        self.embedding = get_embedding_model(embedding_config)
        self.target = get_target_database(target_config)
执行流程:run() → fetch_data() → process_and_embed_data() → write_to_target(),清晰的三段式流水线。
项目依赖超过 40 个 Python 包,涵盖云服务(boto3、azure-storage-blob、Google Cloud Storage、dropbox)、数据库客户端(psycopg2-binary、mysql-connector-python、Pymongo、neo4j、pymilvus)、向量服务(pinecone-client、qdrant-client、weaviate-client、lancedb)、AI 模型(openai、cohere、anthropic、google-generativeai)以及数据处理(pandas、pydantic、unstructured、tiktoken)。
这种"大而全"的依赖策略换来了开箱即用的体验,但也意味着安装体积大(约 500MB+),且部分依赖之间可能存在版本冲突。
unstructured[all-docs] 提供了强大的非结构化文档解析能力(PDF、Word、HTML 等),支持配置 chunk_size 和 overlap,实现语义分块:
source:
  source_data_type: "file"
  file_type: "pdf"
  chunk_size: 512
  overlap: 50
1. 无容器化支持,部署依赖环境
没有 Dockerfile 和 docker-compose,在不同服务器之间迁移需要重新安装所有依赖。对于团队协作来说,"在我机器上能跑"是一个真实的痛点。
2. 稳定性存疑
项目版本号 0.1.7.1(Alpha 阶段),pyproject.toml 和 setup.py 中声明的许可证(BSD-3-Clause vs MIT)存在不一致,生产环境使用需谨慎评估。
3. API Key 安全问题
配置文件中明文存放数据库密码和 API Key,不支持从环境变量或密钥管理服务读取,在团队协作中存在安全风险。
4. 批处理能力有限
虽然 orchestrator 支持 batch fetch,但没有增量同步机制,全量同步在数据量大时耗时较长。
2023-2024 年是向量数据库爆发年。Pinecone 融资超 1 亿美元,Qdrant 和 Weaviate 社区蓬勃发展,Milvus 在蚂蚁集团内部承担了大规模向量检索任务。各大厂商都在抢占向量数据库的生态位。
但向量数据库只是基础设施,真正的瓶颈在于"如何高效地把数据送进去"。VectorETL 瞄准的正是这个痛点——不是做一个新的向量数据库,而是做一个连接各种数据源和各种向量数据库的"数据管道中间件"。
随着 RAG(检索增强生成)架构在企业 AI 落地中越来越普及,VectorETL 这类工具的价值会持续增长。它让数据工程师不用从零造轮子,可以专注于业务逻辑而不是底层数据转换细节。
VectorETL 是一款定位清晰的向量数据库 ETL 中间件,用工厂模式实现了数据源、向量模型和目标数据库的完全解耦。适合需要快速构建向量数据管道的 AI/数据工程师,但目前处于 Alpha 阶段,缺乏容器化支持和 Web UI,生产环境使用需谨慎评估稳定性。
