
feynman
Companion-Inc/feynman加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
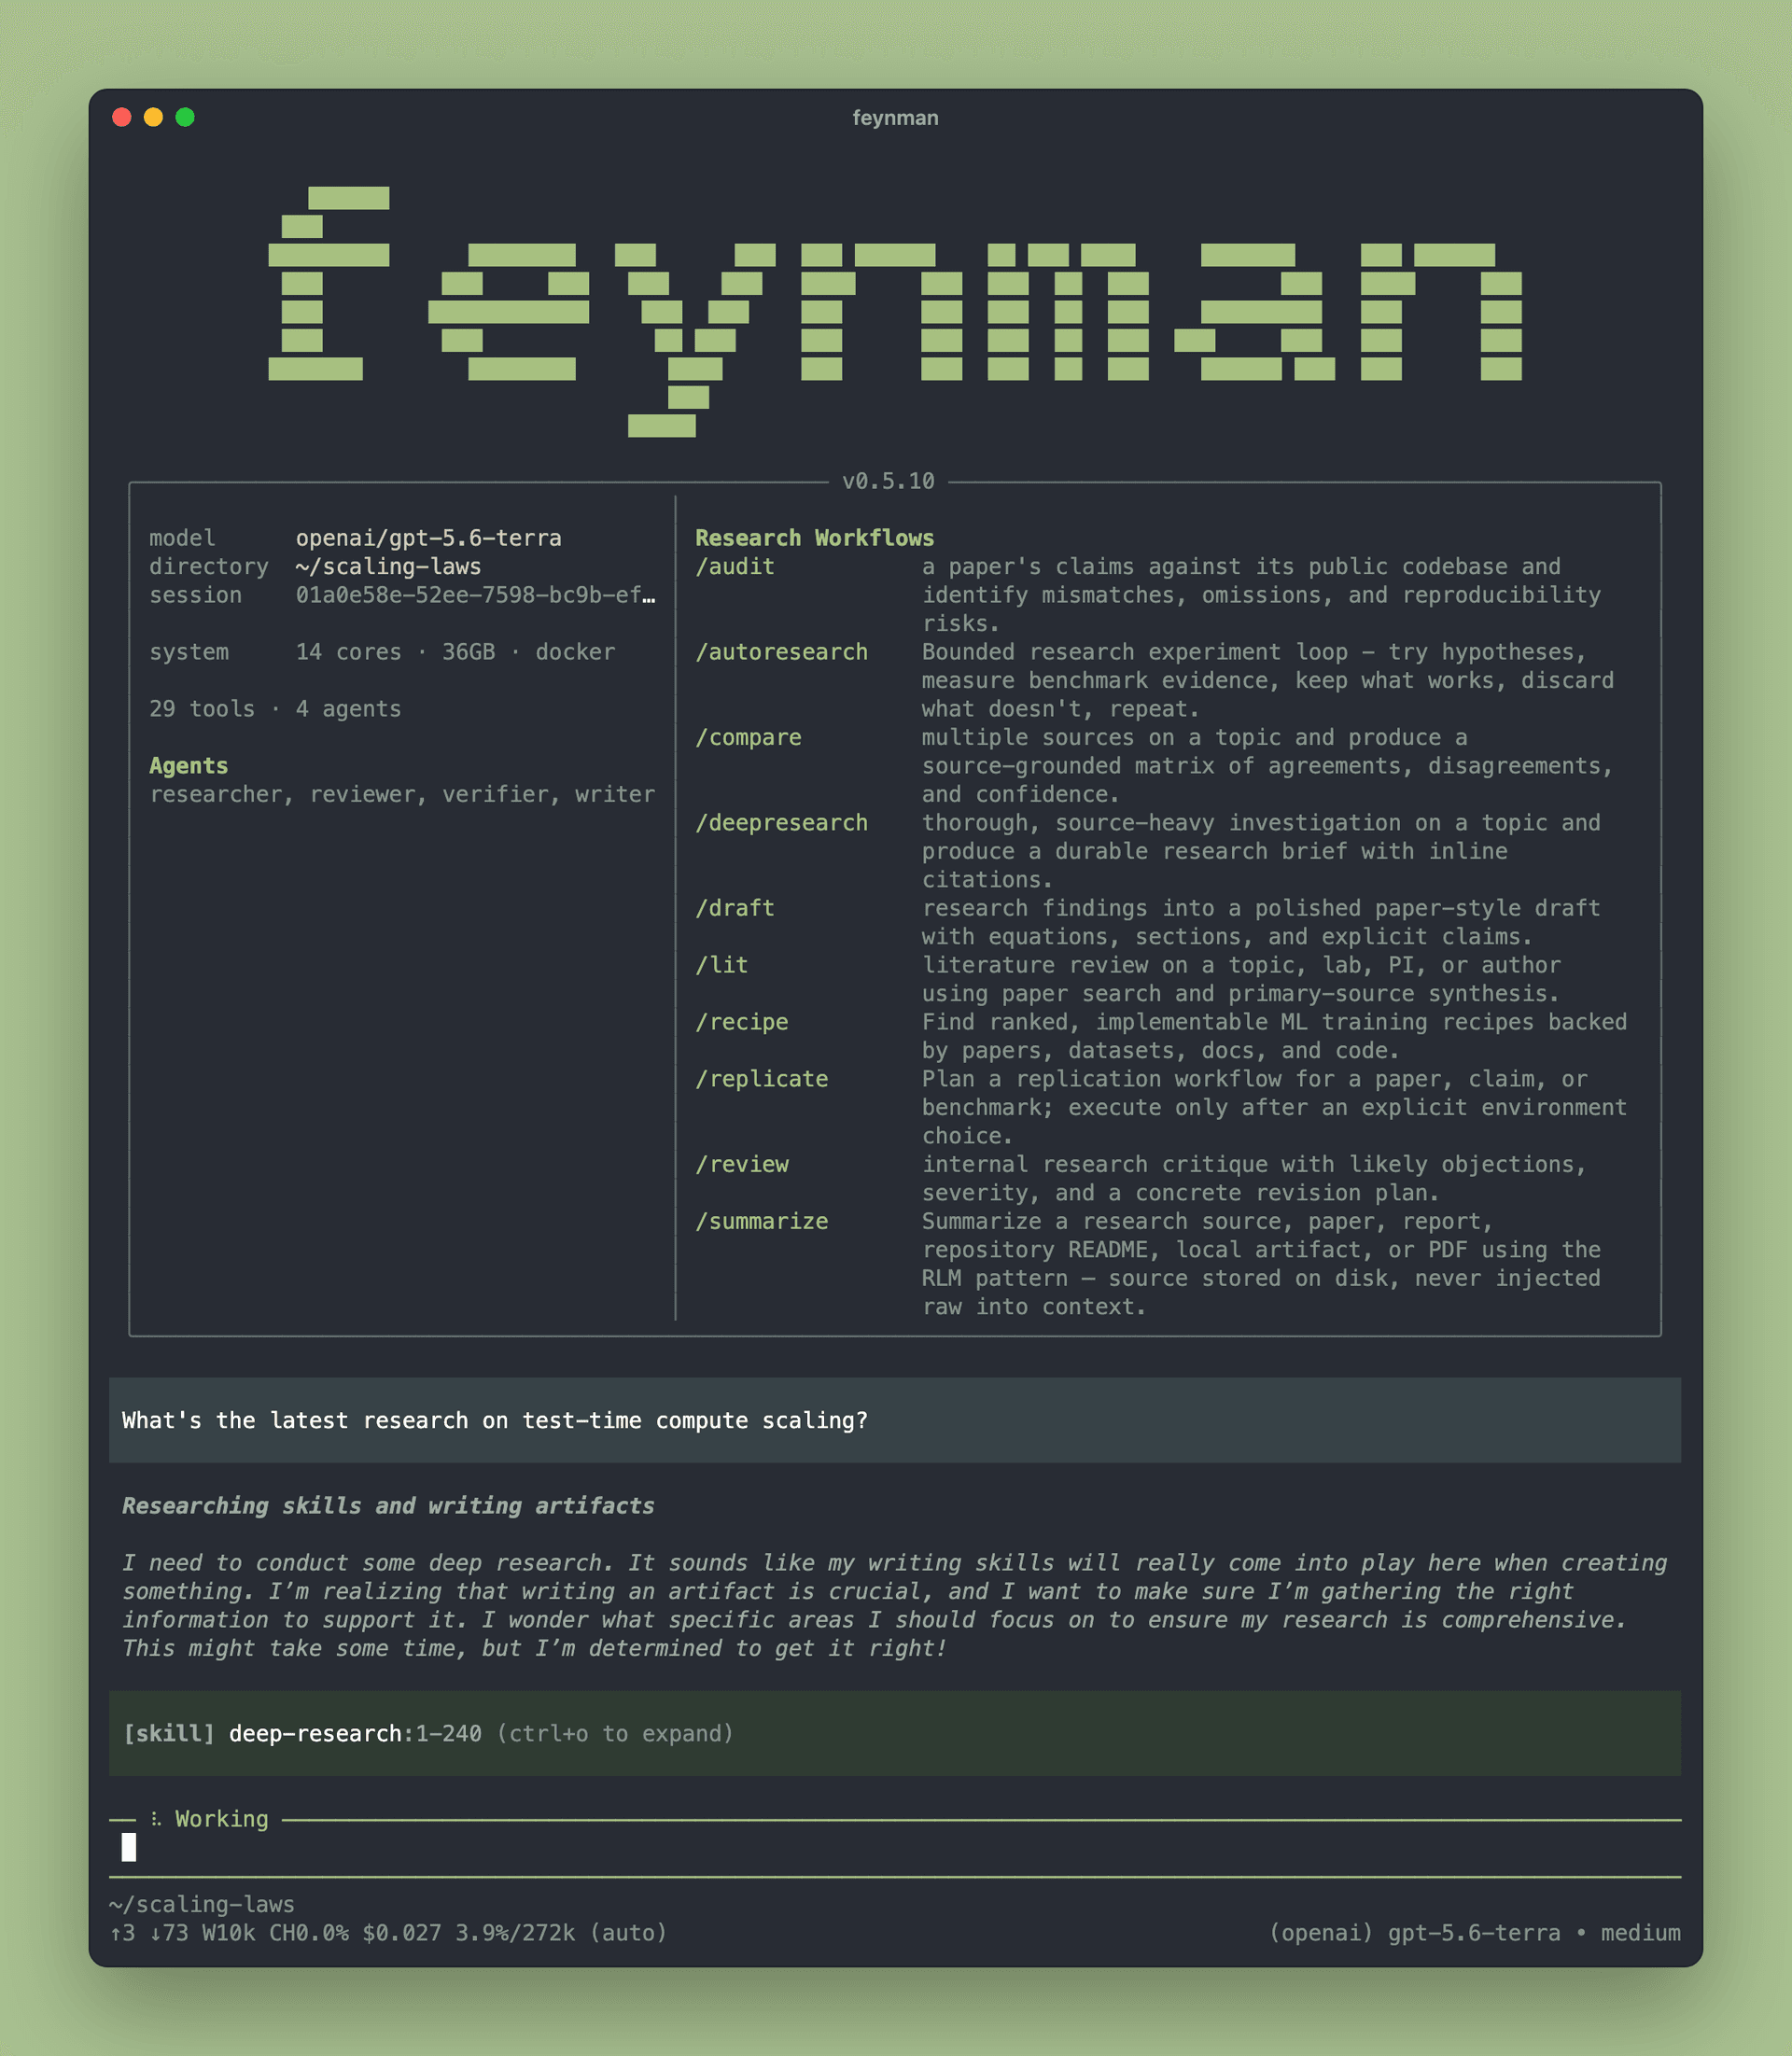
图:Feynman 官方 CLI 界面(来自项目仓库 assets/hero.png)
假设你是算法团队的研究员,凌晨两点要判断「某个 scaling law 的结论在 2026 年是否还站得住」。传统做法是:打开 arXiv 搜关键词,翻 30 篇 PDF,用笔记软件拼凑出「共识 / 分歧 / 开放问题」三段结论。这套流程的问题不在于慢,而在于不可复现——三个月后你自己也想不起来当时引用了哪篇文章、那句话到底在第几页。
Feynman 就是冲着这个问题来的。它由 Companion 公司开源,定位是「The open source AI research agent」。你装好之后只需要敲:
feynman deepresearch "mechanistic interpretability"
然后等待。工具返回的不是一段流畅的散文,而是一份带溯源文件的研究结论——/lit、/deepresearch、/recipe 这三个工作流还会额外写出一个 provenance 文件,列出用了哪些来源、哪些被验证过。
Feynman 的底座是 Pi,一个来自 earendil-works 的 Agent Runtime。这一点决定了它的形态:它不是把 LangChain 那一套重型抽象再包一层,而是站在 Pi 之上,自己只做「科研工作流」这一层薄薄但关键的业务逻辑。
它内部跑四个专职 Agent:
数据源覆盖得相当扎实:alphaXiv、Semantic Scholar、OpenAlex、arXiv、PubMed、Europe PMC、bioRxiv、medRxiv、Crossref、通用 Web 以及 Hugging Face,同时支持读取本地 PDF 和文档。OpenAlex 和 Semantic Scholar 提供免费 API Key,配置后可以绕开共享限流。
把 Feynman 想成一位「科研助理 + 审稿人」的组合体,而不是搜索框。搜索框给你十个链接然后撒手,Feynman 给你的是一条链路:问题 → 检索 → 核验 → 分级评审 → 成稿,链路每一环都有产物落盘。这个差别在写论文、尽调、做技术选型调研时价值最大——因为这些场景真正费时间的不是「找到信息」,而是「判断信息可不可信」。
内置 11 个工作流,覆盖面比多数同类工具宽:
| 工作流 | 干什么 |
|---|---|
/deepresearch <topic> | 并行研究员 + 引文核查的深度调研 |
/lit <topic 或实验室> | 文献综述:共识、分歧、开放问题 |
/review <论文或草稿> | 按严重度分级评审并给修改计划 |
/audit <论文> | 把论文声明和公开代码逐条对照 |
/replicate <论文> | 复现实验方案(选定环境后才实际执行) |
/recipe <task> | 带数据集与代码的训练配方排序 |
/compare <topic> | 来源对比矩阵 |
/draft <topic> | 从研究结论生成论文体例草稿 |
/autoresearch <idea> | 对着 benchmark 跑有边界的实验循环 |
/summarize <source> | 论文、仓库或 PDF 摘要 |
其中 /audit 和 /replicate 最值得玩味:/audit 干的是「论文说了什么」对照「代码实际做了什么」,这是审稿人最花时间也最容易出错的部分;/replicate 先给方案、由你选环境、再执行,主动权在用户手里,避免 AI 自作主张拉一堆依赖跑几小时。
产物保存在 outputs/,论文草稿落在 papers/。
Feynman 是纯 CLI 工具,没有 Web UI,这是最需要提前说清楚的差异——它适合终端党,不适合想点按钮的人。
安装极简,macOS/Linux 一行 curl,Windows 一行 PowerShell;也支持 npm install -g @companion-ai/feynman(要求 Node.js 22.22 或更高)。装完执行 feynman setup 配置模型供应商即可。
硬件门槛几乎为零:不需要 GPU,1GB 内存、300MB 磁盘起步,因为推理全在供应商侧。它自己只做检索编排与文件读写。
遥测默认开启。 Feynman 会向 PostHog 上报命令、工作流、工具、模型、token 数和错误堆栈(家目录路径会被折叠成 ~)。官方声明不上传 prompt、模型输出、论文内容和工具参数,隐私边界划得还算清楚,但默认开启这件事本身对敏感场景不友好,需要显式设 FEYNMAN_TELEMETRY=off 才彻底干净。
结论质量取决于模型。 它是编排器不是知识库,底层模型选得弱,verifier 这道关就形同虚设。
依赖外部学术源可用性。 arXiv、PubMed、Hugging Face 任一不可达,相关工作流就会降级,这时它宁可少给答案也不该编——但使用者仍需自己核对 provenance 文件。
项目较新。 版本号还在 0.5.x,API 与工作流名仍可能变动,CI 与测试覆盖率没有公开数据。
2024-2025 年开源科研智能体百花齐放,但大多数停在「给论文起标题」这种演示级能力上。Feynman 的差异在于它把 verifier(核验)和 provenance(溯源) 当成一等公民——这两件事恰好是「AI 写的东西能不能直接用」的分水岭。
从行业曲线看,AI 辅助研究正从「加速阅读」走向「加速验证」。当核验环节也被 Agent 化,AI 在科研链条中的位置就从辅助工具变成了准合作者。Feynman 用 MIT 协议开放全部实现,让这套「可审计的研究流水线」可以被拆开、被改、被嵌入到实验室自己的工作流里。
对团队的现实价值:把重复性的技术调研、论文预审、方案对比固化成一条可重复执行的命令;对个人:把「我到底引用了什么」从记忆负担变成文件证据。
