
openworkbuddy
CatCatUncle/openworkbuddy加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
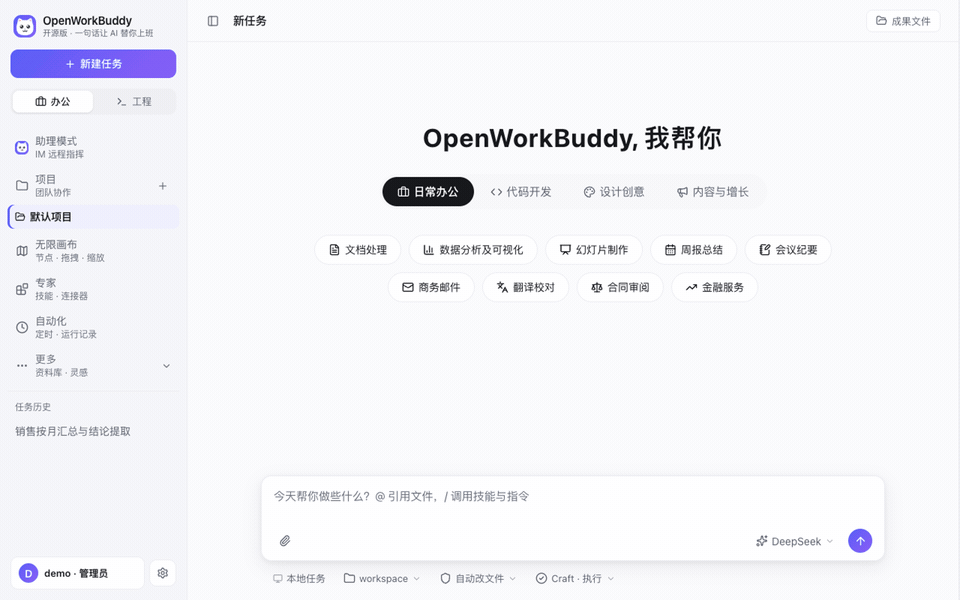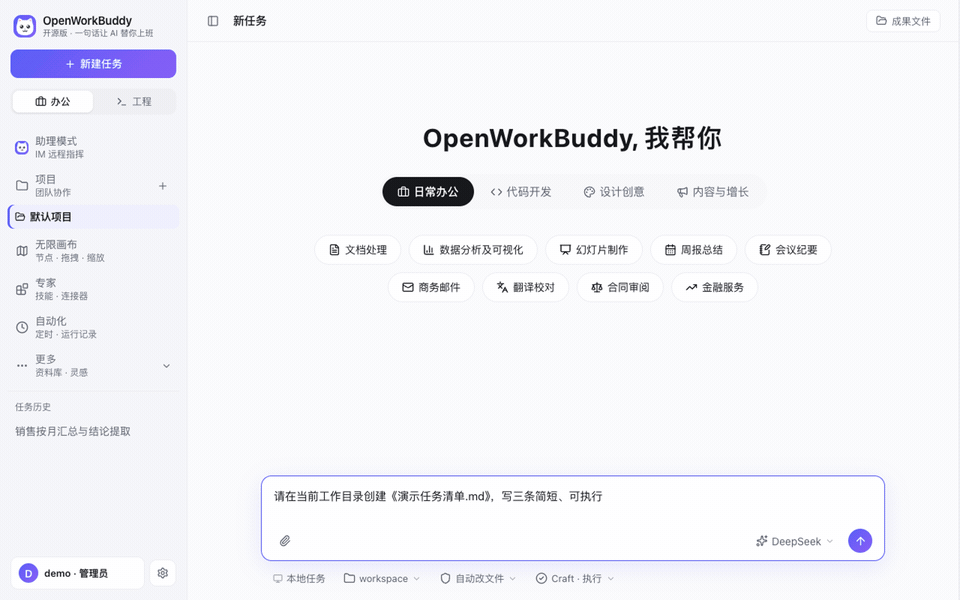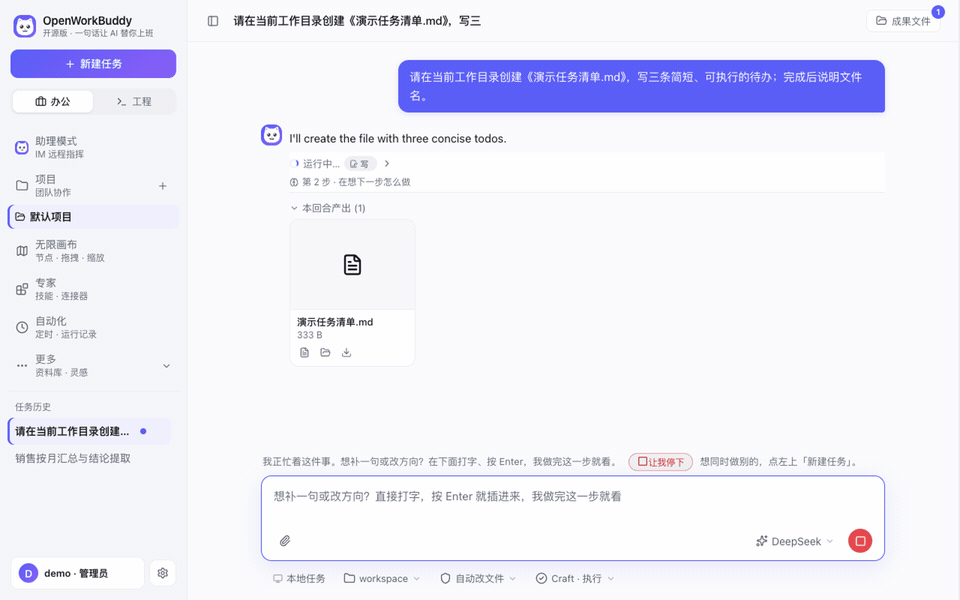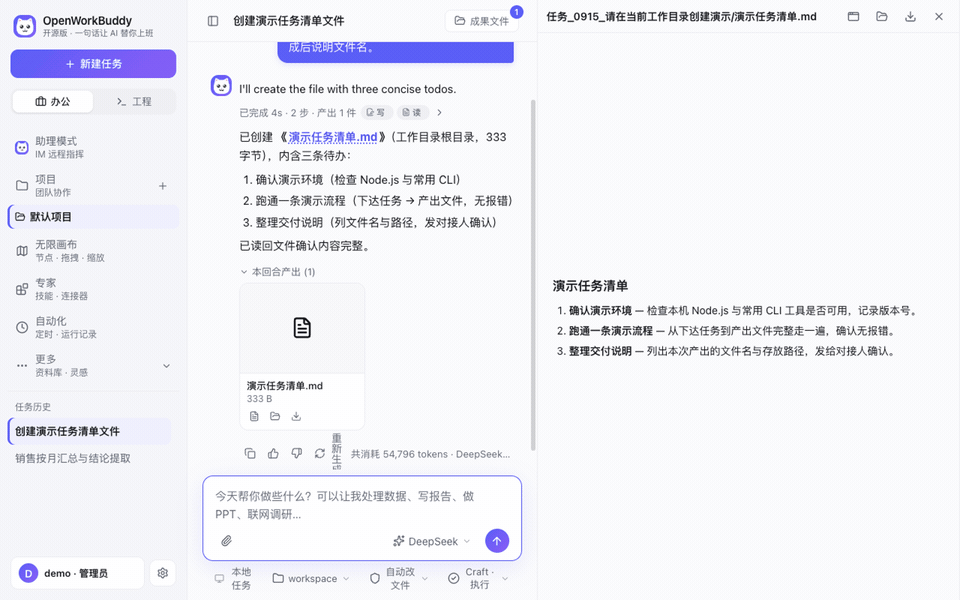
周报截止前两小时,你手里有一份销售 Excel、一份会议录音转写和一个还没做完的汇报框架。传统做法是打开三个软件、复制粘贴、反复调格式。你打开 OpenWorkBuddy,用一句"帮我出一份 Q3 复盘 PPT,数据用这个 Excel",它自己读表、算指标、生成一份能双击打开、正文可编辑的 .pptx,落在磁盘上,而不是聊天框里的一段文字。
这就是这个项目最想解决的事:AI 办公的交付物必须是文件,不是回复。作者在 README 里专门写了"成功标准"——磁盘上有非空的 project-update.pptx,能被 PowerPoint 打开,四页内容与输入一致,并且第二轮能改同一份文件的第 4 页。看到"安装完成"或"已完成",都还不算成功。这份克制贯穿了整个项目的设计。
作者署名"开发者猫叔",2026 年 8 月 10 日建仓,两个半月涨到 363 star、79 fork,762 次提交,几乎全部由一位核心贡献者完成。这不是团队项目,而是典型的"个人痛点驱动"项目:猫叔自己天天做 PPT、周报、调研报告,被通用 Agent 的短板反复刺到——数据留在云端、成果停在对话框、换个模型要重配一遍。
项目对标明确写在文档里:Claude Code、Claude Cowork、Codex、DeepSeek Agent、豆包、通义、Qwen。每一个对标页都是一张对比表,这在国内 AI 应用项目里不算常见。
如果把通用 AI 助手比作秘书,你交给它一份材料,它口述一份摘要,你再手动复制进模板。OpenWorkBuddy 更像一间车间:你把料放上工作台,机器自己规划工序、动工具、检验成品,成品从传送带上滚下来。差别在于——车间里的机器有手(有 shell 和文件系统),也能自己验(验收节点)。
代价也很直白:车间里的机器能做很多事,所以围栏必须严。默认只监听 127.0.0.1,Docker Compose 默认只绑回环口,容器里 agent 能执行 shell、能读写文件,作者在 Dockerfile 注释里直白警告"别 -p 0.0.0.0:3800 直接挂公网",并要求第一个注册的账号立刻成为管理员。
第一条是文件交付。 内置 pptxgenjs、docx、exceljs、mermaid、echarts、@viz-js/viz,把 PPTX/DOCX/XLSX/HTML 生成做成一等公民。仓库里有 skills/docx、skills/excel-report、skills/ppt-design、skills/infographic、skills/data-viz 等 40 多个技能包,全是 Markdown 文件。
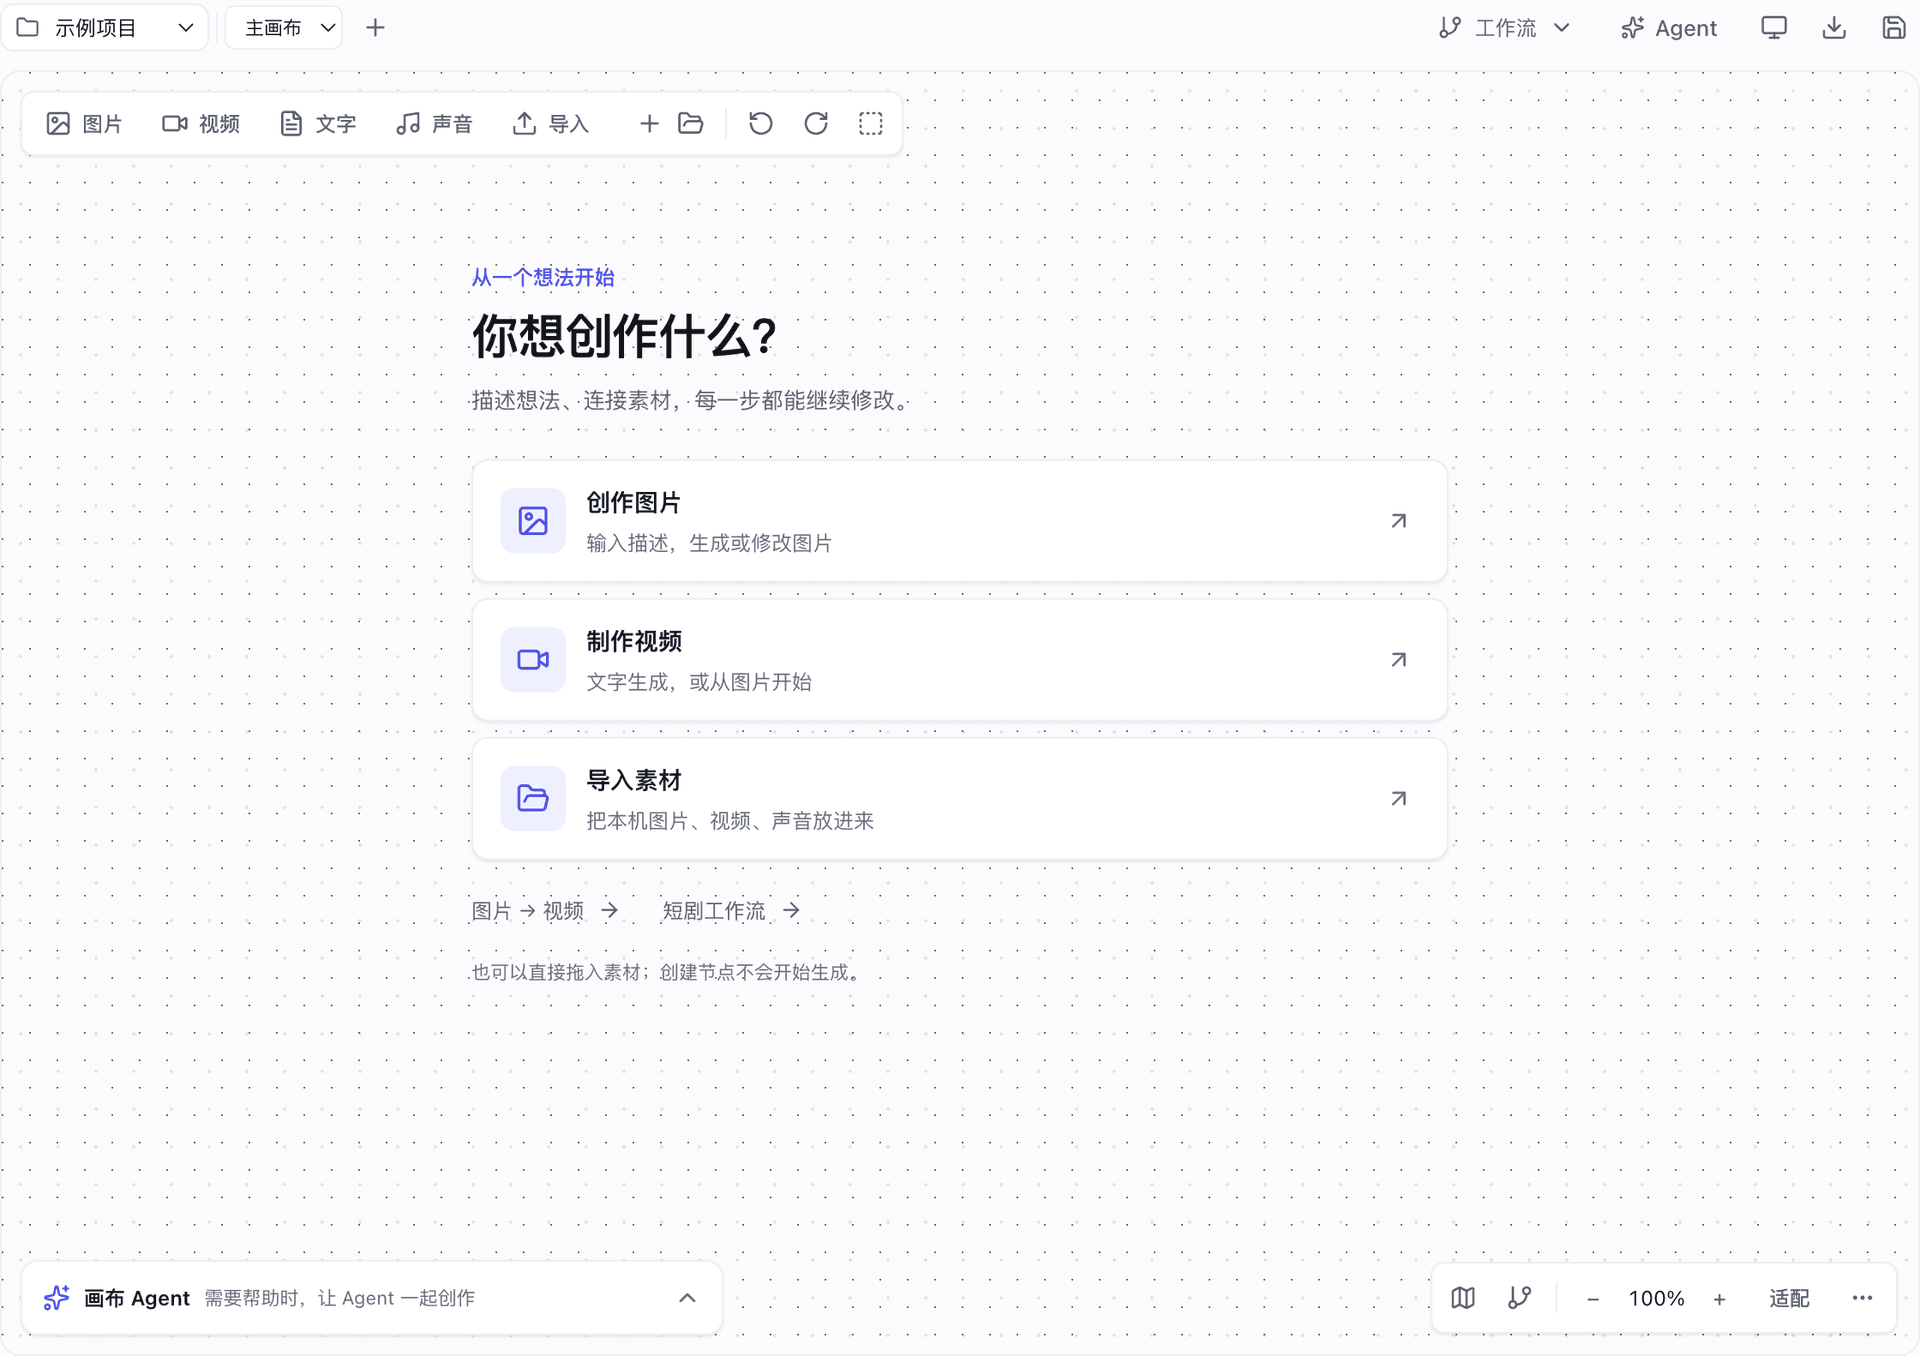
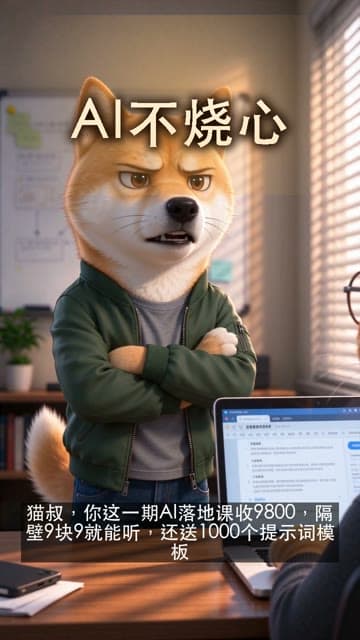
第二条是创作无限画布与多模态。 从一张图、一段视频开始,卡片里写描述、连参考、生成、做变体。短剧流水线已经能跑通:一句"做一集《不烧心》竖屏短剧",剧本、定妆、分镜、首帧、镜头视频、成片一路做到底。
第三条是模型与引擎自由。 DeepSeek、通义、智谱、Kimi、OpenRouter、Ollama、火山方舟,界面点一下切换;更狠的是可以把本机已登录的 Claude Code 或 Codex 直接当"发动机",跑在已付费的订阅上,不烧 API 额度。作者管这叫 BYOK 的延伸——连推理算力都可以是本地的。
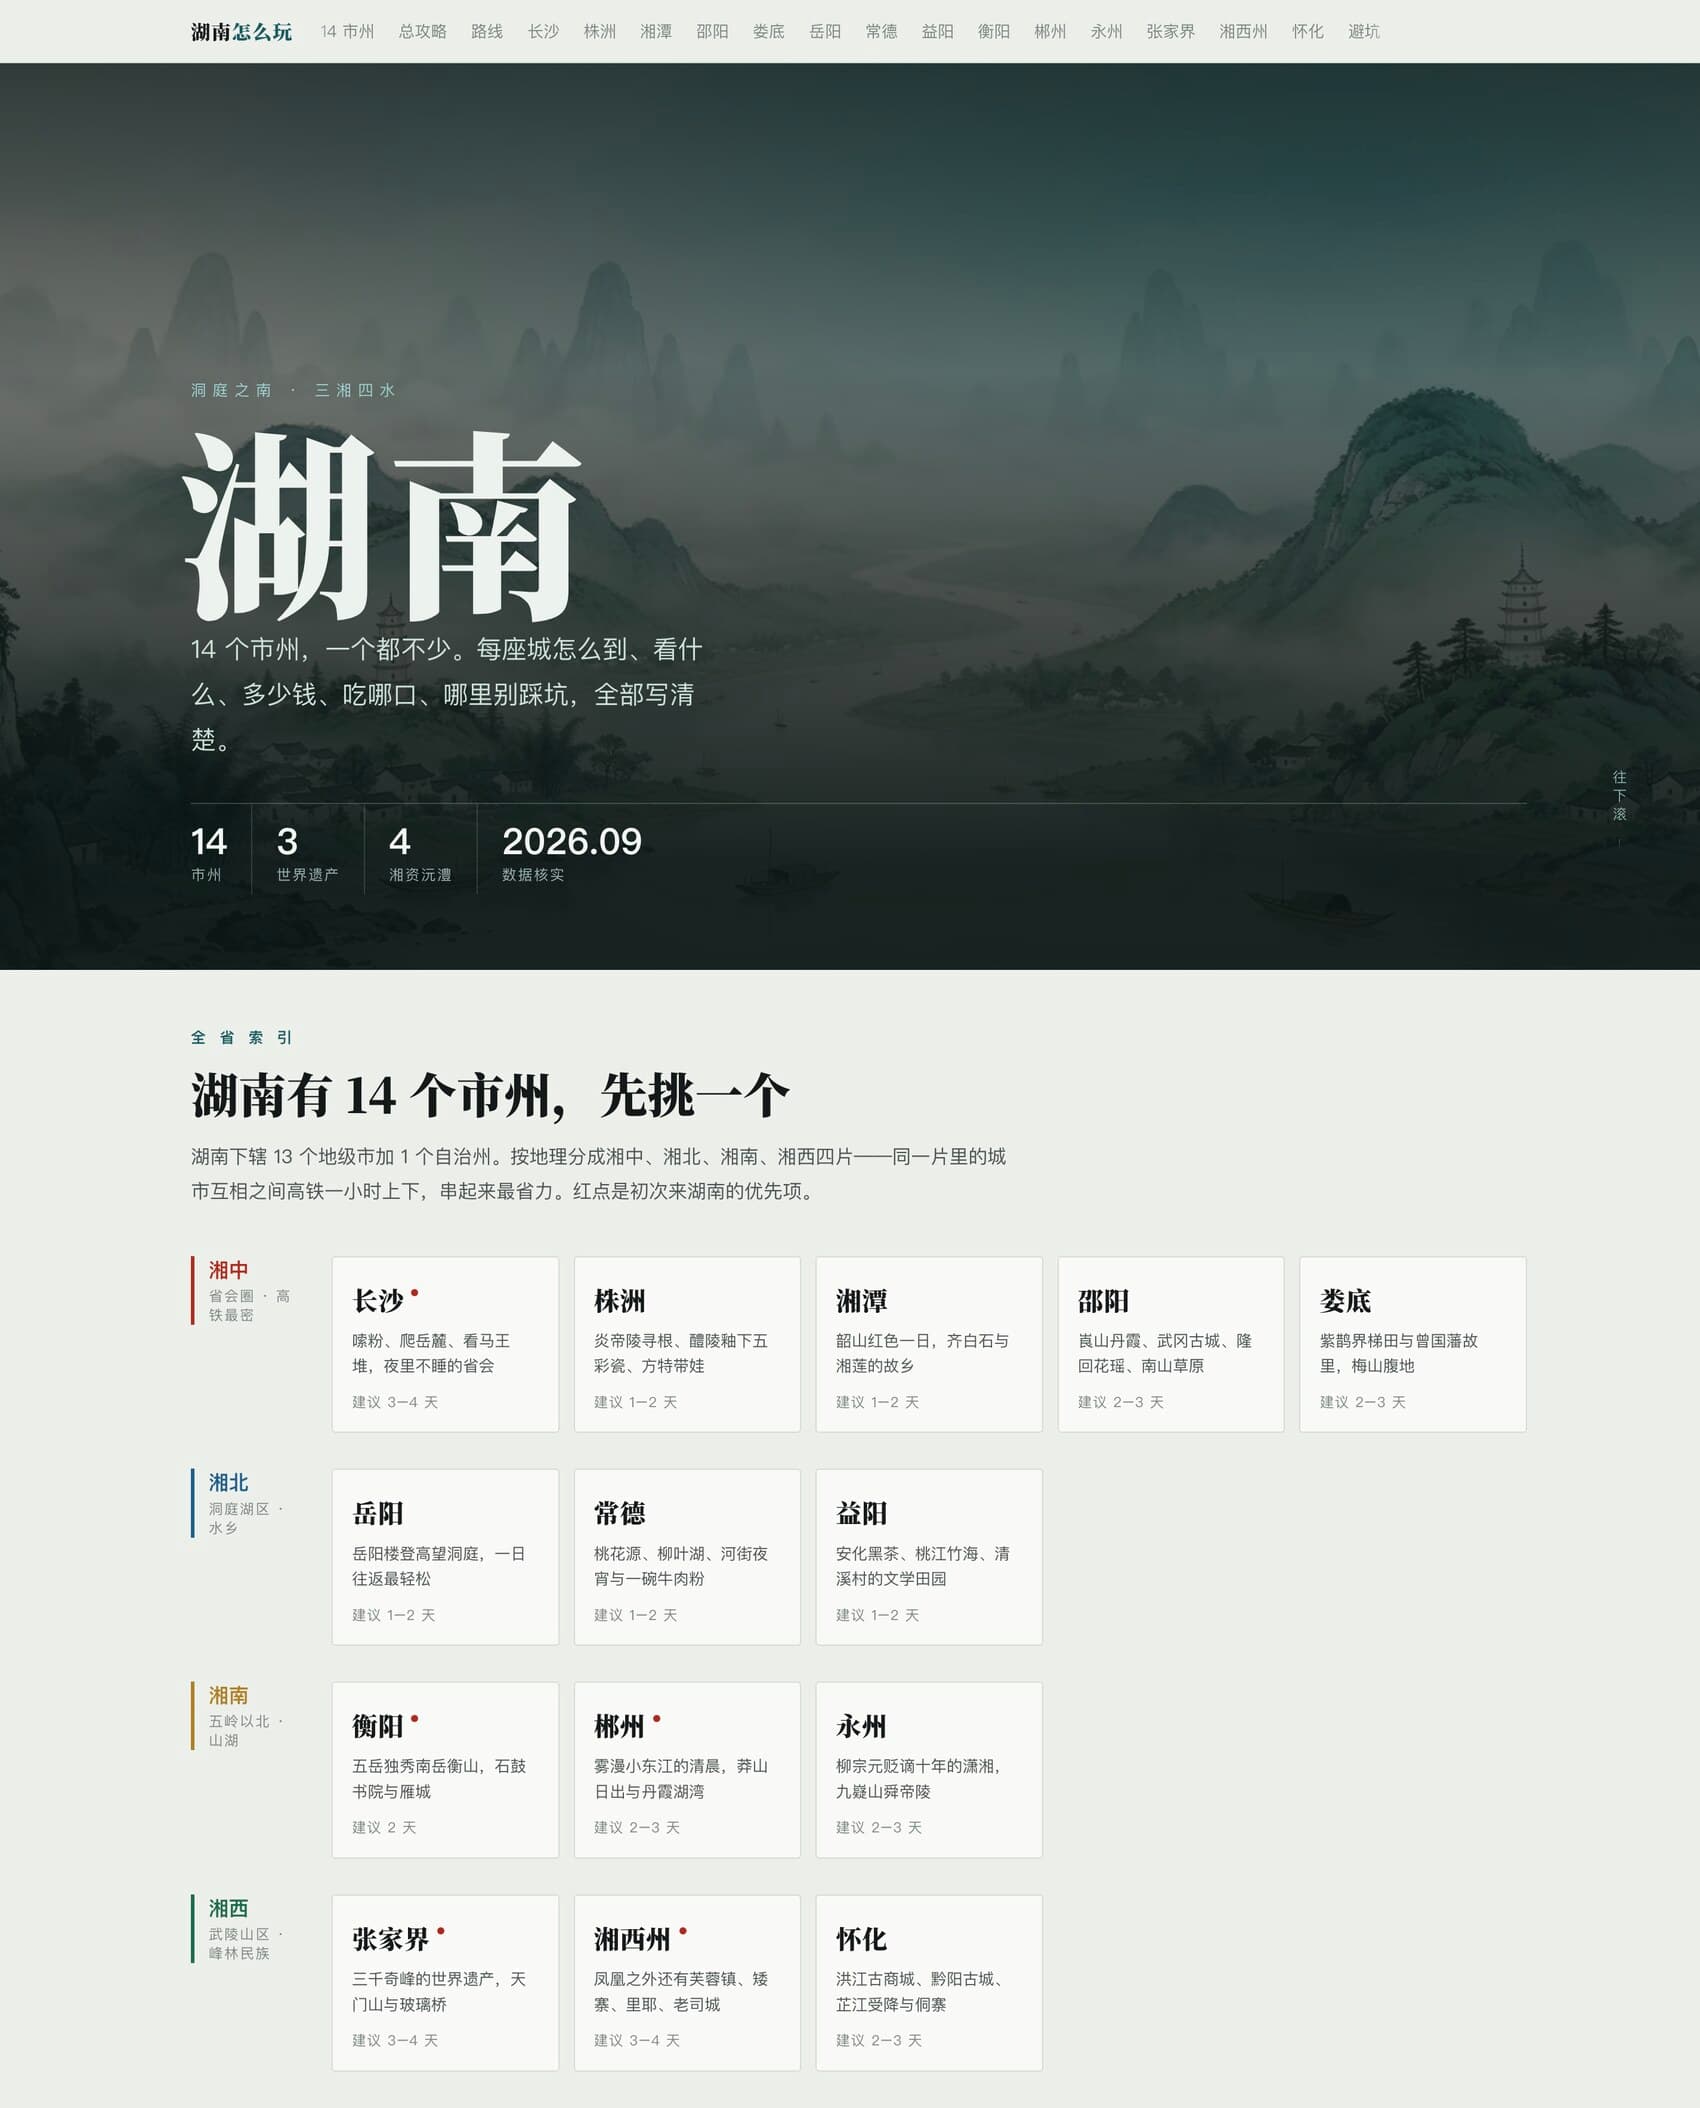
这是我认为最有杠杆的设计。skills/<名字>/skill.md 丢进目录,下一条任务就生效,不改代码、不重启、不打包。技能可以写模型调用参数、写脚本(skills/wechat-article/scripts/publish.py 就直接调接口发公众号),也可以声明输出格式约束。用户自己写的技能、插件、工作流不继承项目的许可证,这一点作者在 LICENSE 里写得非常清楚。
我本来以为这是个"套壳 Demo",结果读代码架构文档时被震了一下。仓库实行七层依赖规范:L0 工具 → L1 平台 → L2 核心 → L3 业务域 → L4 智能体 → L5 应用 → L6 入口,只许向下或同层 require;L5 的 server/cli/im/desktop 四块互不横向依赖;不许有环。test/layers.js 直接从源码语法树里抠出依赖边逐条校验,CYCLE_ALLOW 和 SPAWN_ALLOW 两张例外名单锁定为 0,不许扩充绕过。
更狠的是"不许 require 入口文件"这条:路由要用 server.js 里的鉴权,就由 server.js 挂载时通过 deps 参数传进去,而不是回头 require("../../../server")——因为入口一 require 就是整台服务器跟着起,测试也没法单独加载。这不是随手写的约定,是踩过坑才有的规矩。
测试目录 186 个文件,覆盖 agent 循环、权限闸、计费配额、迁移、备份、渲染等几乎所有子系统;eval/ 目录有 baseline、judge、rejudge 一整套评测流水线。700 多文件的仓库 80% 是 JS,server.js 单文件 62 万字符(很胖,是明显的架构债),cli.js 21 万字符同样偏大。
许可证是最大的坎。 项目主体是 PolyForm Noncommercial 1.0.0——个人非商用、学术、公益免费,公司内部使用也算商用,需要单独商业授权(作者留了 aijentra.com 邮箱)。只有部署与 CI 配置、辅助脚本、评测集、模板和文档示例是 MIT。对企业用户来说,这意味着"能跑起来"和"能合法用起来"是两件事,评估前必须先确认授权边界。
macOS 签名未公证。 README 明确写"当前 macOS 发行包使用本地签名,尚未通过 Apple 公证",用户首次打开要手动进"隐私与安全性 → 仍要打开"。这在企业安全策略下基本等于拦死。
单点作者风险。 contributors 只有 1 人,762 次提交几乎全在一支笔上。代码质量再高,bus factor 也只有 1。
成熟度存疑。 README 自己写着"'三分钟'是优化目标……当前没有发布实测成功率",采用指标文档里也标注缺失。仓库 775 个条目、两块 23 万/25 万字符的 CHANGELOG,说明迭代极快,但也说明变化极快。
安全面较宽。 agent 有 shell 权限、能读写文件、能装 Chrome 扩展、能录浏览器操作;虽然有 src/core/safety/ 下的权限闸、命令风险评估、网安策略和技能守卫,但这类系统的攻击面天然大,Docker 部署时作者自己也在反复强调别裸奔公网。
2026 年下半年开源 AI 办公赛道出现明显分化:一类做闭源 SaaS 卖订阅,一类做 Agent 框架给开发者,OpenWorkBuddy 走的是第三条——本机优先、BYOK、文件级交付、开源可自托管。363 star、单机 61MB 仓库体积、纯 JS 技术栈、零构建依赖(npm ci 后 npm start),门槛压得极低。
它最有价值的一点可能不是产品本身,而是那套七层依赖规范 + 语法树级架构测试:在一个 700 文件、每周多次发版的 Electron + Node 单体仓库里做到零循环依赖,说明"AI 写的代码"在有强约束的工程纪律下也能长期保持可维护。这套做法可以直接抄。
对国内团队的实际建议:个人和小团队可以直接白嫖非商用授权跑起来验证;公司要正式用,先谈商业授权,同时把 Dockerfile 里的安全项逐条过一遍(回环绑定、反代、HTTPS、注册管理员、Key 只存 config.json)。部署门槛极低——bash deploy.sh --domain buddy.example.com 一条命令完成 Docker 构建、启动和 Caddy 自动 HTTPS,数据全部落在宿主机 ./openworkbuddy-data 一个卷里,容器随便删随便重建。
