
long_llama
CStanKonrad/long_llama加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你要让模型读完一整座代码仓库,再回答"这个鉴权逻辑在哪些地方被绕过"。模型确实读了,但读完就忘——因为标准注意力机制在长文本上开销太大,实践中大多数团队只能截断输入,模型看到的往往只是仓库的冰山一角。
LongLLaMA 给出的解法叫聚焦式训练(Focused Transformer, FoT)。它的思路听起来反直觉:保留完整的序列输入,但只让注意力层在少量关键标记上做充分计算,其余标记仅保留浅层表示,其余注意力层照常工作。训练时还刻意把无关文档的键作为负样本一起喂给记忆注意力层,逼模型学会区分"哪些键与当前值语义相关"。
效果是:训练时只见过 8k 长度的输入,模型在 passkey 检索任务上却能处理 256k 长度的输入。而且关键在于成本可控——项目同时开源了 30 亿与 70 亿参数两档基座,以及配套的指令微调版本,权重可直接通过 HuggingFace 加载,推理侧兼容标准 from_pretrained 接口,现有 LLaMA 实现可以直接替换。
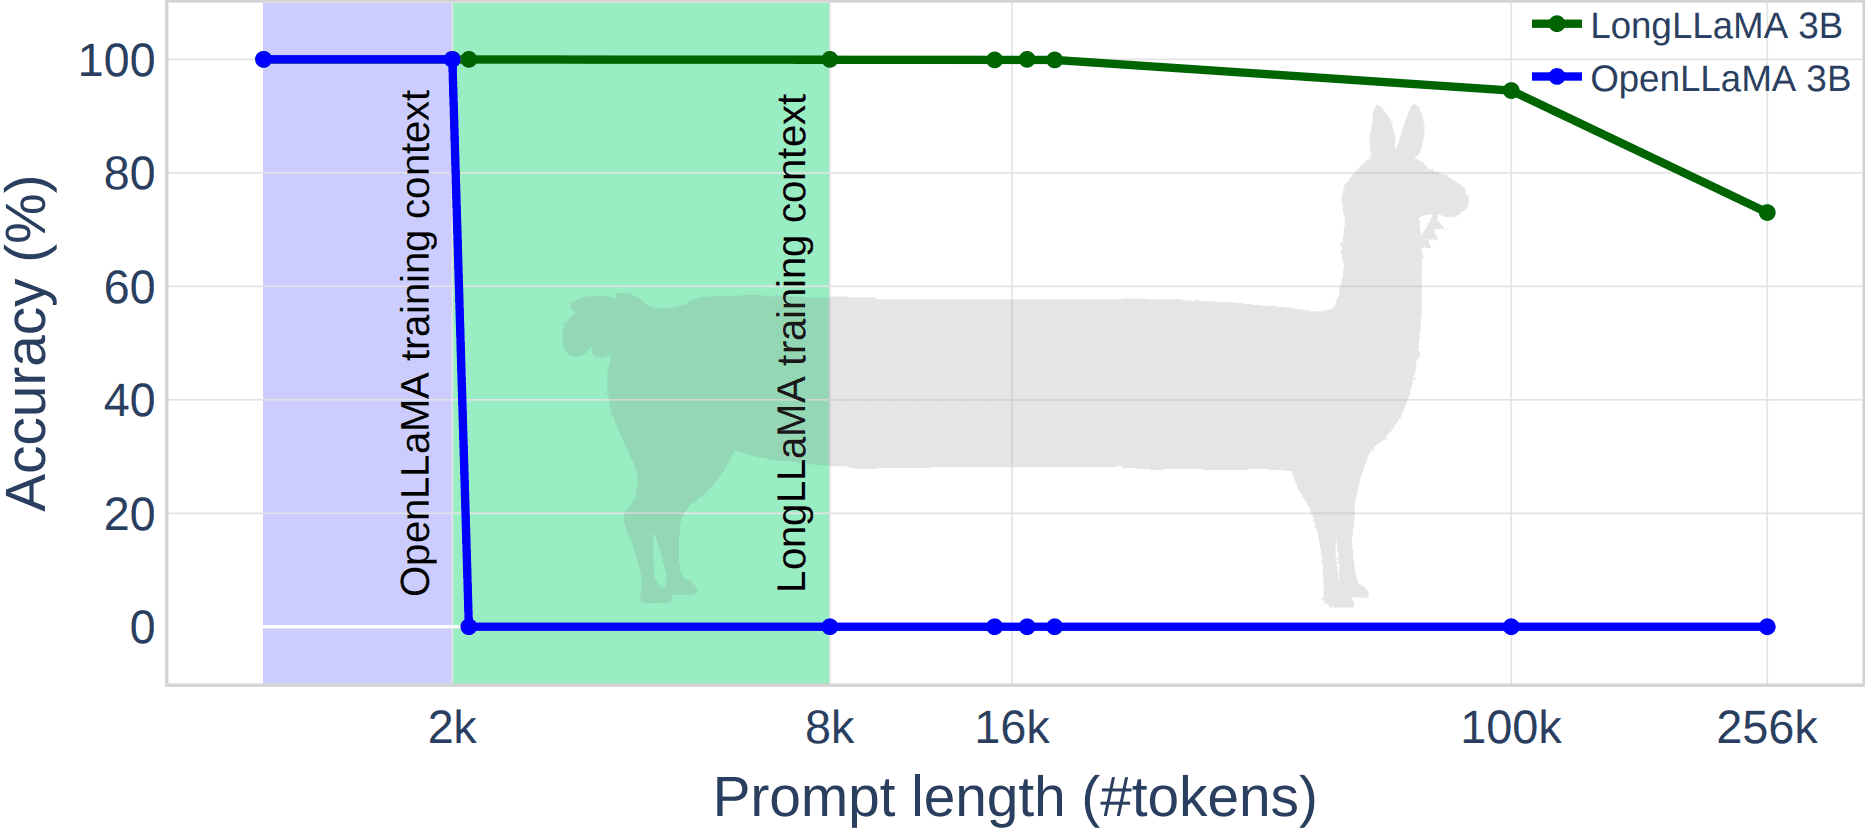
LongLLaMA 上下文长度外推效果(passkey 检索)
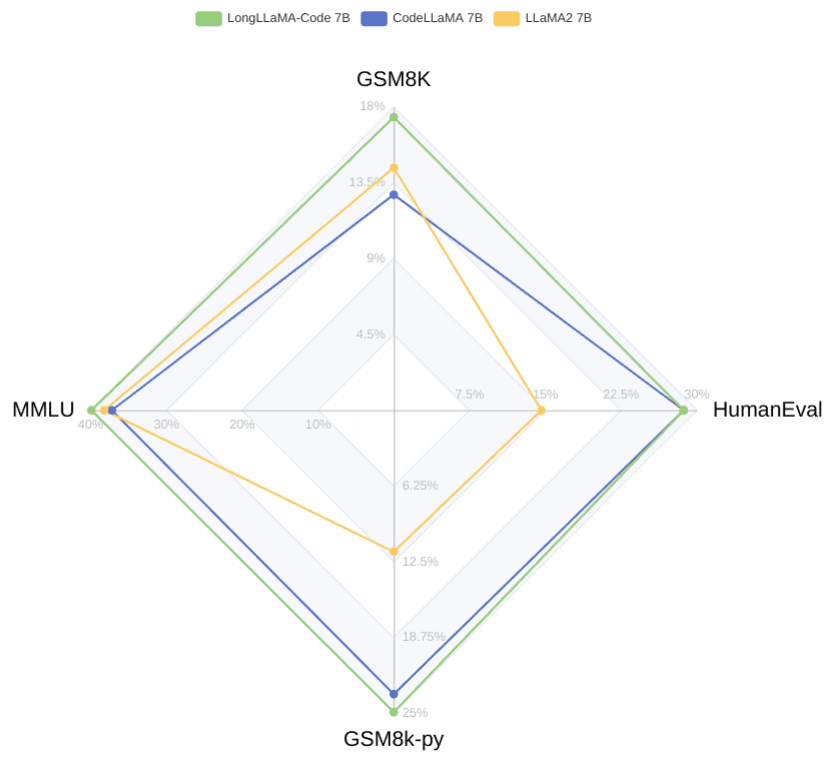
LongLLaMA 完整评测结果
LongLLaMA 出自一篇同名论文(arXiv:2307.03170),基于 OpenLLaMA 与 CodeLlama 两种开源基座构建。仓库结构清晰地分成三块:src/ 是推理实现,instruction_fine_tuning/ 是基于 HuggingFace Trainer 的指令与对话微调,fot_continued_pretraining/ 是基于 JAX 与 EasyLM 的 FoT 持续预训练代码。
训练数据方面,指令微调用了 Open-Orca 的指令集与 zetavg/ShareGPT-Processed 的对话数据;基座则直接继承 OpenLLaMA(约 1T tokens)与 CodeLlama(约 2T tokens)的预训练语料。
想象你在读一本三千页的书,只记住其中二十页的关键信息,其余页码只留个书签。等你要回答"主角为什么离开家乡"时,你只需要翻到那二十页认真读,剩下两千多页知道"大致在哪一章"就够了。
标准注意力是每一页都认真读两遍——一遍记录内容,一遍建立索引。FoT 把第二遍降级成"只记页码",于是总工作量从"三千页 × 两遍"变成"三千页 × 一遍 + 二十页 × 两遍"。
上下文外推机制是整个项目的技术核心。FoT 允许一部分注意力层访问一个(键, 值)记忆缓存,从而在训练输入远短于推理输入的情况下扩展有效上下文。LongLLaMA 使用 3 层做上下文扩展,LongLLaMA Code 使用 4 层。
推理接口走标准 HuggingFace 路线,加载模型时需要 trust_remote_code=True:
tokenizer = LlamaTokenizer.from_pretrained("syzymon/long_llama_3b_v1_1")
model = AutoModelForCausalLM.from_pretrained(
    "syzymon/long_llama_3b_v1_1", torch_dtype=torch.float32, trust_remote_code=True)
长输入会被自动切分成上下文窗口并装入记忆缓存。last_context_length(默认 1024)控制最后一个窗口保留多少 token——调大它能改善生成质量,因为靠前几层看不到记忆;mem_layers 则指定哪些层具备记忆能力。
云端体验方面,项目提供两个 Colab 笔记本(基础模型与指令版本各一),无需本地 GPU 即可先跑通效果,成本是免费额度下的时长限制。
两条微调路线并存:PyTorch 路线直接用 HF Trainer,JAX 路线则基于 EasyLM。前者更易上手,后者在多卡扩展上有优势。
门槛主要在硬件与依赖上。README 固定 transformers==4.33.2、sentencepiece、accelerate 三个包,但版本较旧,需要自行评估兼容性。运行 70 亿参数版本建议 16GB 以上显存的显卡(如 T4 勉强可用,A100 更从容)。仓库提供的是 examples/ 下的 Python 片段而非服务脚本,没有 Dockerfile,也没有 Web UI,必须自己搭环境。
三点值得明确。第一,项目维护已停滞——最后一次代码推送是 2023 年 11 月,最后一次更新是 2025 年初,依赖版本明显落后于当前生态,直接用于生产需要自己承担升级成本。第二,trust_remote_code=True 是真实的供应链风险,它会执行 HuggingFace 上的远程自定义代码,在团队环境中应先做代码审查或自建镜像。第三,外推能力的边界要理性看待:passkey 检索任务结构性强、答案可验证,而真实的长文档问答涉及多跳推理与跨段落一致性,256k 外推能力不能直接等同于"能读懂 256k 的业务文档"。
LongLLaMA 代表了 2023 年长上下文路线的一次重要探索:在不重训模型结构的前提下,用训练方法把上下文推到十倍量级。它与后来的 RoPE 缩放、长上下文继续预训练构成同一时期的三条并行路径。今天主流模型普遍支持 128k 甚至 1M 上下文,但 FoT 的方法论价值仍在——它是"用注意力稀疏性换上下文长度"这一思路的早期实证。
如果你的场景是长文档问答、代码库理解或多轮长对话,这个项目的思路与权重都值得参考;如果只是需要长上下文,直接选现成模型更划算。
