
ChatRWKV
BlinkDL/ChatRWKV加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2023 年初,一位国内开发者在本地部署 13B 级别对话模型时发现,显存被榨干到只剩几百 MB,换一句更长的上下文就直接 OOM。Transformer's KV-Cache 像雪球,越聊越滚越大的负担让"本地跑大模型"变成显卡军备竞赛。
就在那时,RWKV 系列的 ChatRWKV 出现在 GitHub 首页。它的 README 第一行写着:"ChatRWKV is like ChatGPT but powered by RWKV (100% RNN) language model"。这个项目至今保持着 9496 Star、684 Fork,是 RNN 语言模型复兴浪潮中最早也最著名的开源门面。
ChatRWKV 由彭博(BlinkDL/Bo Peng)主导开发,名字取自四个核心参数缩写 R-W-K-V。严格说它是一个推理与对话参考实现集合,而非完整的训练框架——训练、微调在同作者的 RWKV-LM 主仓库完成。
核心洞察在于:RWKV 用「带衰减的注意力机制」替代自注意力,把 Transformer 的 O(n²) 复杂度降为 O(n),且不需要 KV-Cache。模型在推理时保持一个固定大小的状态向量(state),每读入一个 token 就更新一次状态、输出一次结果。这就像一位只记要点、不记全文的速记员:上下文无限长,但"脑内"占用恒定。
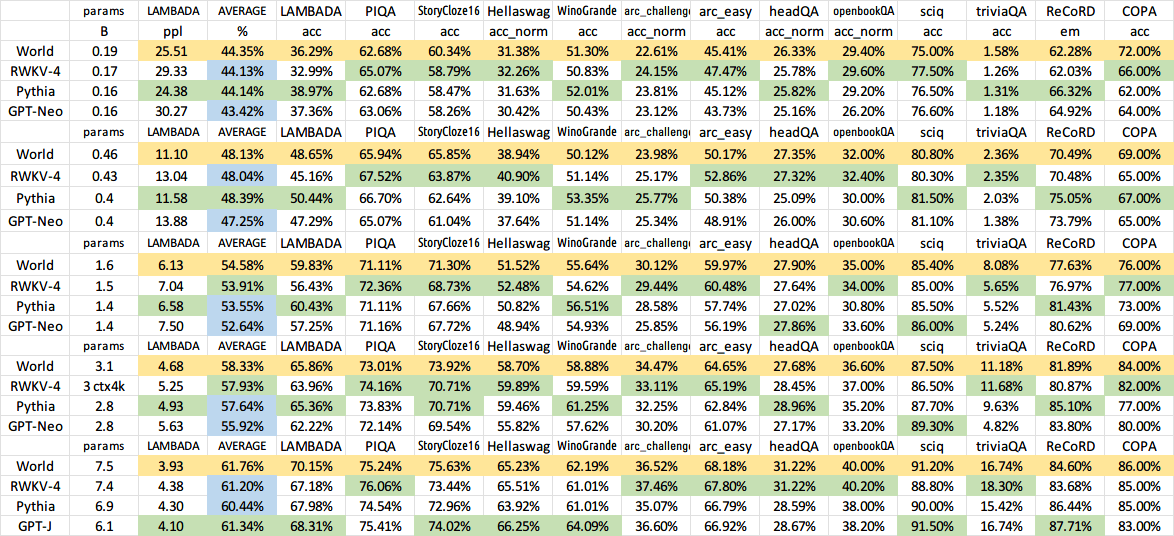
图 1:RWKV 的状态演化策略示意——递归网络靠状态传递而非注意力矩阵传递信息
项目没有停留在 v4。2023 年推出 RWKV-5" Eagle",2024 年升级为 RWKV-6" Finch"(引入数据驱动的小状态),2025 年 3 月发布 RWKV-7"Goose"。RWKV-7 论文(arXiv:2503.14456)提出带向量值门控与上下文学习率的广义 delta 规则,2.9B 参数模型在多语言任务上刷新 3B 级 SOTA。更关键的是论文给出了理论论证:RWKV-7 能识别所有正则语言,这超出了标准复杂度猜想下 Transformer 的能力边界。2025 年该项目正式成为 Linux Foundation 旗下 AI 项目。
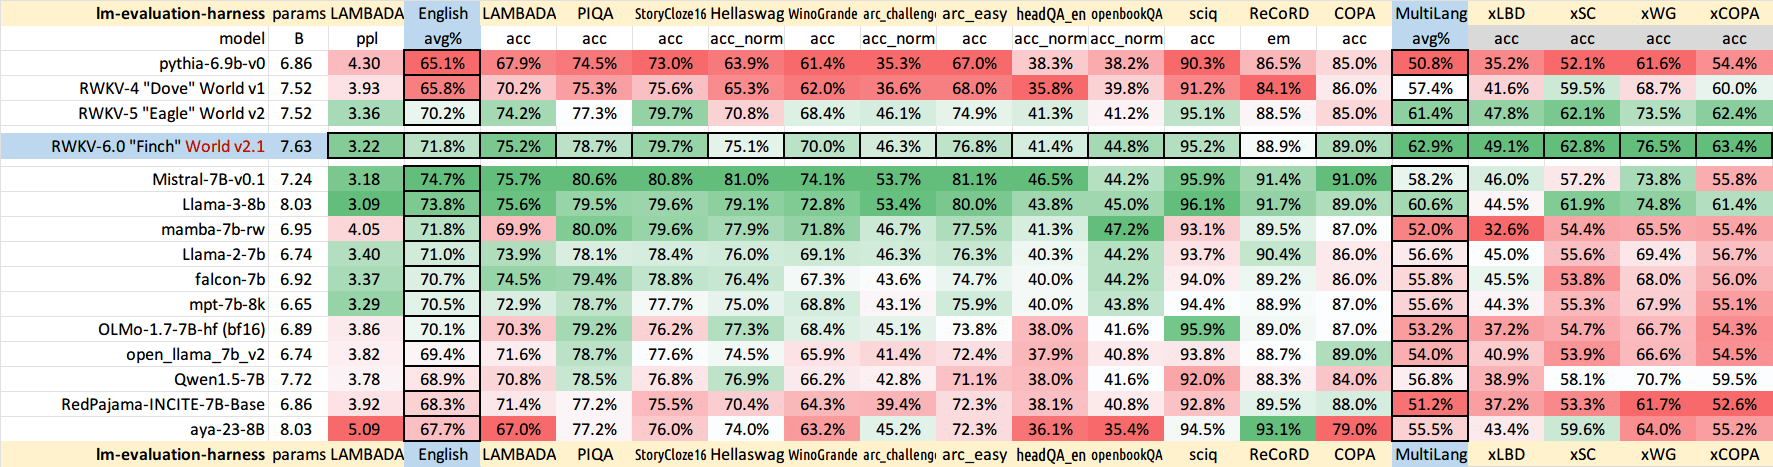
图 2:RWKV-6 "Finch" 的架构图解,展示了状态如何随 token 流演化
评测表现上,RWKV 在英文下游任务上追平同期 3B 级 Transformer,多语言能力则是其相对优势项。
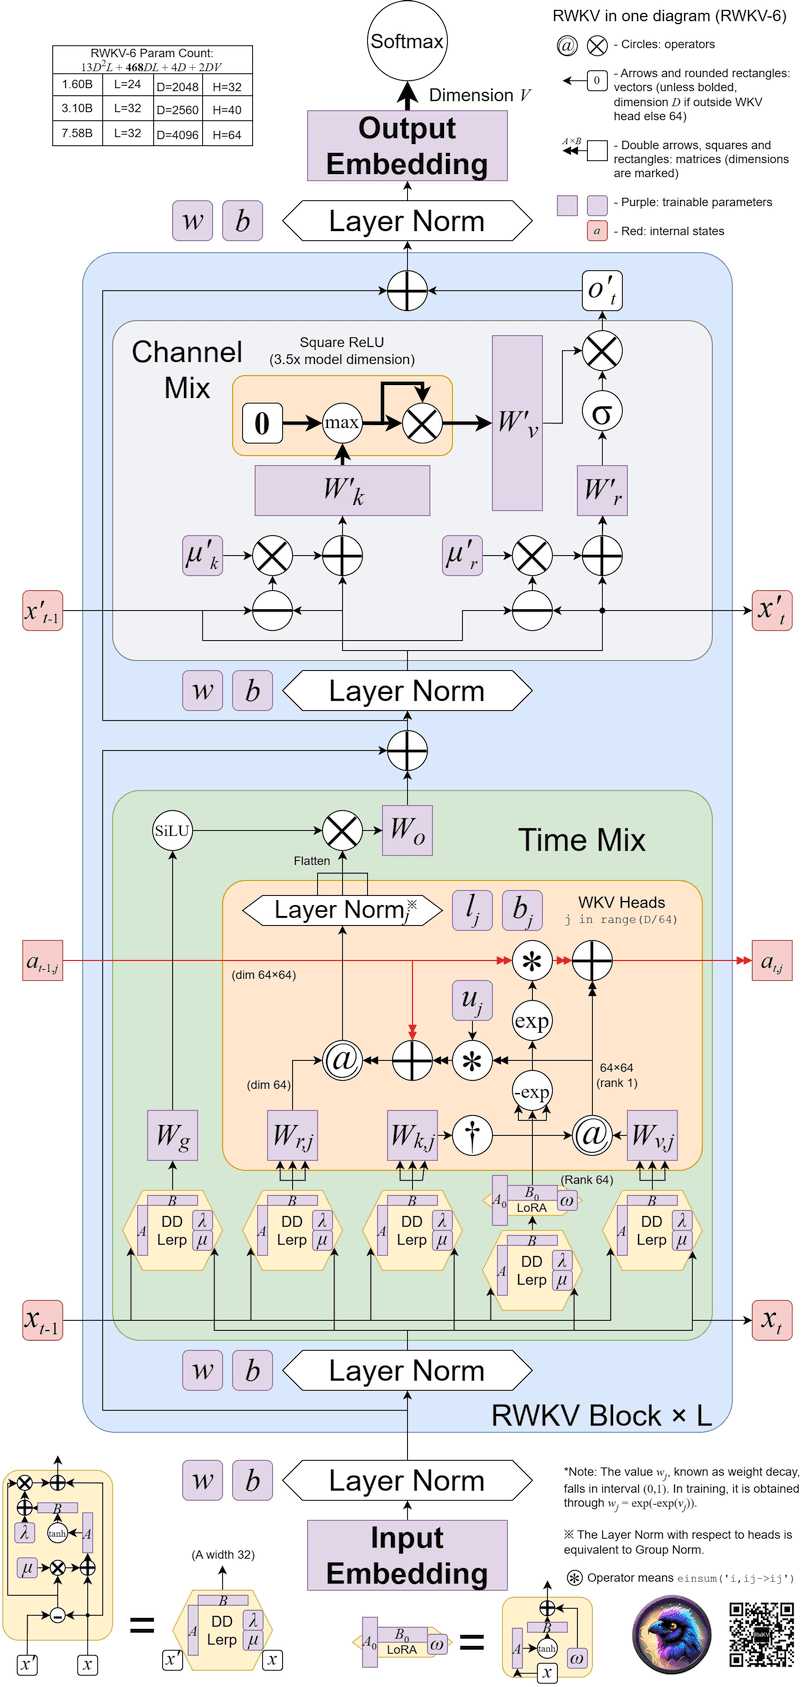
图 3:RWKV v5 在多语言基准测试上的成绩对比
路线一,Python 库直接调用(最轻):pip install rwkv,加载模型后 model.forward() 即可。项目提供了 RWKV_in_150_lines.py(150 行跑通模型+推理+生成)和 RWKV_v5_demo.py(含分词器)这类极限压缩的教学脚本,对理解原理极有价值。
路线二,命令行对话:v2/chat.py 提供终端多轮对话,支持 stream/split 两种生成策略与 INT8 量化,14B 模型在 3GB 显存即可跑动。启用 RWKV_CUDA_ON=1 会 JIT 编译 CUDA kernel,速度与显存占用都更优。
路线三,WebUI:项目本身不带 Web 服务,但官方在 HuggingFace Spaces 部署了 Gradio Demo(RWKV-Gradio-1/2),第三方生态则有 RWKV-Runner 桌面 GUI、web-rwkv 后端、rwkv.cpp 的 CPU 推理方案等。
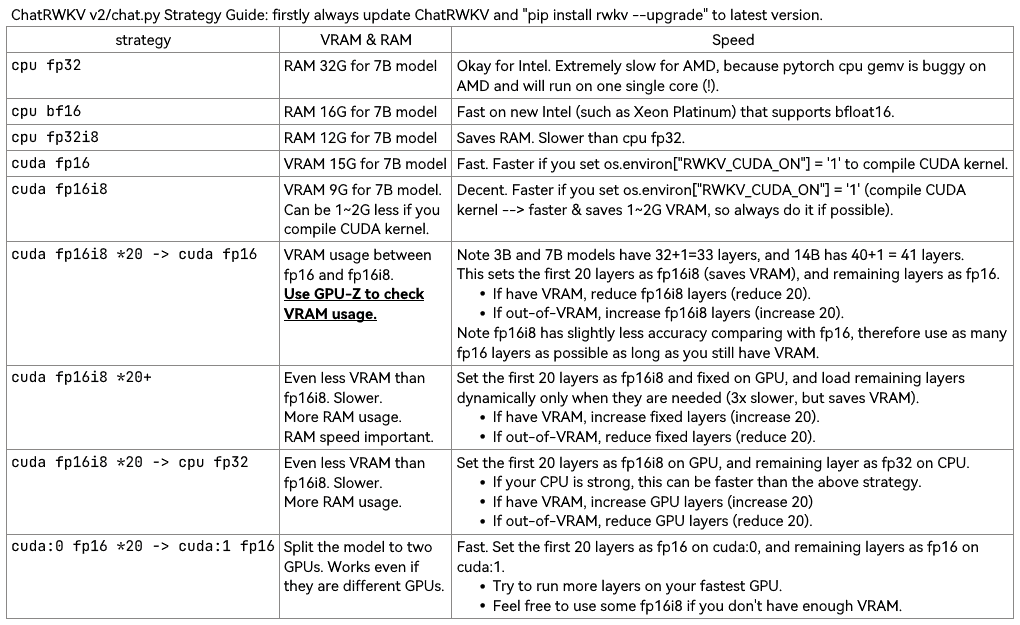
图 4:RWKV 模型的评测表现与多语言能力矩阵
争议一:RNN 是否真的能替代 Attention? 学界长期存在分歧。RWKV-7 的正则语言识别结论是强证据,但工业界主流仍押注 Transformer,生态成熟度、预训练数据规模、推理硬件利用率(vLLM/SGLang 不原生支持)差距明显。
争议二:状态压缩带来的信息损失。 RNN 恒定状态意味着极长上下文中细节会被衰减掉,"大海捞针"式检索任务表现弱于同规模 Transformer。
工程坑点:官方 README 用加粗提醒——不要直接调用裸 forward(),必须把状态与对应文本绑定记录,否则会出现"状态错位"这类极难排查的 bug;v4-raven 用 Bob/Alice 角色前缀,v4/v5/v6-world 用 User/Assistant 提示词格式,混用会导致胡言乱语。
维护节奏:仓库最后推送在 2026 年 7 月,仍有 62 个 open issue。主力开发已转向 RWKV-LM 主仓库、Albatross 高效推理引擎与 RWKV-PEFT 微调工具链,ChatRWKV 事实上已成为"入门示例 + 生态导航"。
ChatRWKV 的历史意义不在于它现在多强,而在于它让"RNN 也能做 LLM"从论文走进工程实践。它带火了整个 RWKV 生态:Albatross(5090 上 7B fp16 达 10250+ tps)、RWKV-Runner、RWKV-PEFT(9GB 显存微调 7B)、rwkv.cpp(ggml 后端的 CPU 推理)、GGUF/Ollama 权重转换,以及国内 RWKV-APP 的移动端落地。
它的架构选择——线性时间、常数空间、无 KV-Cache、无限上下文、训练可并行——至今仍是大模型工程界最有价值的一条技术路线备选。
| 项目 | 结论 |
|---|---|
| 容器化 | 无 Dockerfile / compose,需自行封装 |
| Web UI | 仓库自带 Gradio Demo 在 HF Spaces,本体为 CLI |
| 硬件 | CPU 可跑(rwkv.cpp),GPU 推荐 8GB+;14B INT8 约需 3GB 显存 |
| 依赖 | Python 3.8+、PyTorch、tokenizers、prompt_toolkit;CUDA 需 VS2022 + CUDA 11.7 |
| 许可证 | Apache-2.0 |
