
rag-as-a-service-with-vision
Azure-Samples/rag-as-a-service-with-vision加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下,你给 AI 扔了一份含有产品设计图、财务报表截图的 HTML 文档,问它"第三季度的营收增长了多少?"——传统纯文本 RAG 会直接傻眼,因为关键数据藏在一张截图里。
Azure-Samples/rag-as-a-service-with-vision 正是为了解决这个问题而生的。它是微软官方 Azure Samples 下的一个开源 RAG 框架,核心能力是:让大模型不仅能读文字,还能"看懂"文档里的图片。36 颗 GitHub 星、MIT 协议、100% Python。
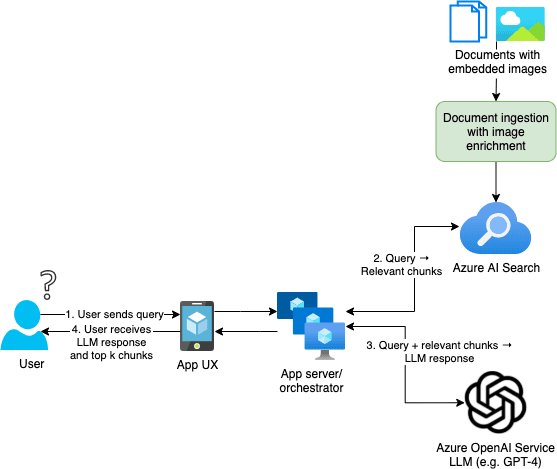
图:RAG Vision 推理流程(来源:项目官方文档)
检索增强生成(Retrieval-Augmented Generation, RAG)自 2020 年被提出以来,已成为企业落地大模型应用的主流架构。传统 RAG 的假设很朴素:文档 = 纯文本,提取文字 → 向量化 → 存储 → 检索 → 生成。
然而现实很骨感。企业文档大量包含:
纯文本提取工具(如 html2text)对这些内容直接返回空白。"garbage in, garbage out"——RAG 质量的上限被输入质量卡死了。
这个项目来自 Azure 官方团队,目标是为企业级 MHTML 文档(网页存档格式)构建一套完整的多模态 RAG 方案,不仅能提取文本,还能理解图像语义并纳入检索上下文。
如果说传统 RAG 是让 AI "读书",那么 Vision RAG 就是在让它"读图鉴"。
传统 RAG → 搜索引擎:输入文字,输出相关文字片段。
Vision RAG → 带图鉴的百科全书:输入问题,系统不仅找文字,还找相关图片,并对图片进行理解后作为上下文交给 LLM。
项目的 Pipeline 分三个阶段:
1. Ingestion(文档摄入):MHTML 文档 → 解析文本 + 图片 → 向量化存储至 Azure AI Search
2. Enrichment(图片增强):用图像分类器筛除无关图片(如 Logo、水印),对有价值图片调用 GPT-4o 多模态能力生成文字描述,并缓存结果
3. Inference(推理):用户提问 → 文本向量检索 + 图像向量检索 → 合并上下文 → GPT-4o 生成答案
GPT-4o 调用按 token 计费,文档中每张图片都调用大模型会产生天价账单。项目内置图像分类器,先判断图片是否值得增强(排除 Logo、背景图、水印等),只有高价值图片才走 GPT-4o 描述生成流程。
相同图片重复处理是浪费。Enrichment 结果会存入 Azure Cosmos DB 缓存,同样的图片第二次出现时直接读缓存,延迟和成本双降。
项目提供了两套评估方法:
评估服务充当"用户代理",批量跑 QA 数据集,记录指标,支持团队持续迭代 Pipeline 配置。
| 层级 | 技术选型 | 作用 |
|---|---|---|
| API 框架 | FastAPI + Uvicorn | 高性能异步 REST API,Swagger 自动文档 |
| RAG 框架 | LangChain 0.3.x | 链式编排、向量检索、LLM 调用抽象 |
| 向量数据库 | Azure AI Search | 企业级全文 + 向量混合检索 |
| 文档存储 | Azure Cosmos DB | 结构化文档 + 缓存 |
| 多模态 LLM | GPT-4o (Azure OpenAI) | 图像理解 + 文本生成 |
| 图像分类 | Azure Computer Vision | 图像内容分类 |
| 部署方式 | Terraform | Azure 基础设施即代码 |
| 评估框架 | ROUGE + LangChain Evaluators | 量化 RAG 质量 |
核心依赖一览(src/api/requirements.txt):
fastapi==0.115.4
langchain==0.3.27
langchain-community==0.3.27
openai==2.7.1
azure-search-documents==11.6.0
azure-cosmos==4.9.0
azure-ai-vision-imageanalysis==1.0.0
API 层很友好:项目提供完整的 FastAPI 实现,启动后访问 /docs 即可看到 Swagger UI,可视化调试所有端点(上传文档、搜索、聊天、媒体增强)。这一层对开发者非常友好。
环境配置有门槛:需要申请和配置 6 个 Azure 服务(OpenAI、Search、Cosmos DB、Computer Vision 等),.env 文件需要填写 10+ 个密钥和端点。官方推荐使用 VS Code devcontainer 降低环境复杂度。
本地运行:
cd src/api
python -m venv venv && source venv/bin/activate
pip install -r requirements.txt
cp configs/sample.env configs/.env  # 手动配置 Azure 凭据
python -m main
# 访问 http://localhost:8080/docs
生产部署:通过 deploy/main.tf Terraform 脚本一键创建 Azure 基础设施(资源组、Cosmos DB、AI Search、Computer Vision 等),然后 az webapp up 部署 API 代码。
强依赖 Azure 生态:项目对 Azure 服务深度绑定,不支持替换为其他云或本地方案。如果团队不在 Azure 上,维护成本较高。
仅支持 MHTML 格式:文档摄入专为 MHTML 设计,处理 PDF、Word 等格式需要额外适配。
Stars 较低(36):作为微软官方示例项目,星标数相对有限,可能因为它是"示例代码"而非"通用工具",定位偏向参考实现而非可直接复用的库。
缺少离线模式:无法在没有 Azure OpenAI 的情况下本地运行 LLM 推理。
多模态 RAG 是 RAG 演进的下一个重要方向。随着 GPT-4o、Gemini 等多模态模型的能力提升和价格下降,"文图混合检索"将从尝鲜技术变成企业文档智能的标配。
这个项目的价值在于:它展示了将多模态能力引入企业 RAG 系统的完整路径——从文档解析、图像分类、智能增强,到混合检索、结果评估,每个环节都有可参考的实现。
对于正在构建企业知识库、需要处理含大量截图/图表的文档的团队,这是一个值得研究的技术参考。
| 项目 | 内容 |
|---|---|
| Stars | 36 |
| 语言 | Python 3.11 |
| 许可 | MIT |
| 主分支 | main |
| Web UI | FastAPI + Swagger (/docs) |
| 容器化 | 不支持 |
| 快速部署 | 部分支持(Terraform IaC + 手动 API 部署) |
| 评估框架 | ROUGE + LLM-as-Judge |
| 多模态模型 | GPT-4o (Azure OpenAI) |
| 相关标签 | rag gpt-4o azure-ai-search azure-ai-vision vision |
