
DeepResearch
Alibaba-NLP/DeepResearch加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
当你需要写一份行业调研报告时,传统的做法是:打开搜索引擎,输入关键词,浏览数十个网页,复制粘贴信息,再手动整合——整个过程可能耗费数小时甚至数天。而 通义深度研究智能体(DeepResearch) 想要改变这一切:给它一个研究主题,它能像一位专业研究员一样,自主规划搜索路径、抓取关键信息、交叉验证多个来源,最终输出一份结构化的研究报告。
这是阿里巴巴 NLP 团队在 2024-2025 年开源的一个重要项目,凭借其 20,000+ GitHub Stars 的高热度,迅速成为开源 AI Agent 领域的标杆案例之一。
阿里巴巴的大语言模型之路走得相当扎实。从早期的 Qwen(通义千问) 系列模型,到 2024 年底发布的 Qwen2.5-72B-Instruct,阿里 NLP 团队持续在开源社区输出高质量模型。而 DeepResearch 则代表了他们从"模型能力"向"应用智能"的延伸——不再只是生成文本,而是解决真实的信息处理问题。
该项目的技术报告(arXiv:2510.24701)详细描述了系统架构与评测基准。阿里选择在这个时间点开源,一方面是回应 OpenAI Deep Research 带来的行业热度,另一方面也想展示其在中文信息理解与检索方面的差异化优势。
DeepResearch 并非一个简单的脚本,而是一套精心设计的 多智能体(Multi-Agent)协作系统。从代码结构来看,系统分为三大核心模块:
AgentFounder 是整个系统的核心调度器,负责接收用户的研究主题,将其分解为可执行的研究子任务,并协调下游各子 Agent 执行。AgentScaler 则提供了并行扩展能力,可以同时运行多个研究线程,显著加速大规模研究场景的完成速度。
这一层的关键在于"任务规划"能力:AI 需要判断一个复杂研究主题需要哪些步骤、如何排序、先搜索什么后验证什么——这比单纯回答问题要复杂得多。
项目包含 15 个专业 WebAgent,涵盖互联网信息获取的各个环节:
这些子 Agent 各自专注于特定的信息获取任务,通过协作完成从"发现问题"到"获取证据"的完整链条。
inference/ 目录包含核心推理逻辑,其中 react_agent.py 是整个系统的推理驱动模块。它基于 ReAct(Reasoning + Acting) 范式,让模型在推理过程中交替进行"思考"和"行动",每个行动可以调用搜索工具、访问网页或调用其他工具,逐步构建完整的研究路径。

DeepResearch 的技术选型非常务实:
| 组件 | 技术选型 | 说明 |
|---|---|---|
| 基础模型 | Qwen2.5-72B-Instruct | 通义千问系列主力模型 |
| Agent 框架 | Qwen-Agent 0.0.26 | 阿里自研的 Agent 开发框架 |
| 推理框架 | vLLM / SGLang | 高吞吐量 LLM 推理 |
| 搜索增强 | 多源 API(通义搜索、DuckDuckGo) | 联网搜索能力 |
| 部署方式 | HuggingFace / ModelScope | 提供在线 Demo |
整个系统依赖 dashscope(阿里云 DashScope API 服务)进行模型调用,同时支持 OpenAI 兼容接口,方便接入不同的 LLM 后端。
requirements.txt 中包含了大量依赖:fastapi(Web 服务)、ray(分布式计算)、openai(接口兼容)、pandas(数据处理)等,整体构建了一个功能完整的研究智能体运行环境。
不需要任何配置,直接体验完整功能:
这两个在线 Demo 提供了完整的交互界面,可以直接输入研究主题,等待 AI 完成深度研究和报告生成。
# 1. 克隆项目
git clone https://github.com/Alibaba-NLP/DeepResearch.git
cd DeepResearch

# 2. 配置环境变量
cp .env.example .env
# 编辑 .env 填入 DASHSCOPE_API_KEY(通义千问 API Key)

# 3. 安装依赖
pip install -r requirements.txt

# 4. 运行推理示例
cd inference
bash run_react_infer.sh
本地部署需要准备的资源:
| 场景 | CPU | 内存 | 显卡 | 存储 |
|---|---|---|---|---|
| 纯 API 调用 | 4核 | 8GB | 无需 | 10GB |
| 本地模型推理 | 8核 | 32GB | RTX 3090 / A100 | 50GB |
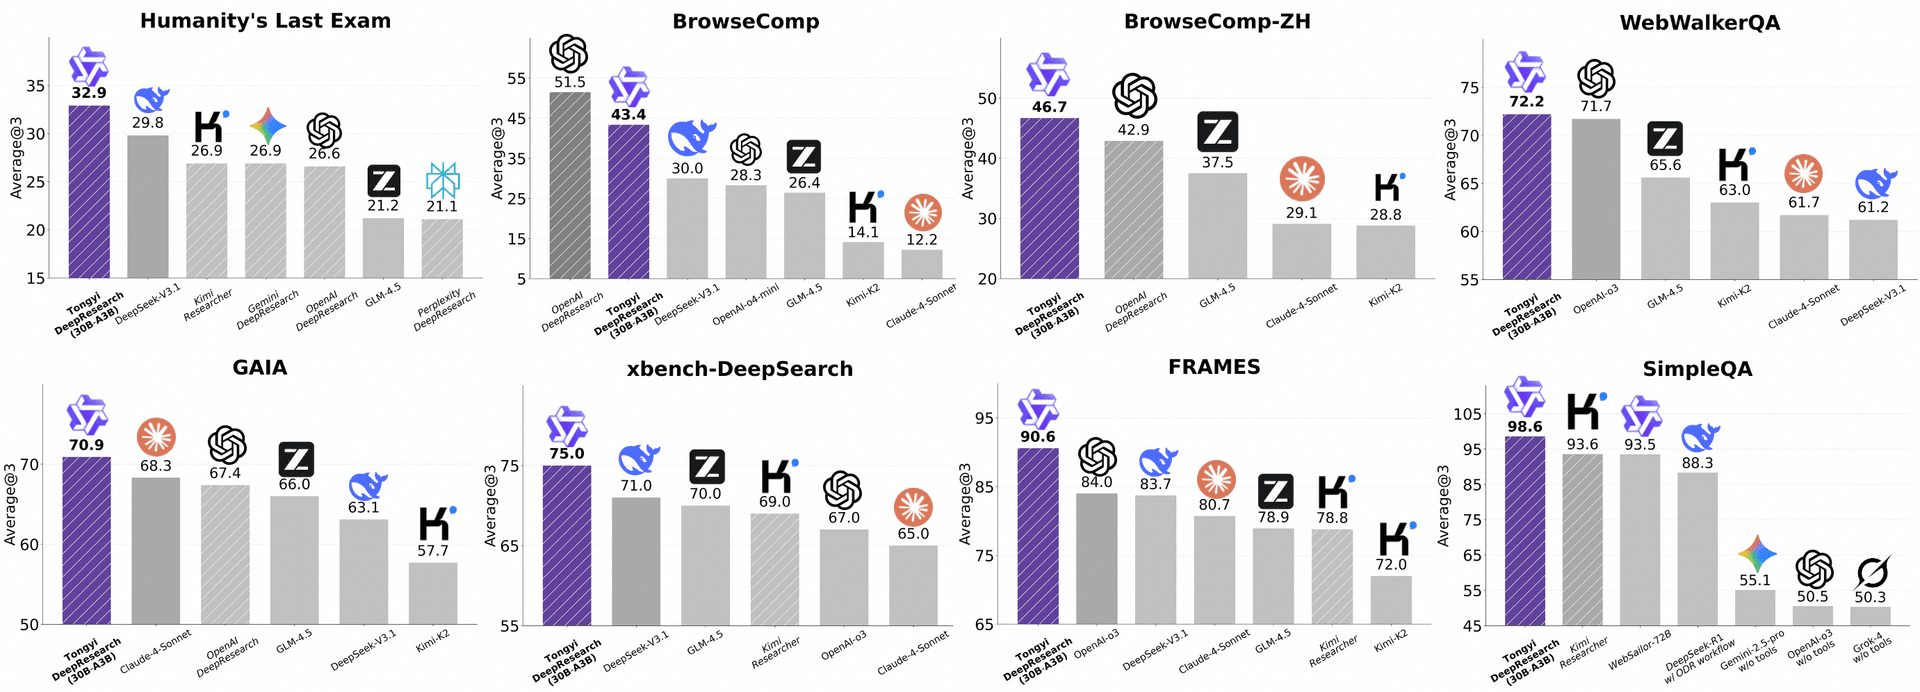
项目在多个 benchmark 上进行了评测:
阿里声称其在多项指标上超越 GPT-4o 和其他同类竞品。由于评测基准和评测条件的差异,这些对比数据需要结合具体测试环境来看待——但无论如何,DeepResearch 在中文信息理解和复杂推理任务上的表现是值得关注的。
冷静看待,DeepResearch 也存在一些局限:
API 依赖:核心功能依赖通义千问 API,不购买额度则无法使用本地模型模式,这限制了其在隐私敏感场景的应用。
幻觉问题:和其他 LLM 一样,DeepResearch 可能在信息整合过程中产生"幻觉"——即将不相关的信息错误地关联在一起,这是严肃研究场景中需要警惕的风险。
长程推理成本:深度研究涉及多轮搜索和推理,每次研究任务的 token 消耗相当可观,实际使用成本不可忽视。
中文互联网覆盖:虽然在中文信息处理上有优势,但涉及特定垂直领域(法律、医疗、金融)时,专业信息的准确性和时效性仍需人工核实。
DeepResearch 的开源至少有三层意义:
对开发者:提供了一套完整的 AI Agent 工程实践参考,包含任务规划、多 Agent 协作、工具调用、评测体系等完整模块,是学习 Agent 开发的优质范本。
对研究者:技术报告和评测基准为"深度研究"这一新任务类型提供了可量化的评估标准,有助于推动该领域的学术进展。
对用户:HuggingFace 和 ModelScope 上的在线 Demo 大幅降低了体验门槛,让非技术用户也能感受 AI 研究助手的能力。
通义深度研究智能体(DeepResearch) 代表了阿里 NLP 团队在 AI Agent 领域的一次重要尝试。它将大模型能力与信息检索技术深度结合,构建了一套可自主完成复杂研究任务的智能体系统。虽然在容器化和本地化部署方面还有提升空间,但其提供的在线 Demo 已足够让普通用户体验"AI 研究助手"的魅力。
对于想深入了解 AI Agent 架构的开发者,这套代码值得细读;对于有信息处理需求的从业者,在线 Demo 是值得一试的工具。开源社区的持续活跃,也让这个项目的未来演进值得期待。
