
claude-seo
AgriciDaniel/claude-seo加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个典型的 SEO 服务公司:五家客户站点,每家都签了季度深度审计合同。每季度一次,人工爬站、比对 Schema、翻 Google 文档查最新规则、拼一份 40 页 PDF——三个人做一周,报价八万。
现在换个方式:周二早上把 /seo audit https://client-site.com 敲进 Claude Code,几分钟内,17 个专职子代理同时开工——一个查抓取与索引,一个评 E-E-A-T,一个校验 JSON-LD,一个盯 Core Web Vitals,一个测 AI 搜索可引用性,一个做 hreflang 国际化审计,一个扫描内容漂移。跑完你拿到的不是一堆"建议",而是一份带 0-100 分、带优先级排序、每条建议都附带"我们怎么知道这失败了"的检验条件的行动计划。
这就是 Claude SEO(AgriciDaniel/claude-seo)——截至 2026 年 10 月,它在 GitHub 上有 19,502 星、2,836 fork、28 位贡献者,是 Claude Code 生态里星数最高的 SEO 技能包,也是整个"技能(Skill)"形态从个人玩具走向专业生产工具的标志性案例。
作者 Daniel Agrici 本身是 Rankenstein 联合创始人,团队做的是 AI 驱动的 SEO 平台。他把这个生产系统里的方法论抽出来,做成了开源的 Claude Code 插件。这个起点决定了两件事:一是规则更新速度极快,README 里明确写着跟随 Google 2026 年 9 月的垃圾内容更新、"FAQ 富结果已于 2026-05-07 全面下线"、"INP 早在 2024-03-12 就替换了 FID";二是商业化路径清晰——公开版 MIT 免费,付费的 AI Marketing Hub Pro 社区提供私有镜像、抢先版本和直接协作渠道,README 里连"两个版本怎么选"都用 > 引用块单独写明。
技术底座是 Anthropic 官方的 Claude Code 插件规范:一个主 orchestrator 技能(skills/seo)做自动发现与并行派发,下面挂 26 个子技能(22 个核心 + 1 个编排器 + 1 个框架集成 + 2 个扩展镜像)和 19 个专职子代理(16 核心 + 3 集成/镜像),再加上 60 个 Python 脚本和 80 个测试文件。版本迭代到 v2.4.2(2026 年 10 月),CHANGELOG 里逐条记录了 SSRF 绕过修复、缓存路径穿越修复、RFC 6598 段拒绝、secret-scan CI 门禁等安全加固——这在个人主导的开源项目里相当罕见。
如果 Claude Code 是一间律所的办公室,那 Claude SEO 就是一个已经配齐了分析师组的律师团队:
/seo audit 相当于立案审查——召集全员做一次全面体检,输出分级报告;/seo schema 是技术鉴证科——专门拆解 JSON-LD、验证 Schema.org 类型、生成缺失标记;/seo geo 是新渠道公关部——专门研究网站在 AI Overviews、Gemini、Perplexity 里能不能被引用;/seo agentic 是新业务评估科——按 Lighthouse 13.2.0 新增的 Agentic Browsing 分类打分,检查 llms.txt、Markdown 交付、WebMCP、ai-catalog.json;/seo drift 是哨兵——用 SQLite 存基线快照,网站悄悄改版、标题被改掉,能告诉你哪里退化了;/seo maps 是本地组——geo-grid 铺点、GBP 档案审计、评论健康度、竞品半径测绘。而 /seo flow(FLOW 框架,41 个提示词,CC BY 4.0)像是这个团队的方法论手册;seo-cockpit(v2.4.2 新增,需 Claude Code 2.1.287+)则像财务总监——在调用 DataForSEO、Ahrefs 这类付费 API 之前先查预算,超额就拦截,还会把当天花费记进账本,甚至在 Claude Code 侧栏拉出一块面板显示 Search Console、排名、Core Web Vitals 和审计结果。
并行调度是真并行。 /seo audit 最多同时拉起 17 个子代理,各自有独立上下文和工具集,这是把"三天的活压进十分钟"的结构性原因。
规则是"可证伪"的,而不是"听起来专业"的。 这是这个项目最值得学的地方。每条建议都必须携带四件套:一阶观察依据(它站在什么第一性原理上)、依赖关系(必须先做哪条)、失败检验("我们怎么知道这条没生效")、领先指标(该盯哪个数)。作者把这套方法论写在 skills/seo/references/thinking-framework.md 里,分成 PERCEIVE(观察/倾听)、ANALYZE(第一性归约/横向连接/系统连接)、VALIDATE(UX 与产能压测)、ACT(交付与反馈环)四阶段。
安全是被认真对待的。 v2.2.6 修掉了缓存路径穿越和 WHOIS 引荐 SSRF,v2.3.0 加了 CLAUDE_SEO_LOCAL_TARGETS 白名单与代理校验,依赖版本全线抬高到 CVE 修复水位以上,CI 里有 secret-scan 门禁和 pip-audit。
渲染层是真渲染。 60 个 Python 脚本里,--render auto 会检测空的 <div id="root"> 外壳并自动切到 Playwright,用 trafilatura 做无样板内容抽取,配合 Playwright 1.62+ 和 requests/urllib3 的安全下限。Core Web Vitals 走 LCP/INP/CLS 三件套,LCP 还能拆成 TTFB、加载延迟、加载时长、渲染延迟四个子项定位瓶颈,实验室数据(PSI/Lighthouse)和真实用户数据(CrUX)分开处理。
架构上还有一条"私域镜像"路径。 README 写明 /plugin marketplace add 后 /seo setup 会在 Claude 的插件数据目录里创建隔离 Python 环境并装 Playwright Chromium,不污染全局 Python 环境,也不创建 PATH shim——这是把"能装上"和"能长期维护"分开处理的做法。
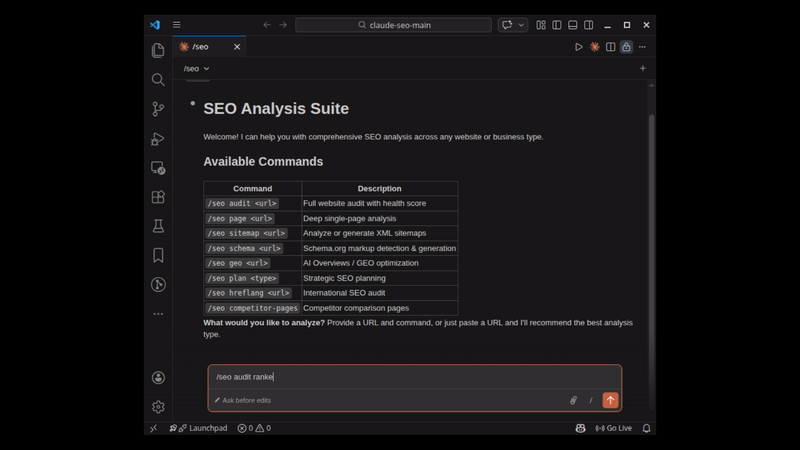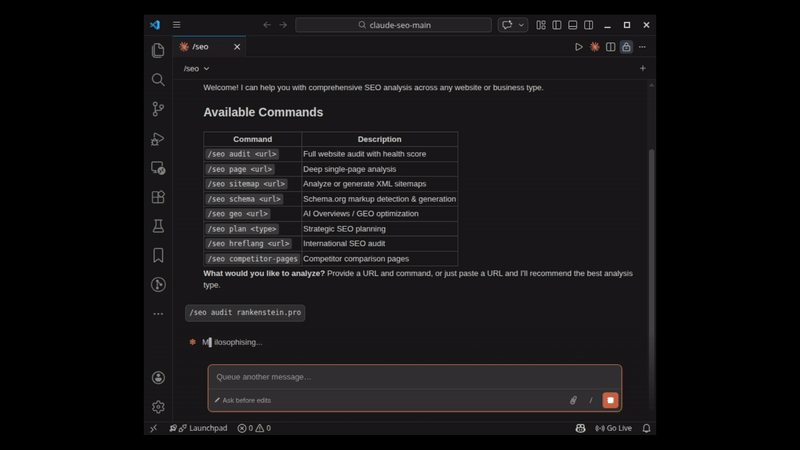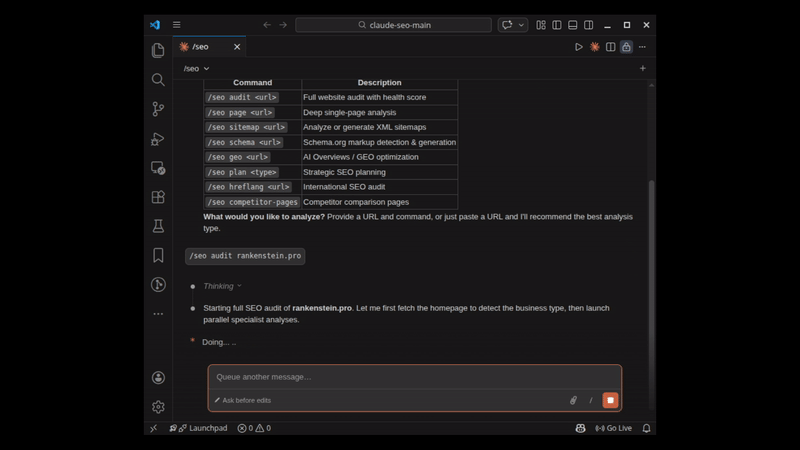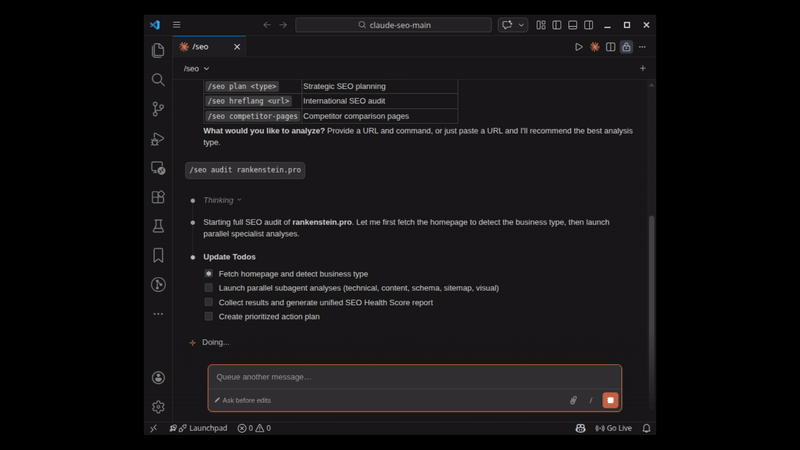
并行子代理扇出审计的实机演示。
这是必须讲清楚的一点:Claude SEO 不是一个 Web 应用,没有 Web UI,没有 Docker 部署脚本(仓库里没有 Dockerfile、没有 docker-compose.yml、没有 k8s 目录)。它是一个跑在 Claude Code CLI 里的插件。
安装路径有三条,按难度递增:
/plugin marketplace add AgriciDaniel/claude-seo → /plugin install claude-seo@agricidaniel-claude-seo → /seo setup,/seo doctor 检查就绪状态;git clone --depth 1 后 bash claude-seo/install.sh(Unix/macOS/Linux),另有 install.ps1 供 Windows 使用;bash claude-seo/uninstall.sh 或 curl -fsSL .../uninstall.sh | bash。前置条件只有 Python 3.10+(作者提示 3.10 将于 2026-10 结束生命周期,建议 3.11+)和 Claude Code CLI,Playwright Chromium 与 Google API 凭据均为可选。需要提前知道的成本项:v2.3.1 起,5 个判断密集型代理(seo-content、seo-geo、seo-sxo、seo-cluster、seo-drift)跑在 Opus 上,其余 13 个跑 Sonnet,所以一次全站审计的 token 花费明显高于 v2.3.0。想省钱就去改 agents/ 下对应 frontmatter 的 model: 行。
对有技术背景的团队,这套东西的上手成本其实很低:本质是"把一份巨型 SOP 拆成可被 AI 调用的结构化文档 + 一批可执行脚本"。难点不在安装,在于你得先有 Claude Code 的订阅额度——这是唯一的硬门槛。
第一,AI 生成内容的合规灰区。 项目自己承认 Google 允许满足 Search Essentials 的生成式 AI 内容,问题在于"用 AI 批量堆低价值页面"就跨进了 spam。作者的对策是 seo-content humanize 和 seo-content verify 两个命令主动检测,但这类检测的准确率天然有限。
第二,重客户端渲染的时序噪声。 README 的 Limitations 章节直接写明:滚动位置绑定水合、交互后才拉取关键内容、第三方组件竞态挂载这三类页面仍会产生噪声级误报,官方推荐的做法是手动触发 seo-visual 子代理,把 Playwright 快照和原始 HTML 分析的结果人工比对。这说明它的自动化率很高,但 100% 自动化尚未达成。
第三,不配凭据就是"本地估算"。 免费层不调任何第三方 API,Core Web Vitals 只有实验室估算,索引状态是从页面级信号推断的。要拿到真实字段数据和实时索引状态,得配 Google API 凭据(Tier 0-3);要拿竞品数据和 AI 引用数据,就得开 DataForSEO、Ahrefs、SE Ranking、Profound、Firecrawl 等 9 个可选扩展中的若干个。免费能跑,但免费跑出来的报告是"半个真相"。
第四,双轨商业模式的信任问题。 公开版与付费社区版并存,README 用引用块专门说明差异。虽然 MIT 许可和源码完整可见、且承诺了"公开版本无功能阉割",但作者本人也是作者榜单的评委("most-starred Claude Code skill in existence, and yes, I built it. (Bias disclosed. Moving on.)"),这种自证式背书本身带着立场。另外 41 个 open issues 悬而未决,对一个 19.5k 星的项目来说,issue 响应速度是需要观察的信号。
还有一条不容忽视的依赖风险:整个价值链建立在 Claude Code 的插件规范之上。虽然项目兼容 Codex(作者另有 codex-seo 移植版),但主战场绑在 Anthropic 生态上——如果插件规范或模型计费策略发生大改,这个项目的迁移成本会立刻显现。
把 Claude SEO 放进行业坐标系里看,它标记了三件事:
其一,Skill 正在替代 SaaS。 过去做一次全站 SEO 审计,你买 Ahrefs + Screaming Frog + 一个顾问;现在你订阅 Claude Code,装一个 MIT 插件,拿到的是能对话、能追问、能按你业务类型定制策略的审计引擎。19.5k 星不是"某个 Python 库受欢迎",而是开发者在用脚投票表态"技能包可以替代付费工具链"。
其二,"活文档"正在成为知识交付的新形态。 这个项目最核心的资产其实是它那套 data/google-updates.json 和不断修订的技能正文——当 Google 改了规则,技能跟着改,并给出变更日志和回归测试。知识库不再是一次性交付的文档,而是可执行、可验证、随时间自我维护的活体。 从 v2.1.0 到 v2.4.2 的十一次更新里,有相当一部分内容是"重新核对事实并标注第三方声称"——这恰恰是 LLM 应用最容易出错、也最需要工程化约束的地方。
其三,AI 搜索优化(GEO/AEO)已经从概念期进入工具期。 /seo geo、问题式可引用性评分、/seo agentic 按 Lighthouse Agentic Browsing 分类打分、检查 llms.txt 与 WebMCP——这些不是概念演示,而是可运行的检查项。当搜索引擎本身开始被 AI 代理读取,"让网站对 AI 可读"就成了一项可工程化的运维指标。 这个方向在未来两年大概率会从独立品类并入传统 SEO 工具链。
最后看增长曲线。作者自己站点 claude-seo.md 的 GSC 数据:3 个月内 2.82K 点击、107K 曝光、2.6% CTR、平均位置 22.6——作者明确写道"多数域名在这个年龄还在 Google 沙盒里"。
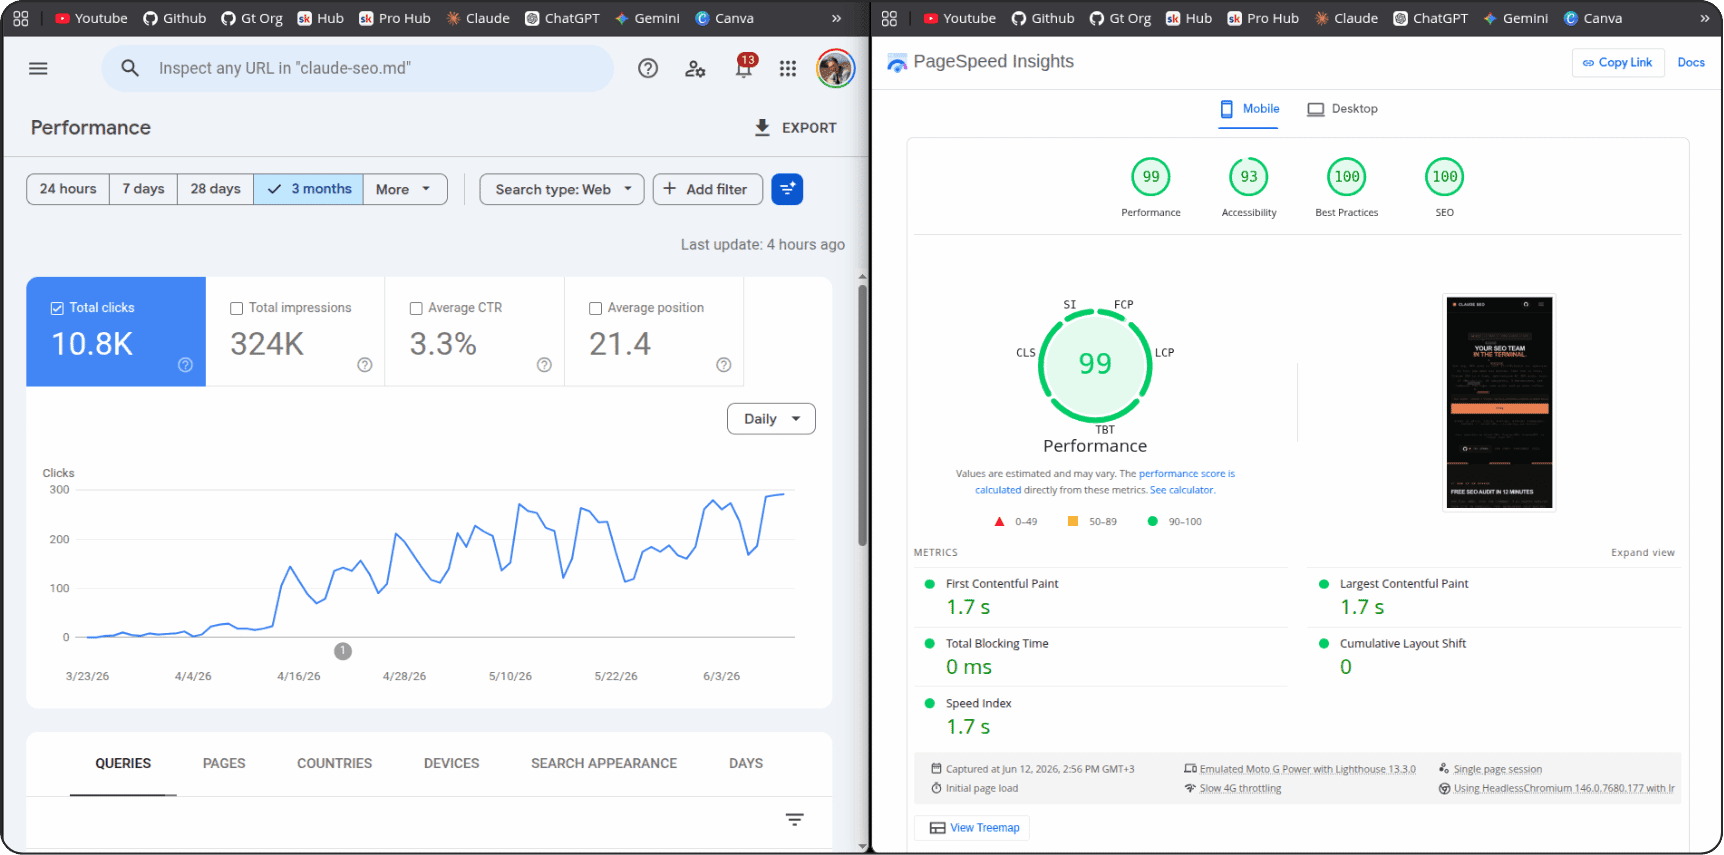
项目自述的三个月自然增长曲线。
总结判断:Claude SEO 不是一个完美的工具——它有渲染时序噪声、有免费层数据缺口、有作者立场瑕疵、有 41 个未关闭的 issue。但它用 19.5k 星证明了"把专业领域知识结构化为 AI 可调用的技能包"这条路径在 2026 年是走得通的,而且正在从 SEO 蔓延到内容写作(claude-blog)、图片生成(banana-claude)、甚至跨平台移植(codex-seo)。如果你的团队正在为周期性专业审计付费,这套 MIT 插件值得花一小时试一遍;如果你的团队正在考虑把某个专业流程产品化,Claude SEO 本身就是最好的架构参考样本。
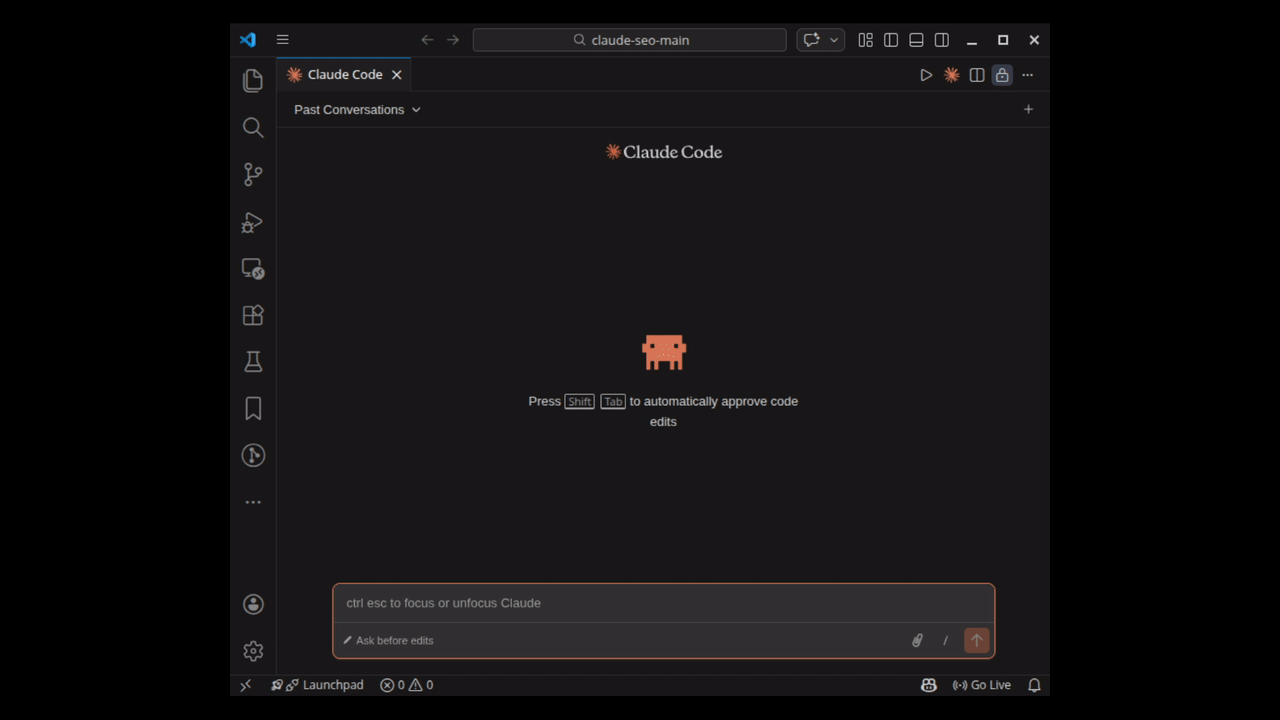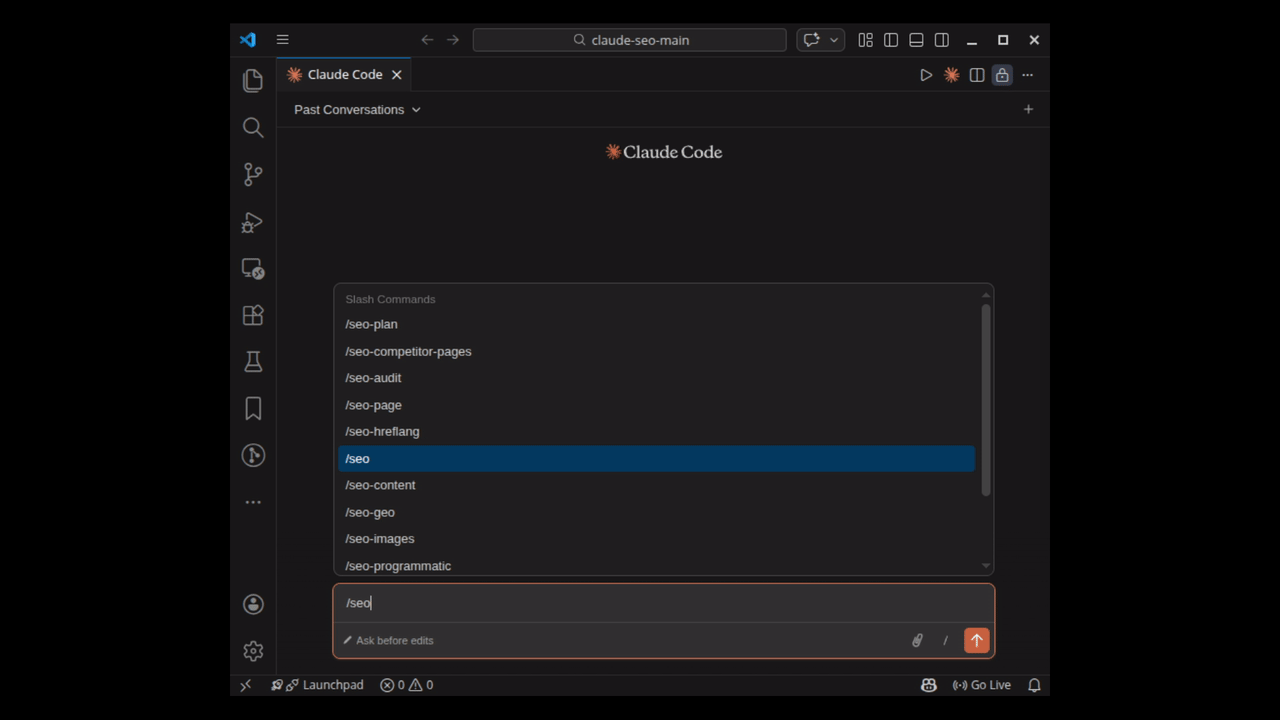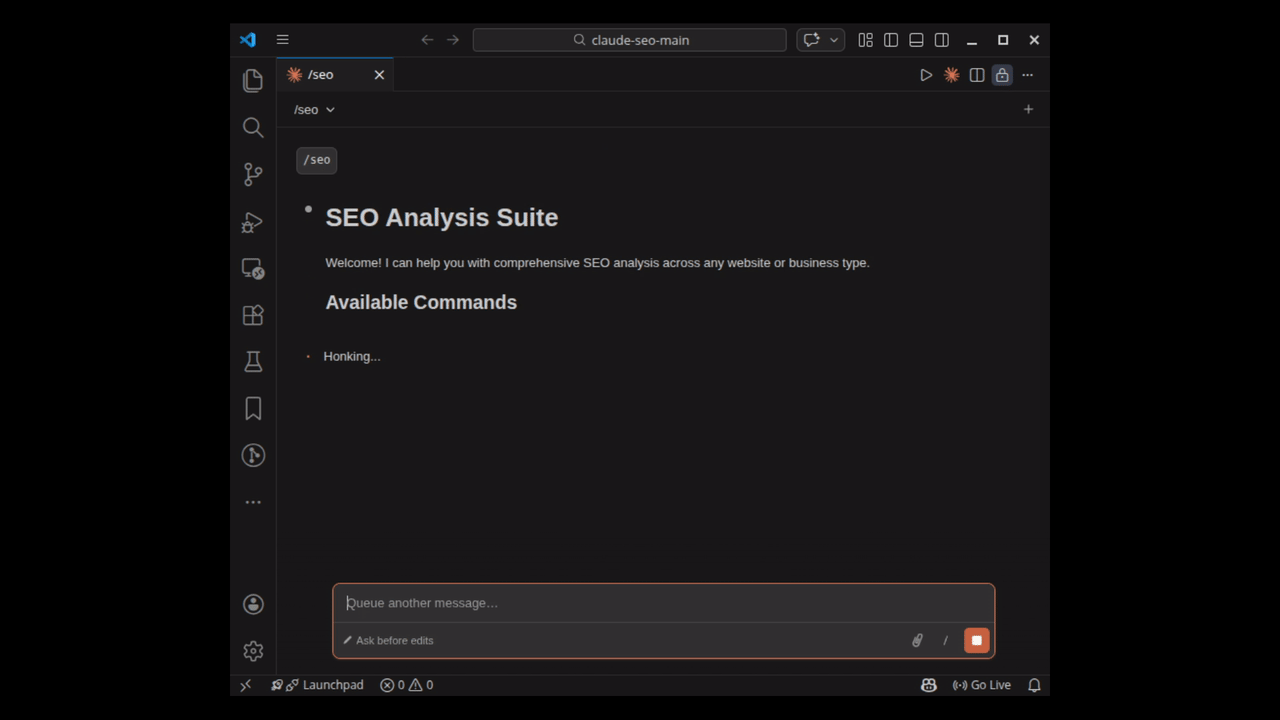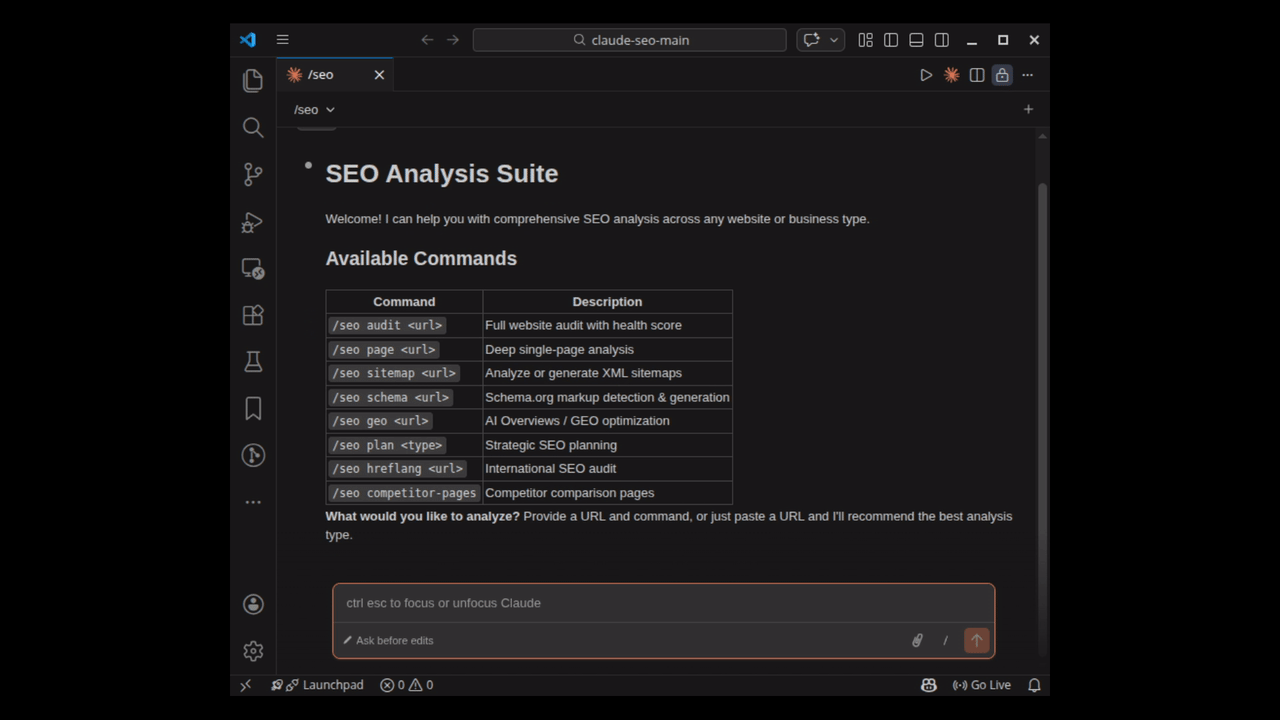
/seo 命令族的实机调用演示。
