
VoLN-UAV
Admire-ljb/VoLN-UAV加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你站在一片陌生的荒野中,手里没有任何地图,只有一副眼镜,要求你在数百米外找到一个指定的标志物——这正是无人机在 VoLN-UAV 任务中面临的挑战。VoLN(Vision-Only Long-Horizon Navigation)由华东师范大学研究团队提出,旨在解决一个核心难题:仅凭机载 RGB 相机,不依赖 GPS、SLAM 或深度传感器,让无人机在长距离、多阶段的导航任务中找到目标。
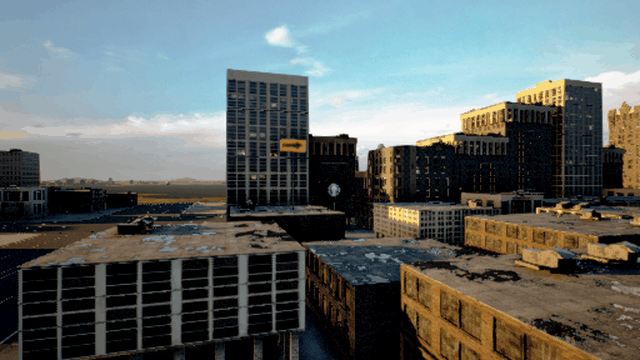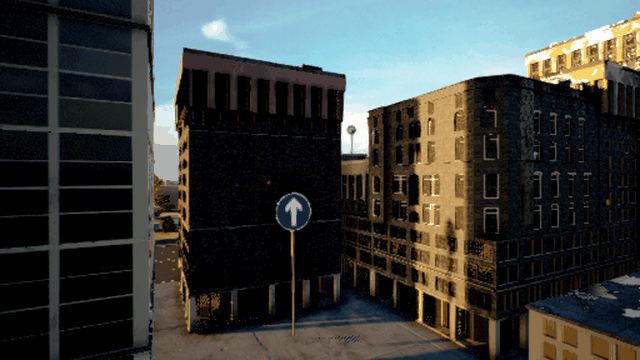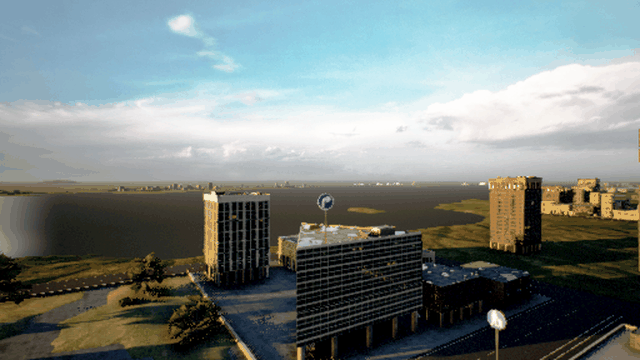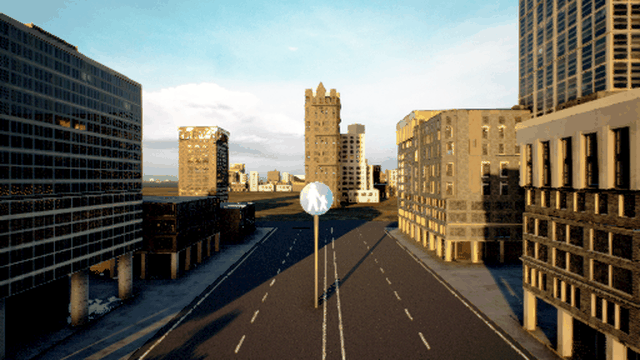
图 1:AirSim 仿真环境下的第一人称视角导航演示
传统无人机导航高度依赖 GPS 定位或激光雷达(LiDAR)+ SLAM 建图。然而在室内、密林、城市峡谷、地下隧道等场景中,GPS 信号被遮挡或严重衰减,LiDAR 成本高昂(工业级产品通常数千至上万美元),且在远距离目标检测上精度受限。纯视觉方案不仅硬件成本低一个数量级,更具备泛化到未知环境的潜力——人类飞行员正是靠眼睛完成绝大多数飞行任务的。
VoLN-UAV 瞄准的是**长时域(Long-Horizon)**导航:目标不再只是"往前走 5 米",而是"飞越 450 米以上的复杂地形,找到特定地点"。这种任务要求模型理解三维空间关系、记忆历史轨迹、主动选择导航策略,远超简单避障的复杂度。
图 2:真实无人机飞行场景中的第一视角,VoLN 已完成从仿真到物理世界的迁移
VoLN-MLLM 是该工作的核心模型,采用两阶段训练范式,巧妙结合了多种预训练视觉和语言模型的能力:
第一阶段:视觉—语义对齐(Visual-Semantic Alignment)
研究团队没有从头训练视觉编码器,而是利用了冻结的 DINOv3 ViT-B/16 提取高质量但语义稀疏的底层视觉特征,再用轻量适配器通过余弦蒸馏将这些特征映射到 CLIP ViT-B/16 的语义空间。为什么要这样做?DINOv3 的特征保留了精细的空间结构但缺乏语义标签,而 CLIP 特征语义丰富但丢失了精确位置信息——两者的结合让模型同时"看得清"和"看得懂"。
第二阶段:轨迹规划(Trajectory Planning)
对齐后的视觉特征与 冻结的 Vicuna-7B-v1.5 大语言模型相连,输入包括:当前观测历史序列、3 张终点目标图像、机体系状态(位置、姿态)以及从语义库动态检索的 Top-8 类别 token。模型输出 8 个三维相对 waypoint(相对于机体的方向与距离) 加上一个停止信号,驱动无人机逐步逼近目标。
关键设计:采用 Rank-16 LoRA 适配 Vicuna 的注意力层和前馈层,只训练极少量参数即可实现有效微调,大幅降低了训练成本。
该工作的另一重要贡献是发布了 VoLN-UAV Benchmark,这是目前最完整的空中视觉-语言导航数据集:
| 指标 | 数值 |
|---|---|
| 总 Episodes | 7,210 |
| 训练集 | 5,047(70%) |
| 验证集(Seen) | 1,082(15%) |
| 测试集(Unseen) | 1,081(15%) |
| 场景类型 | 沙漠、森林、山地、城市峡谷、夜间城区、校园、隧道、工业走廊 |
| 仿真平台 | Microsoft AirSim + Unreal Engine |
任务难度按参考轨迹长度划分为三级:Easy(<300m)、Normal(300-450m)、Hard(≥450m)。评估指标涵盖 NE(导航误差)、SR(成功率)、OSR(进入成功率)、nDTW(动态时间规整)、SPL(路径效率)等。
在 Test-Unseen(最具挑战性的未见场景)上,VoLN-MLLM 相比基线方法提升显著:
| 方法 | SR↑ | OSR↑ | NE↓ | SPL↑ |
|---|---|---|---|---|
| Seq2Seq-VG | 2.3 | 6.4 | 206.7 | 0.4 |
| CMA-VG | 7.4 | 14.6 | 176.8 | 1.8 |
| LAG-VG | 28.1 | — | — | — |
| VoLN-MLLM | 53.1 | — | — | — |
VoLN-MLLM 在 Hard 难度下的成功率相比最佳基线提升了近一倍,证明了基于多模态大语言模型的规划策略在空中长程导航任务中的显著优势。
消融实验也验证了各组件的必要性:移除视觉-语义对齐(No-Align)导致成功率大幅下降;移除 LoRA 适配(No-LoRA)同样性能骤降;而用原始 CLIP 特征直接输入(CLIP-Input)效果最差,说明两阶段训练范式是性能的关键来源。
前置依赖:
安装步骤:
conda create -n voln-uav python=3.10 -y
conda activate voln-uav
pip install -e .
数据集(7,210 episodes)和仿真环境需从 HuggingFace 单独下载:
Louj/VoLN-UAV-datasetLouj/VoLN-UAV-ENV核心训练/评估命令:
# 视觉适配器训练
voln-uav-train-adapter configs/train_adapter_dataset_release.yaml

# 规划器训练
voln-uav-train-planner configs/train_planner_dataset_release.yaml

# AirSim 闭环评估(需先启动 AirSim)
voln-uav-eval-airsim configs/eval_airsim_dataset_release.yaml

# 离线评估(无需 AirSim,可直接运行)
voln-uav-eval-offline configs/eval_offline_dataset_release.yaml
所有脚本均通过 pyproject.toml 定义的命令行入口调用,结构清晰。代码库还提供了消融实验自动化脚本、基准协议审计工具以及实验结果编译脚本。
VoLN-UAV 的代码库采用模块化设计,核心模块包括:
models/encoders.py — DINOv3、CLIP 视觉编码器封装models/adapter.py — 视觉-语义对齐适配器(余弦蒸馏)models/planner.py — Vicuna-7B-v1.5 规划器 + LoRAmodels/semantic_bank.py — 语义类别库管理training/ — 适配器和规划器的训练循环benchmark/ — 评估指标计算(NE、SR、OSR、SPL、nDTW、CT、EER)simulators/airsim_plugin/ — AirSim 接口封装baselines/ — Seq2Seq-VG、CMA-VG、LAG-VG 基线实现技术栈:
代码质量方面,项目提供了完整的 YAML 配置文件系统、模块化模型工厂(planner_factory.py)、CLI 入口和基准协议审计工具。文档包含详细的实验协议说明,但缺少单元测试目录(tests/ 目录存在但内容有限)。
尽管 VoLN-UAV 在技术上取得突破,仍有几个现实问题值得关注:
VoLN-UAV 将 Vision-Language Navigation(VLN) 领域的研究边界从地面机器人扩展到了空中平台,是具身人工智能(Embodied AI)在无人机领域的重要一步。其提出的纯视觉 + MLLM 范式有望推动以下方向:
从增长曲线看,空中 VLN 领域正处于快速起步阶段,VoLN-UAV 率先建立了基准,有望成为该方向的里程碑工作。
项目链接: GitHub - Admire-ljb/VoLN-UAV
论文: arXiv:2607.21400
导航数据集: HuggingFace - Louj/VoLN-UAV-dataset
仿真环境: HuggingFace - Louj/VoLN-UAV-ENV
许可证: MIT
