
YOLO-World
AILab-CVC/YOLO-World加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你是一名野生动物保护专家,需要在数万小时的监控录像中定位一种珍稀鸟类。传统目标检测模型只能识别预定义的类别——比如 COCO 数据集中的 80 种物体。如果你告诉它"找一只雪豹",它会一脸茫然。
这就是传统目标检测的词表困境:模型在训练时被锁死在一个固定的类别集合里,面对开放世界中的千变万化毫无办法。
YOLO-World 正是为解决这个问题而生。它将 YOLO 系列的高速特性与开放词汇检测能力结合,让用户可以用任意文本指定要检测的目标——"雪豹"、"违章搭建的蓝色铁皮棚"、"停车场里的红色三轮车"——无需任何重新训练,模型立即"看懂"。
2024 年,这项工作被全球计算机视觉顶级会议 CVPR 2024 正式录用,来自腾讯 AI Lab 和华中科技大学的研究团队正式开源了这一成果。
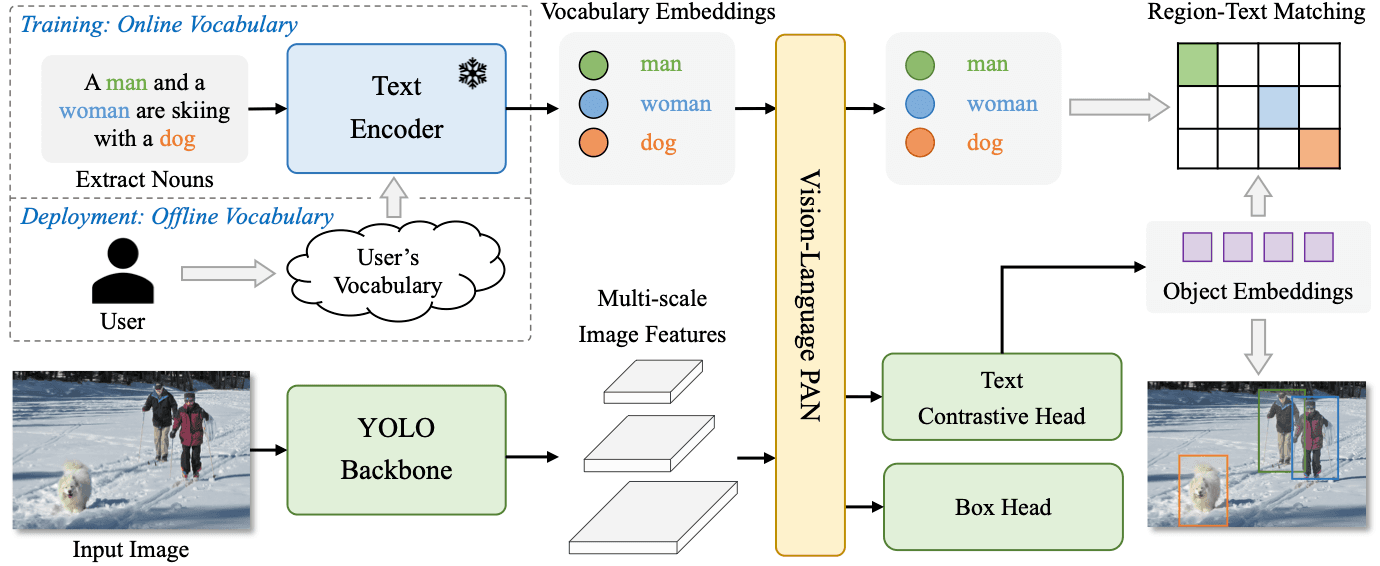
YOLO-World 的核心创新在于将语言理解能力注入目标检测模型。它采用三阶段架构:
第一阶段:文本编码。 使用 CLIP 或 Sentence-BERT 作为文本编码器,将用户输入的词汇转换为稠密的语义向量。
第二阶段:VL-PAN 跨模态融合。 视觉特征图与文本向量通过 Vision-Language PAN 模块进行跨模态交互。
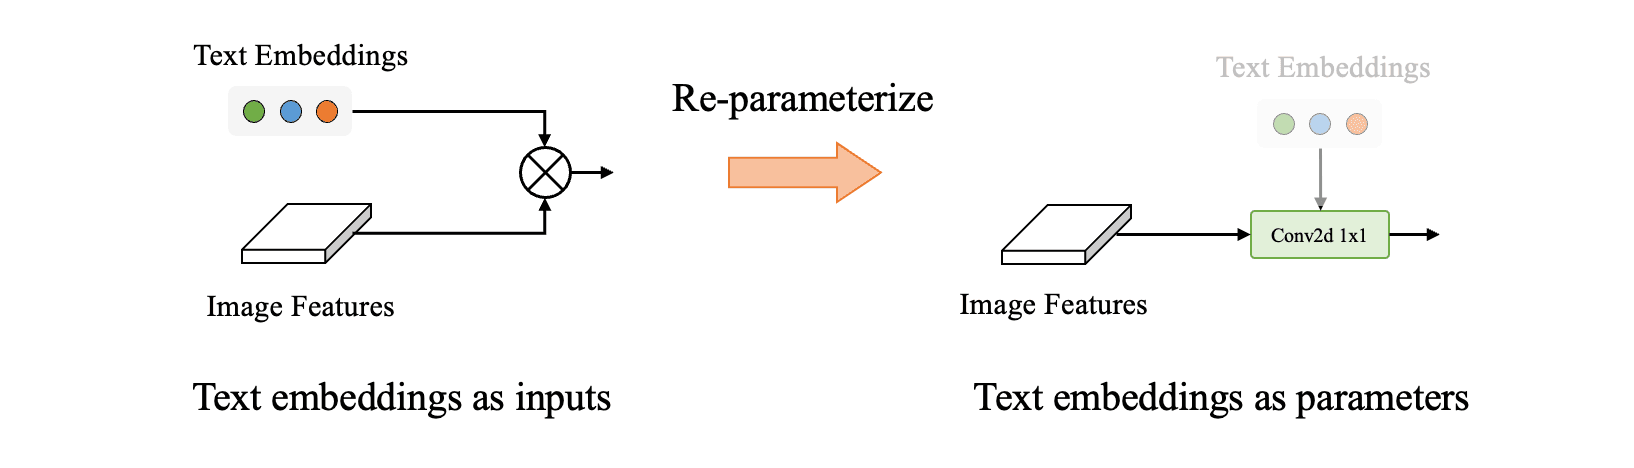
第三阶段:重参数化推理。 将文本编码器的知识合并到检测器中,无需额外加载文本编码器。
| 指标 | 数值 |
|---|---|
| 推理速度 | ~35 FPS(V100, 640×640) |
| 预训练数据 | COCO + LVIS + OpenImages |
| 支持模型规模 | S / M / L / X |
| 文本编码器 | CLIP-Base / CLIP-Large |
| 图像提示 | 支持区域图块作为检测引导 |
| 导出格式 | ONNX, TFLite INT8, PyTorch |
在某工业园区安防场景中,需要同时检测"未佩戴安全帽"、"堆放杂物"、"消防通道堵塞"等非标准类别。使用 YOLO-World,只需传入这些文本描述,无需重新训练即可部署。
自动驾驶系统需要识别数量庞大且不断变化的目标类型——各种特殊车辆、行人姿态、交通标识。
电商平台每天处理数以亿计的商品图片。YOLO-World 可以快速构建定制化的商品识别系统。
python demo/gradio_demo.py
浏览器打开 http://127.0.0.1:7860,在文本框输入要检测的词汇,上传图片即可看到检测结果。
from yolo_world import YOLOWorld
model = YOLOWorld("yolo_world_l.pt")
model.set_texts(["person", "laptop", "coffee mug"])
results = model.predict("demo.jpg")
docker build -t yolo-world .
docker run --gpus all -p 7860:7860 yolo-world
1. 依赖 mm 系列库的复杂性。 项目底层依赖 OpenMMLab 生态(mmcv、mmdet、mmengine、mmyolo),这些库版本兼容性历来是社区痛点。pip install 一行命令通常无法直接解决。Docker 方式是相对稳妥的选择。
2. GPU 显存要求不低。 最大的 L 版本模型在 640×640 输入下需要约 8GB 显存,Edge 端部署存在挑战。
3. 长尾类别检测能力有限。 对于训练数据中极少见的长尾类别,开放词汇检测能力仍会打折扣。
4. 实时性有上限。 35 FPS 是 V100 单卡实测成绩,在消费级 GPU 或 CPU 部署时帧率会明显下降。
YOLO-World 的出现代表着目标检测领域一个重要范式转变的加速:从预定义类别检测走向开放词汇感知。
此前,开放词汇检测的研究主要聚焦在精度,模型往往体积庞大、推理缓慢,难以落地。YOLO-World 证明了一个关键观点:速度和开放词汇并不对立。
项目地址:https://github.com/AILab-CVC/YOLO-World
