
VideoCrafter
AILab-CVC/VideoCrafter加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2023年10月,OpenAI发布Sora前一个月,腾讯AI Lab旗下计算机视觉研究团队(AILab-CVC)悄然在GitHub开源了一个名为VideoCrafter的项目。这是一个支持文本生成视频(Text-to-Video)和图像生成视频(Image-to-Video)的扩散模型工具箱,2024年1月升级为VideoCrafter2,论文被CVPR 2024接收。在Sora引发全民AI视频热潮之前,这个来自中国顶尖研究机构的项目已经在开源社区积累了超过5000颗星,成为视频生成领域最受欢迎的开源方案之一。
视频生成被称为"AI皇冠上的明珠",技术门槛远高于图像生成。一段10秒的24fps视频包含240帧画面,不仅要求每帧画面质量高,更要求物体运动轨迹合理、光影变化连贯、时间维度稳定。传统GAN(生成对抗网络)方法在这一任务上举步维艰,直到扩散模型(Diffusion Model)在图像领域取得突破,研究者们才开始将类似思路迁移到视频。
VideoCrafter的核心团队来自腾讯AI Lab CVPR实验室,他们面临的挑战是:高质量视频数据极其稀缺,大多数开源项目的训练数据规模和质量都远不如商业闭源方案。VideoCrafter2的核心创新正是"克服数据局限"——通过课程学习(Curriculum Learning)和数据增强策略,在有限数据下训练出质量可与更大数据集模型比肩的视频生成系统。
VideoCrafter提供了完整的视频生成管线,核心功能分为三大模块:
文生视频(T2V):用户输入一段文字描述,模型输出对应视频。示例效果包括"Tom Cruise脸上写满专注"(图1)、"孩子在锈迹斑斑的秋千上欢笑"(图2)、"Van Gogh风格情侣湖边起舞"(图3)。支持16fps-32fps可调帧率,CFG Scale 1.0-30.0采样控制,1-60步迭代采样。
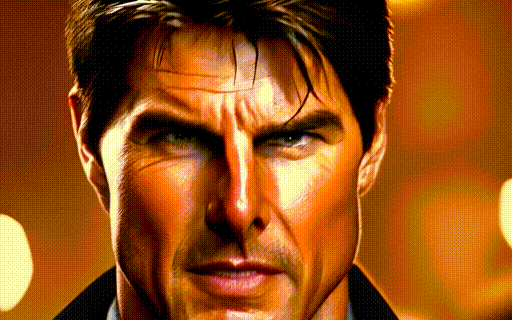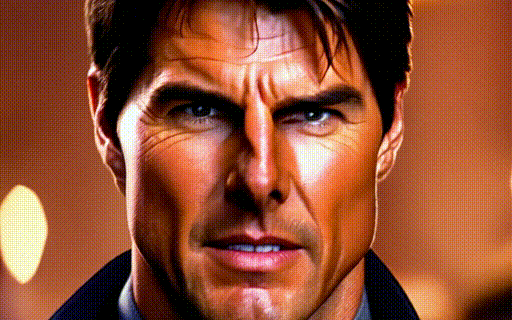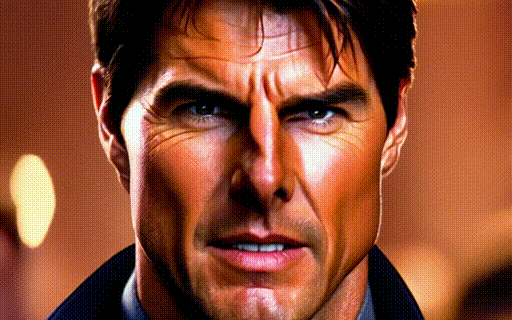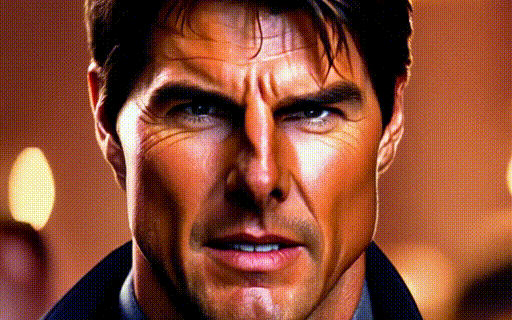 图1:Text-to-Video生成效果——"Tom Cruise's face reflects focus, his eyes filled with purpose and drive."
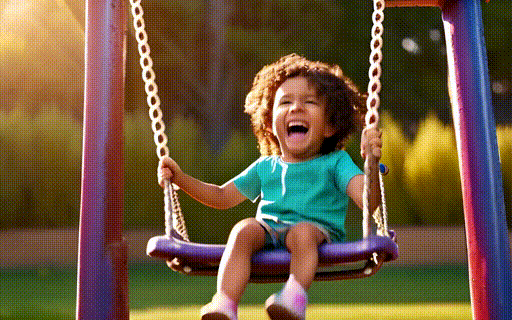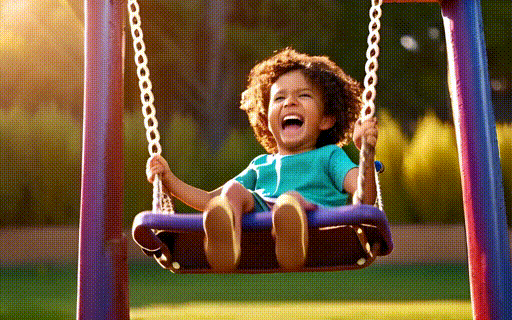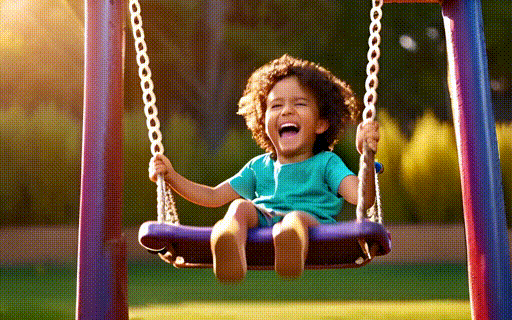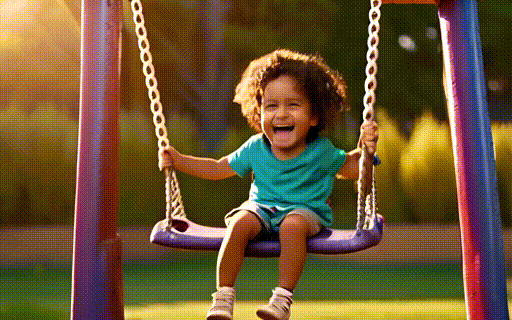 图2:Text-to-Video生成效果——"A child excitedly swings on a rusty swing set, laughter filling the air."
图生视频(I2V):上传一张静态图片,生成连贯的视频动画。例如输入一张黑天鹅图片,模型能生成天鹅在池塘中游动的视频;输入一张骑马照片,生成骑马场景的动态画面。这一功能对于动态化老照片、让静态艺术作品"活起来"特别有价值。
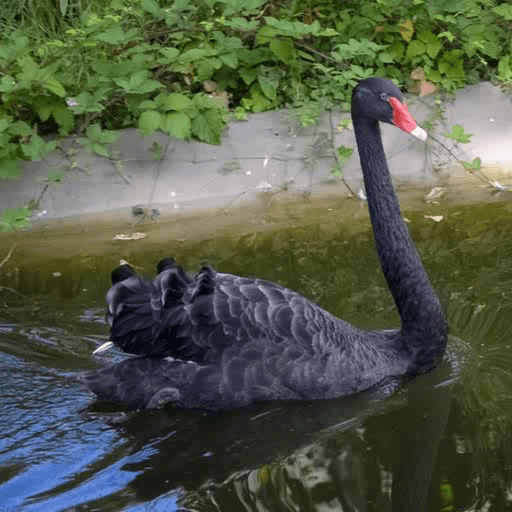 图3:Image-to-Video输入——黑天鹅静态图(上)与生成效果(下)
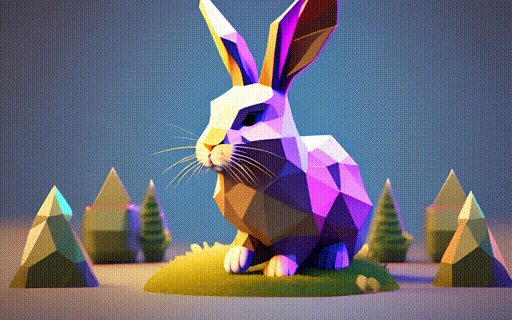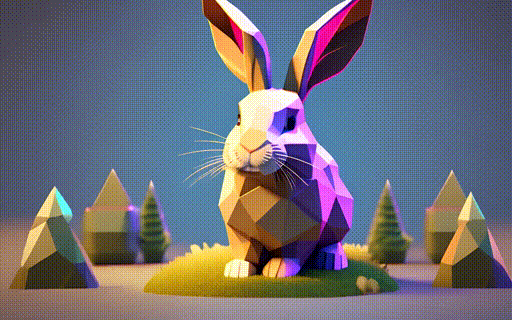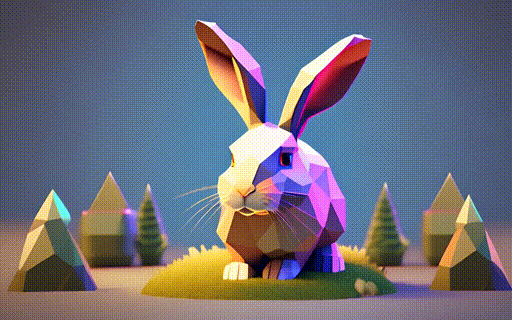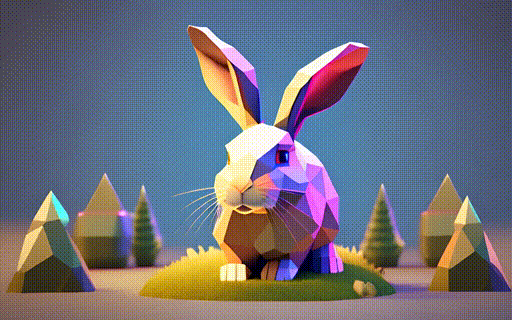 图4:多风格视频生成——"A rabbit, low-poly game art style"低多边形游戏风格
视频微调与增强:除了基础生成,VideoCrafter还支持LoRA轻量微调,用户可以用自己的数据集定制风格,以及视频超分(Video Super-Resolution)和补帧(Frame Interpolation)增强工具。
从代码结构看,VideoCrafter基于PyTorch + PyTorch Lightning构建,核心依赖包括:
核心模型架构位于lvdm/目录,包含:
lvdm/models/ddpm3d.py:3D扩散模型(DDPM)核心实现lvdm/modules/attention.py:自注意力与交叉注意力模块lvdm/modules/encoders/:视频编码器(基于CLIP和T5)lvdm/models/autoencoder.py:潜空间视频自编码器模型权重托管在HuggingFace,提供T2V 512x320、T2V 1024x576、I2V 512x512等多个分辨率checkpoint,其中VideoCrafter2主模型约5.8GB。
对于不想折腾代码的用户,VideoCrafter提供了Gradio Web界面。安装依赖后运行python gradio_app.py,即可在浏览器中通过图形界面操作——输入提示词、调节步数/帧率/CFG等参数、实时预览生成结果。这比直接调用Python API门槛低很多,适合快速验证想法。
更进阶的用户可以通过scipts/run_text2video.sh或scipts/run_image2video.sh脚本批量推理。predict.py则提供了Cog标准化预测接口,可直接部署到Replicate等推理平台。
VideoCrafter并非完美无缺。物理规律理解有限——模型有时生成违反物理的视频(如物体凭空出现、液体行为异常),这是所有视频生成模型的共同痛点。长视频生成质量下降——受限于扩散模型的去噪步数,超过16-32帧后视频连贯性明显下滑。计算资源门槛高——最低需要16GB显存的GPU(RTX 3090或更高),无GPU无法运行。
此外,VideoCrafter2在数据局限上虽已做出改进,但与Runway Gen-2/Pika、Sora等闭源商业方案相比,在生成视频时长、运动平滑度、提示词跟随能力上仍有差距。
VideoCrafter的意义不仅在于工具本身,更在于它构建了一个完整的开源视频生成生态:从模型训练代码、推理管线、微调工具到Gradio界面,研究者和开发者可以在这个框架上做二次开发。DynamiCrafter(高分辨率I2V专用模型)就是基于VideoCrafter衍生的成功案例。
目前VideoCrafter在GitHub已有5090颗星、411个Fork、74个Open Issue,社区活跃度在视频生成开源项目中名列前茅。配合HuggingFace Spaces的在线Demo和Discord社区,它已经成为AI视频生成领域最重要的开源基础设施之一。
适合谁用:AI视频研究者(做实验、发论文)、AI创作者(生成短视频素材)、开发者(集成到自己的产品管线)。不适合:纯小白用户(需要GPU+技术基础)、需要超长高连贯视频的场景。
