
Multi-Agents-System-from-Scratch
AIAnytime/Multi-Agents-System-from-Scratch加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
凌晨两点,某医院信息科工程师小林收到了一个新需求——科室积累了近五年的病历文本,需要提取关键信息用于科研分析。传统方案要么买商用NLP平台(年费数十万),要么自建模型(需要GPU集群+三个月训练周期)。
小林打开浏览器,指向了一个 GitHub 仓库——AIAnytime/Multi-Agents-System-from-Scratch,stars 72,fork 32,MIT 许可证。点开 Streamlit 界面,输入一段病历文本,GPT-4o 驱动的摘要智能体在 30 秒内返回了结构化摘要,紧接着一个验证智能体自动检核了结果质量。三小时后,五年病历数据全部处理完毕。
这不是论文里的 Demo,而是这个开源项目的真实使用场景。
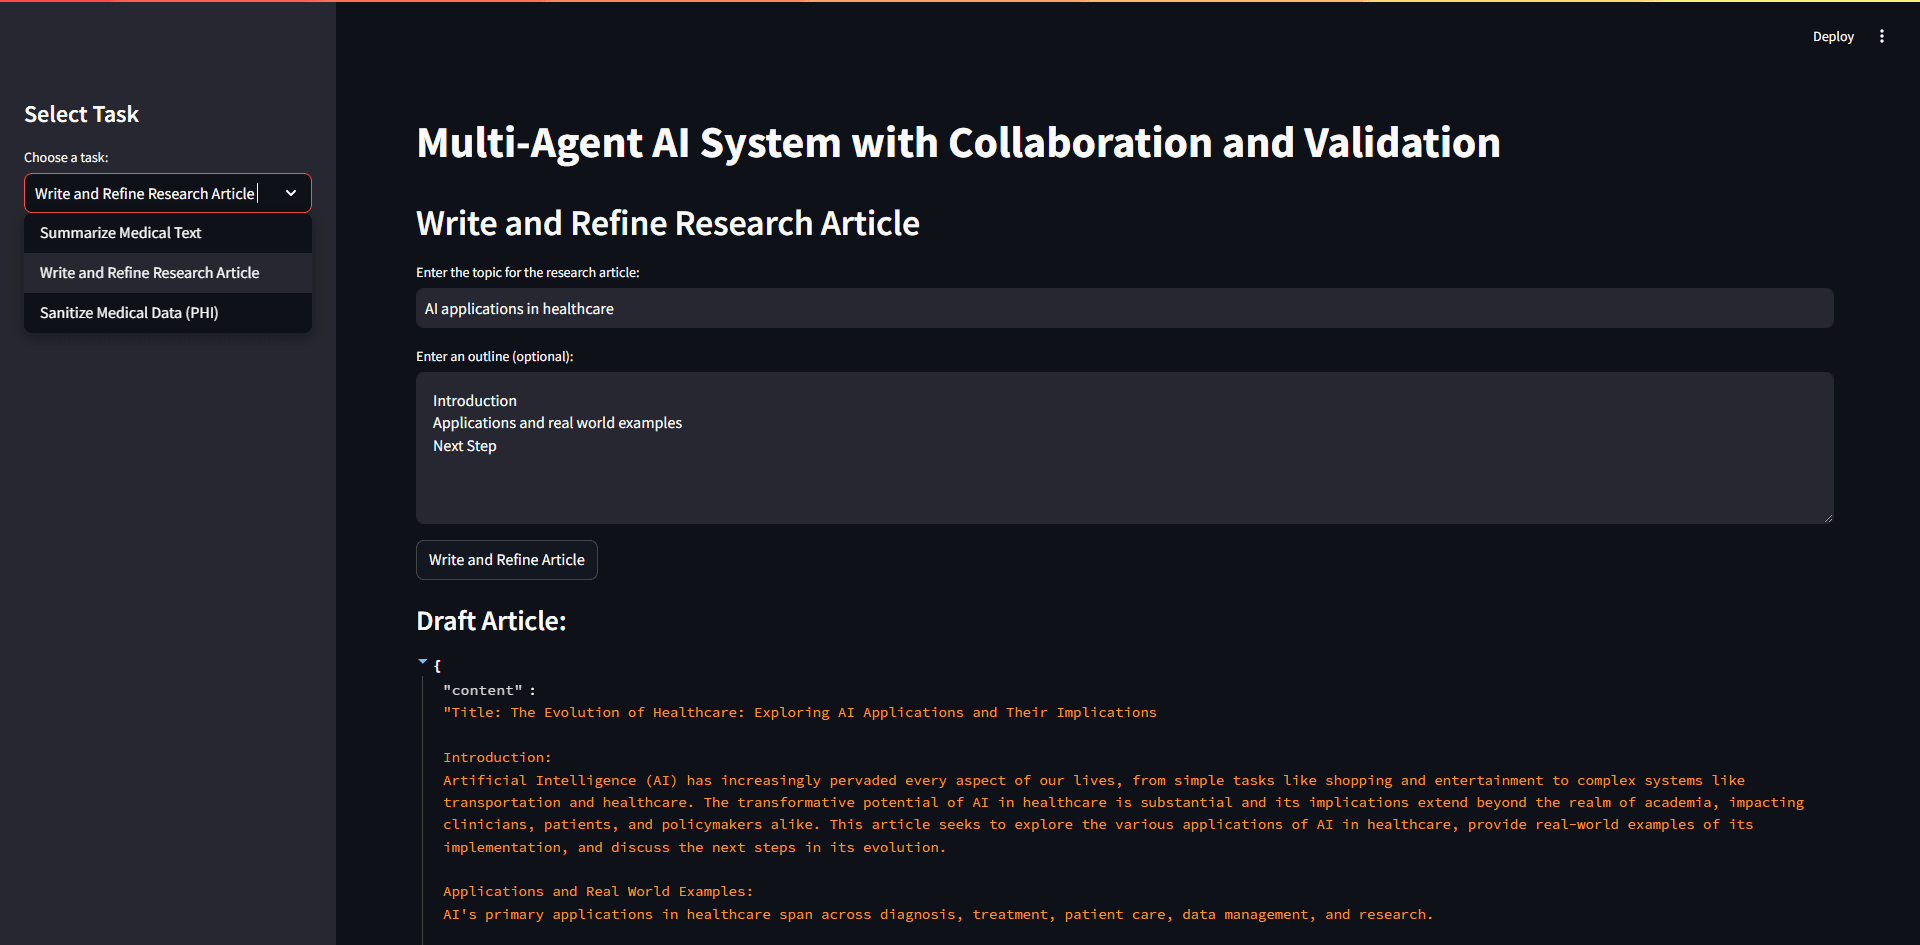
当前 AI Agent 开发领域存在一个隐性门槛:几乎所有主流教程都用 CrewAI、AutoGen、LangGraph 等框架来演示多智能体协作。这些框架当然优秀,但它们屏蔽了底层逻辑——学员学完之后,依然不知道 Agent 到底是怎么"思考"的。
AIAnytime 频道的作者正是看到了这个问题:这个项目从零手写了一个完整的多智能体系统,零框架依赖,仅用 Python 标准库 + OpenAI SDK + Streamlit,完整复现了:
AgentBase)项目的核心价值不是做医疗文本处理,而是用最少的代码量揭示多智能体系统的核心设计模式,让学习者真正理解 Agent 之间的协作逻辑。
项目采用经典的三层架构,从上到下依次是:
┌──────────────────────────────────────────────┐
│        Streamlit Web 界面(用户交互层)         │
├──────────────────────────────────────────────┤
│            AgentManager(任务调度层)           │
│  负责根据任务类型分发到对应的主 Agent 和验证 Agent │
├──────────────────────────────────────────────┤
│         AgentBase 抽象基类(智能体执行层)        │
│   统一处理 OpenAI API 调用、重试机制、日志记录    │
└──────────────────────────────────────────────┘
主 Agent(3个):
SummarizeTool:接收原始医疗文本,调用 GPT-4o 生成摘要WriteArticleTool:根据主题和可选提纲,生成研究论文草稿SanitizeDataTool:识别并移除病历中的 PHI(受保护健康信息)验证 Agent(4个):
SummarizeValidatorAgent:检核摘要的准确性和完整性WriteArticleValidatorAgent:验证论文的学术规范RefinerAgent:对论文草稿进行润色优化SanitizeDataValidatorAgent:确认 PHI 数据已被彻底清除关键设计在于验证 Agent 的引入——每次主 Agent 输出结果后,对应的验证 Agent 会进行质量评估,如果未达标则可触发重试。这模拟了真实工作流中"执行→审查→修正"的闭环。
项目代码量极小(agents 目录全部 8 个文件),但每一行都有明确职责。
AgentBase 抽象基类是整个系统的骨架,定义了所有 Agent 必须实现的 execute 接口和统一的 call_openai 方法。重试逻辑(默认 2 次)、日志记录、超时控制全部在基类中实现,子类只需定义业务 prompt。
class AgentBase(ABC):
    def __init__(self, name, max_retries=2, verbose=True):
        self.name = name
        self.max_retries = max_retries
        self.verbose = verbose

    @abstractmethod
    def execute(self, *args, **kwargs):
        pass

    def call_openai(self, messages, temperature=0.7, max_tokens=150):
        # 重试逻辑 + 日志 + API 调用,统一在此处理
日志系统使用 Loguru 实现,写入 logs/multi_agent_system.log,按 1MB 轮转,保留 10 天。这在生产环境中对于追溯 Agent 行为链至关重要。
Web 界面通过 Streamlit 的 selectbox 切换三个任务场景,每个场景串联主 Agent → 验证 Agent 两级调用,结果实时展示。
项目没有任何容器化支持,也没有 Docker 支持。这既是局限也是特色——正因为不需要 Docker,任何有 Python 基础的开发者都可以在 5 分钟内启动运行。
git clone https://github.com/AIAnytime/Multi-Agents-System-from-Scratch.git
cd Multi-Agents-System-from-Scratch
python3 -m venv venv && source venv/bin/activate
pip install -r requirements.txt
export OPENAI_API_KEY=sk-xxx
streamlit run app.py
# 浏览器打开 http://localhost:8501
依赖仅有 5 个包:openai、streamlit、pandas、loguru、python-dotenv,没有深度学习框架,没有 GPU 要求。硬件需求极低,普通笔记本即可运行。
项目坦诚列出了几个明显局限:
此外,多智能体之间的"协作策略"(如谁先执行、如何共享上下文)完全由代码硬编码,缺乏灵活性。
2024 年是多智能体框架爆发的一年——CrewAI、AutoGen、Swarm 相继出现,框架越来越强大,但也越来越像一个黑盒。这个项目反其道而行之,用最原始的方式揭示了多智能体协作的本质:接收任务→调用 LLM→返回结果→验证质量。
它的价值不在于替代任何框架,而在于帮助开发者真正理解框架为什么这样设计。当你在 CrewAI 中配置一个 Task 和 Agent 时,底层发生的正是这个项目所展示的逻辑。
从行业趋势看,无框架的多智能体系统正在成为 AI Native 应用的新方向——直接用 LLM API 构建轻量协作链,减少抽象层带来的额外消耗。这个项目正是这一趋势的一个优秀教学范例。
