Awesome-Model-Quantization
AI-Efficiency/Awesome-Model-Quantization加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下: 你训练出了一个精度惊人的大模型,却在部署时傻了眼——模型文件 100GB,服务器显存必须 200GB 才能跑得动,发给用户更是天方夜谭。怎么办?
模型量化,就是来解决这个问题的。它的工作原理很直观:把神经网络中原本用 32 位浮点数(FP32)存储的权重参数,压缩成 8 位、4 位甚至 1 位的整数来表示。体积缩小 2~8 倍,显存占用大幅下降,推理速度也能显著提升。当然,天下没有免费的午餐——精度损失是必须付出的代价,而如何把这个代价压到最小,就是整个领域最核心的研究课题。
Awesome Model Quantization(AMQ)就是这一领域的"全景地图"。它由 AI-Efficiency 团队维护,持续追踪模型量化领域的最新进展,涵盖从二进制网络到多模态大模型的各类技术路线。
模型量化的研究最早可以追溯到 2010 年代初期,主要针对卷积神经网络(CNN)推理加速。当时的研究者发现,许多 CNN 在训练完成后,权重分布相对集中,动态范围不大,完全可以用低位宽整数来近似表示。
早期的经典工作包括:
这些工作奠定了"用低位宽换速度"的核心理念。但彼时的大模型尚未登场,量化主要服务于移动端和嵌入式场景。
2017 年之后,随着 Transformer 架构崛起,大语言模型参数量从亿级跃升至千亿乃至万亿级别,显存瓶颈急剧凸显。BERT(2018)参数量 3.4 亿,GPT-3(2020)达到了 1750 亿——光是加载模型就需要 350GB 显存。模型量化由此从"锦上添花"变成了"刚需",整个领域迎来了爆发式增长。
AMQ 项目正是在这一背景下建立,持续收录从 PTQ 到 QAT、从标量量化到矢量量化、从视觉模型到 LLM 的全谱系文献。
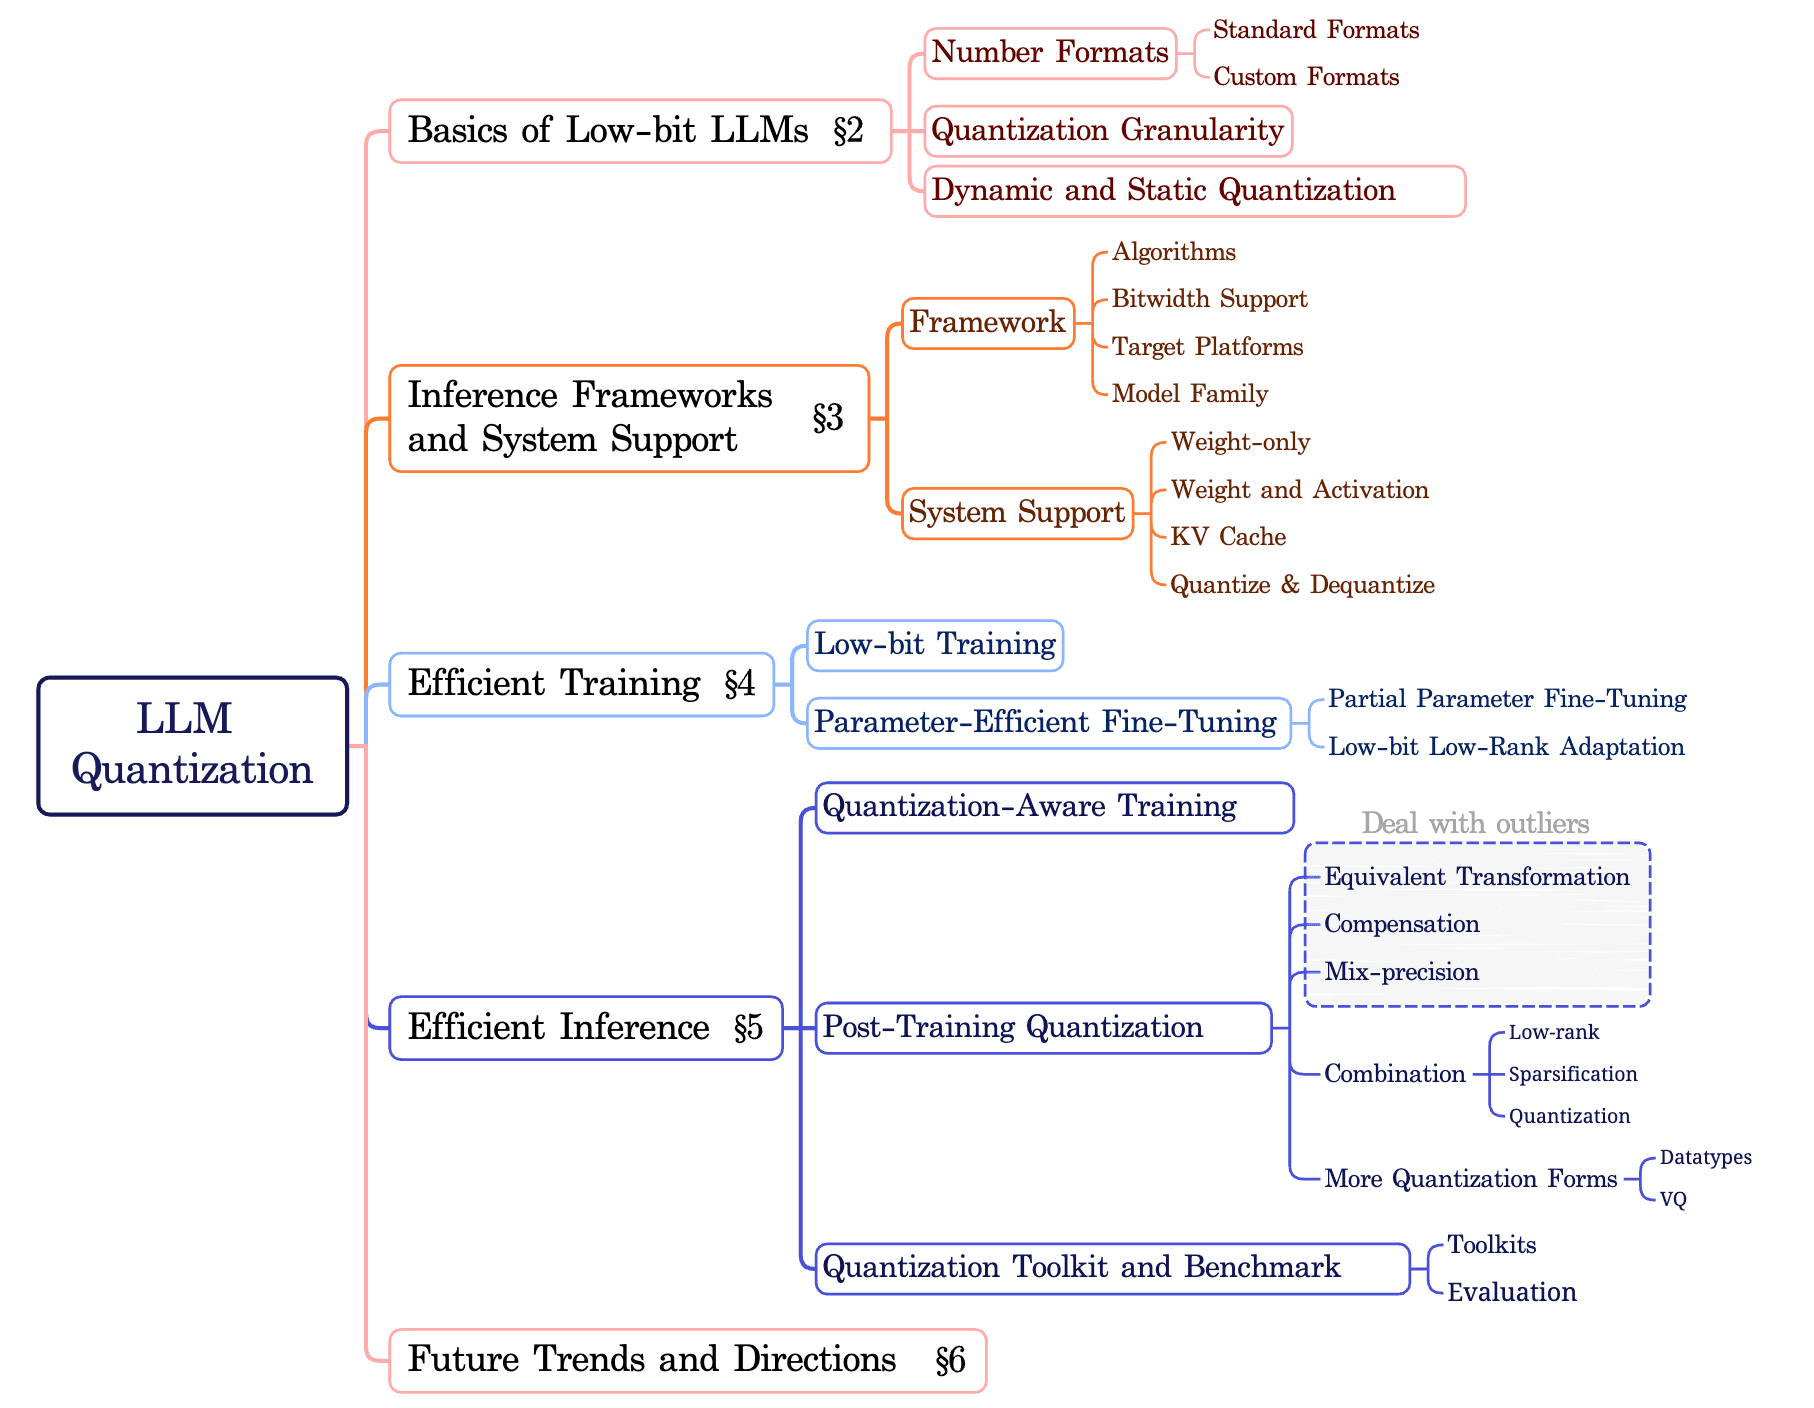
AMQ 对现有方法按优化范式分成了几个主要类别,理解它们是理解整个领域的第一步。
PTQ(Post-Training Quantization)是最常用的方式——模型先训练好,再用一小批校准数据(calibration data)统计权重分布,直接量化。不重新训练,对算力要求极低,上手门槛不高。
GPTQ(2023)是 LLM PTQ 的里程碑。它利用二阶 Hessian 信息逐层量化权重,在 4-bit 量化下仍能保持接近原模型的精度。发布时成功将 1750 亿参数的 GPT 模型压缩到约 80GB,让单卡 A100 有了运行的可能。
AWQ(2024,字节跳动)在此基础上做了改进:不把所有权重一视同仁地量化,而是根据激活值的敏感度为不同通道分配不同的缩放系数(activation-aware weight quantization)。在 4-bit 下效果优于 GPTQ,且速度更快。
SmoothQuant(2022)走了一条更聪明的路:既然异常激活值(outlier)阻碍了量化,就通过数学变换把激活的难度"转移"给权重,两边都变得"友好",最终实现 W8A8(权重和激活都是 int8)的极限压缩。
QAT(Quantization-Aware Training)则在训练过程中就引入量化操作,让模型"提前适应"低位宽表示。精度通常比 PTQ 更好,但需要额外的训练资源和时间。
LSQ(Learned Step Size Quantization,ICLR 2020)让量化步长本身变成可学习的参数,由梯度自动调整。PACT(PArameterized Clipping Activation,ICLR 2019)则解决了 ReLU 等激活函数的裁剪边界问题。
在 LLM 时代,QAT 的代表是 QLoRA(2023)。它将 LoRA 微调和 4-bit 量化结合,在单张 48GB 显存的 A100 上微调 65B 参数的模型,开创了"小资源微调大模型"的范式。
最极端的路线是完全不需要原始训练数据,利用模型自身的统计特性做量化。ZeroQ(CVPR 2020)通过合成校准样本,Qimera 尝试在无数据条件下恢复精度,难度最高但也最有研究价值。
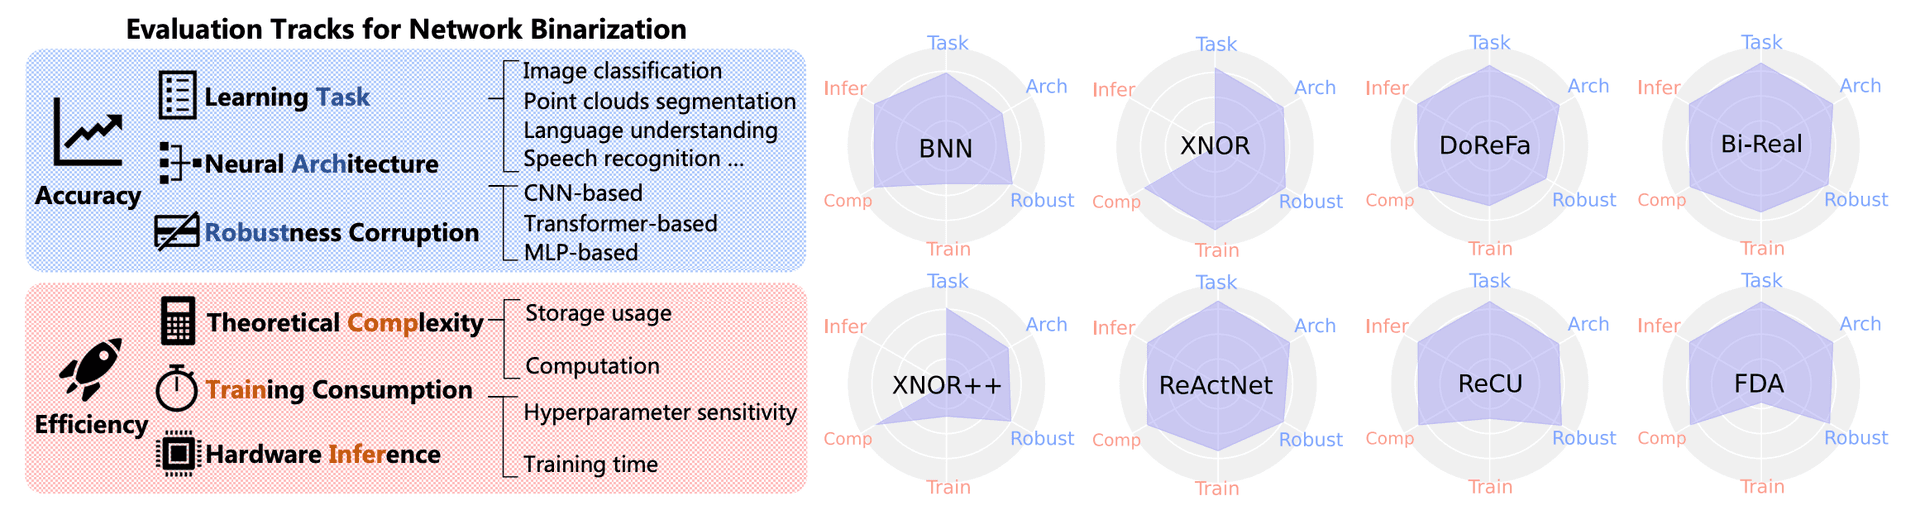
AMQ 给出了更系统的分类框架,按五个维度拆解量化技术:
优化范式:PTQ / QAT / 量化微调(PEFT)/ 免数据量化 / 低精度训练。
表示方式:标量量化(非均匀/对数量化/浮点量化)、矢量量化(codebook)、格量化(Lattice)、二值/三值量化、混合精度量化。
误差处理:旋转(Rotation)、异常值平滑、残差重建、误差补偿、敏感性感知方法。
量化对象:权重、激活值、KV 缓存、梯度、训练状态、通信数据。
模型类型:视觉模型(CNN/ViT)、语言模型(LLM)、多模态模型、扩散模型、状态空间模型(SSM/Mamba)。
这种多维分类对于研究者来说非常实用——当你对某个具体问题(比如"KV 缓存的 INT4 量化")感兴趣时,可以快速定位到相关文献,而不必在海量论文中盲目搜索。
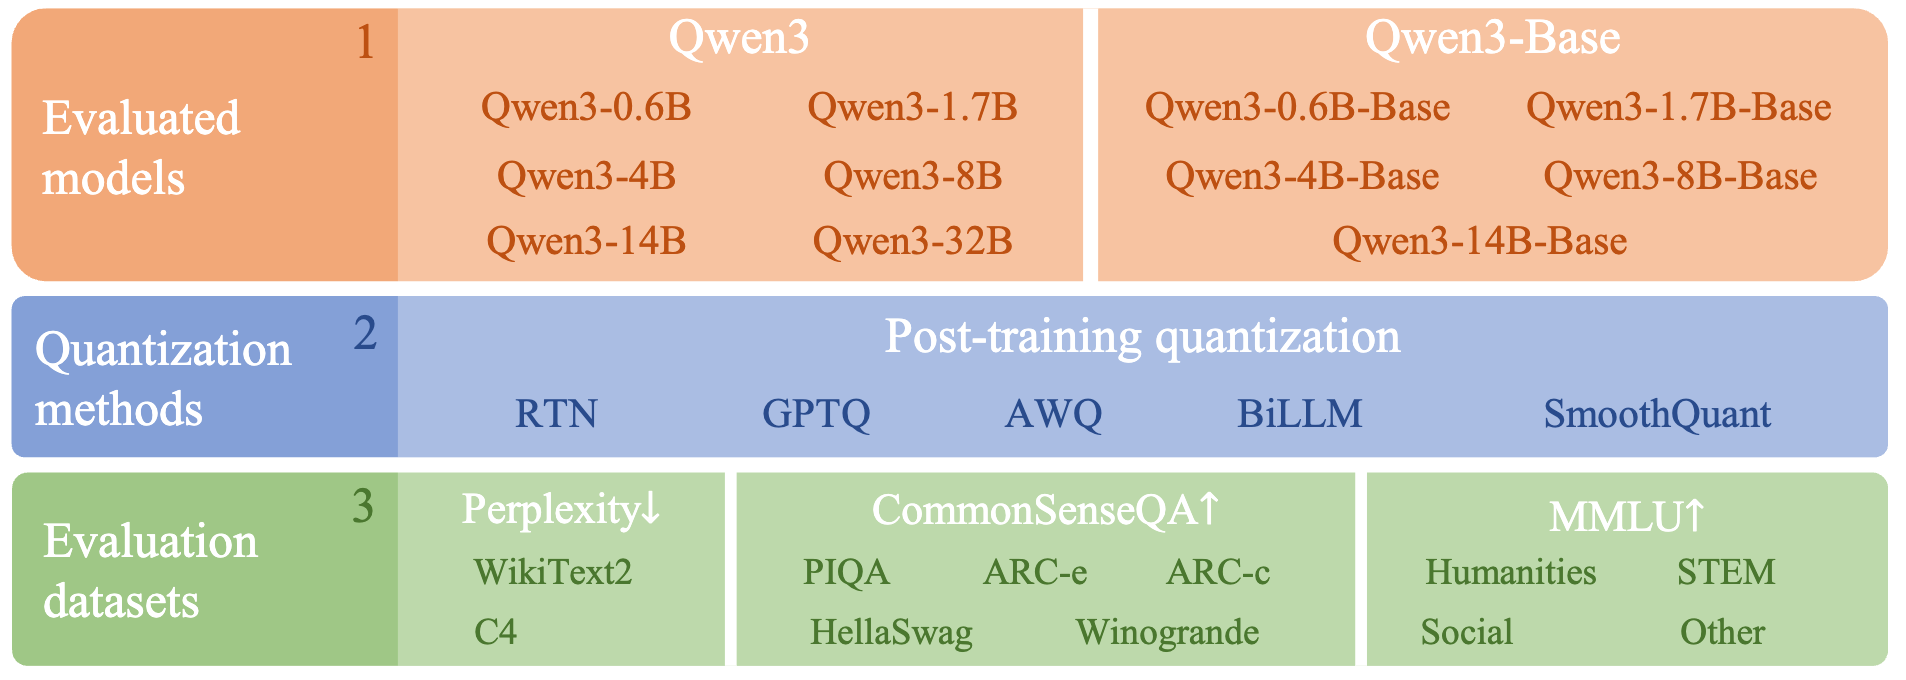
对于普通开发者,AMQ 最大的价值在于提供了可直接使用的开源实现库列表。
主流工具包括:
| 工具 | 特点 | 适用场景 |
|---|---|---|
| bitsandbytes | 最流行的 8/4-bit 量化库,与 Transformers 无缝集成 | LLM 推理与微调 |
| GPTQ | 基于 CUDA 的 GPTQ 实现,高效批量量化 | 离线量化大批量模型 |
| AWQ | activation-aware 量化,精度更高 | 对精度敏感的推理 |
| GGUF(llama.cpp) | 专为 CPU 推理优化,支持多种量化方案 | 消费级硬件部署 |
| TensorRT-LLM | NVIDIA 官方 LLM 推理引擎 | 生产级部署 |
| vLLM | 高吞吐量推理框架,支持多种量化格式 | 批量推理服务 |
举个例子,用 Hugging Face Transformers 加载一个 4-bit 量化模型只需要几行代码:
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
quantization_config = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype="float16")
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b", quantization_config=quantization_config)
整个过程不需要了解量化的底层数学原理,门槛已经降到了普通工程师可以接受的程度。
随着 LLM 参数量级不断攀升,一些新问题浮现出来:
异常激活值:LLM 中的某些激活通道数值异常大(outlier),比如 100 倍于均值。这种"刺"使得低精度表示非常困难。SmoothQuant 和 QuaRot(2024)都试图从数学上解决这个矛盾。
旋转不变性:SpQR(2023)和 QuaRot(2024)通过引入随机旋转,让权重分布更加均匀,从根本上改善量化质量。SpinQuant 进一步用学习到的旋转矩阵替代随机旋转,效果更佳。
极端低位宽:AQLM(Additive Quantization Language Model)将 2-bit 量化做到了极致,用加性码本(additive codebook)表示权重,在极低比特率下仍保持相对合理的精度。
KV 缓存量化:长上下文场景下,KV 缓存占用大量显存。KIVI(TNNLS 2024)等工作专门针对这一瓶颈做优化,对注意力机制的键值缓存做独立量化。
模型量化不是一项独立的技术,它是连接"模型训练"和"模型部署"的桥梁。从 GPT-4 到 Mistral,从 GPTQ 到 AWQ,每一次量化技术的突破,都意味着更多模型可以被更广泛地部署。
AMQ 的价值正在于此:它不只是一个论文列表,更是一张浓缩了行业演进脉络的"知识地图"。无论你是想了解某个具体方法的历史渊源,还是希望快速找到适合自己场景的工具链,AMQ 都能提供方向。
从趋势看,混合精度量化(不同层不同精度)和端到端量化(训练时就考虑部署精度约束)正在成为新的研究热点。AMQ 也持续收录这一方向的新工作,保持对前沿的追踪。
模型量化告诉我们一个朴素的道理:精度不是越高越好,合适才是。在特定的硬件和延迟约束下,用更少的比特表示模型,是工程和科学的双重智慧。
如果你对模型压缩、推理优化、边缘部署感兴趣,AMQ 是目前最值得收藏的起点——它不是最深的,但它是最全的。